
Multi-tenant en Spring Boot: base de datos, esquema o columna tenant_id con Hibernate
Todo SaaS llega al mismo punto: el segundo cliente. Con uno solo, la base de datos es suya y nadie se pregunta de quién es cada fila. Con cincuenta, cada consulta tiene que responder a una pregunta que antes no existía: ¿para qué empresa estoy trabajando ahora mismo? Montar una aplicación multi-tenant en Spring Boot consiste en responder esa pregunta en un único sitio, de forma que ningún desarrollador tenga que acordarse de añadir WHERE empresa_id = ? en cada repositorio, porque el día que alguien lo olvide, un cliente verá las facturas de otro.
La parte conceptual cabe en un párrafo: hay tres formas de aislar los datos y cada una cambia el coste, la seguridad y la operación. Lo difícil está en los detalles que casi ningún tutorial cubre: de dónde sacar el tenant sin que el cliente pueda falsificarlo, cómo evitar que una conexión del pool arrastre el esquema de otro cliente, cómo migrar doscientos esquemas con Flyway sin dejar la mitad a medias, o qué pasa con el tenant cuando el trabajo salta a un hilo @Async. En esta guía implementamos las tres estrategias con Spring Boot 4 y Hibernate 7, tomamos el tenant del JWT de Keycloak, añadimos Row Level Security de PostgreSQL como red de seguridad y lo probamos todo con Testcontainers.
¿Qué es multi-tenant?
Multi-tenant (multitenencia) es una arquitectura en la que una sola instancia de la aplicación sirve a varios clientes, llamados tenants, manteniendo sus datos aislados entre sí. Cada tenant percibe el sistema como propio, pero el código, el despliegue y normalmente la infraestructura son compartidos, lo que reduce el coste por cliente.
Lo contrario es single-tenant: una instalación completa (aplicación y base de datos) por cliente. Es el modelo más simple de razonar y el más caro de operar: cincuenta clientes son cincuenta despliegues que actualizar, monitorizar y pagar. Entre ambos extremos, la decisión que de verdad importa en una aplicación multi-tenant es dónde se separan los datos.
Las tres estrategias multi-tenant: base de datos, esquema o columna
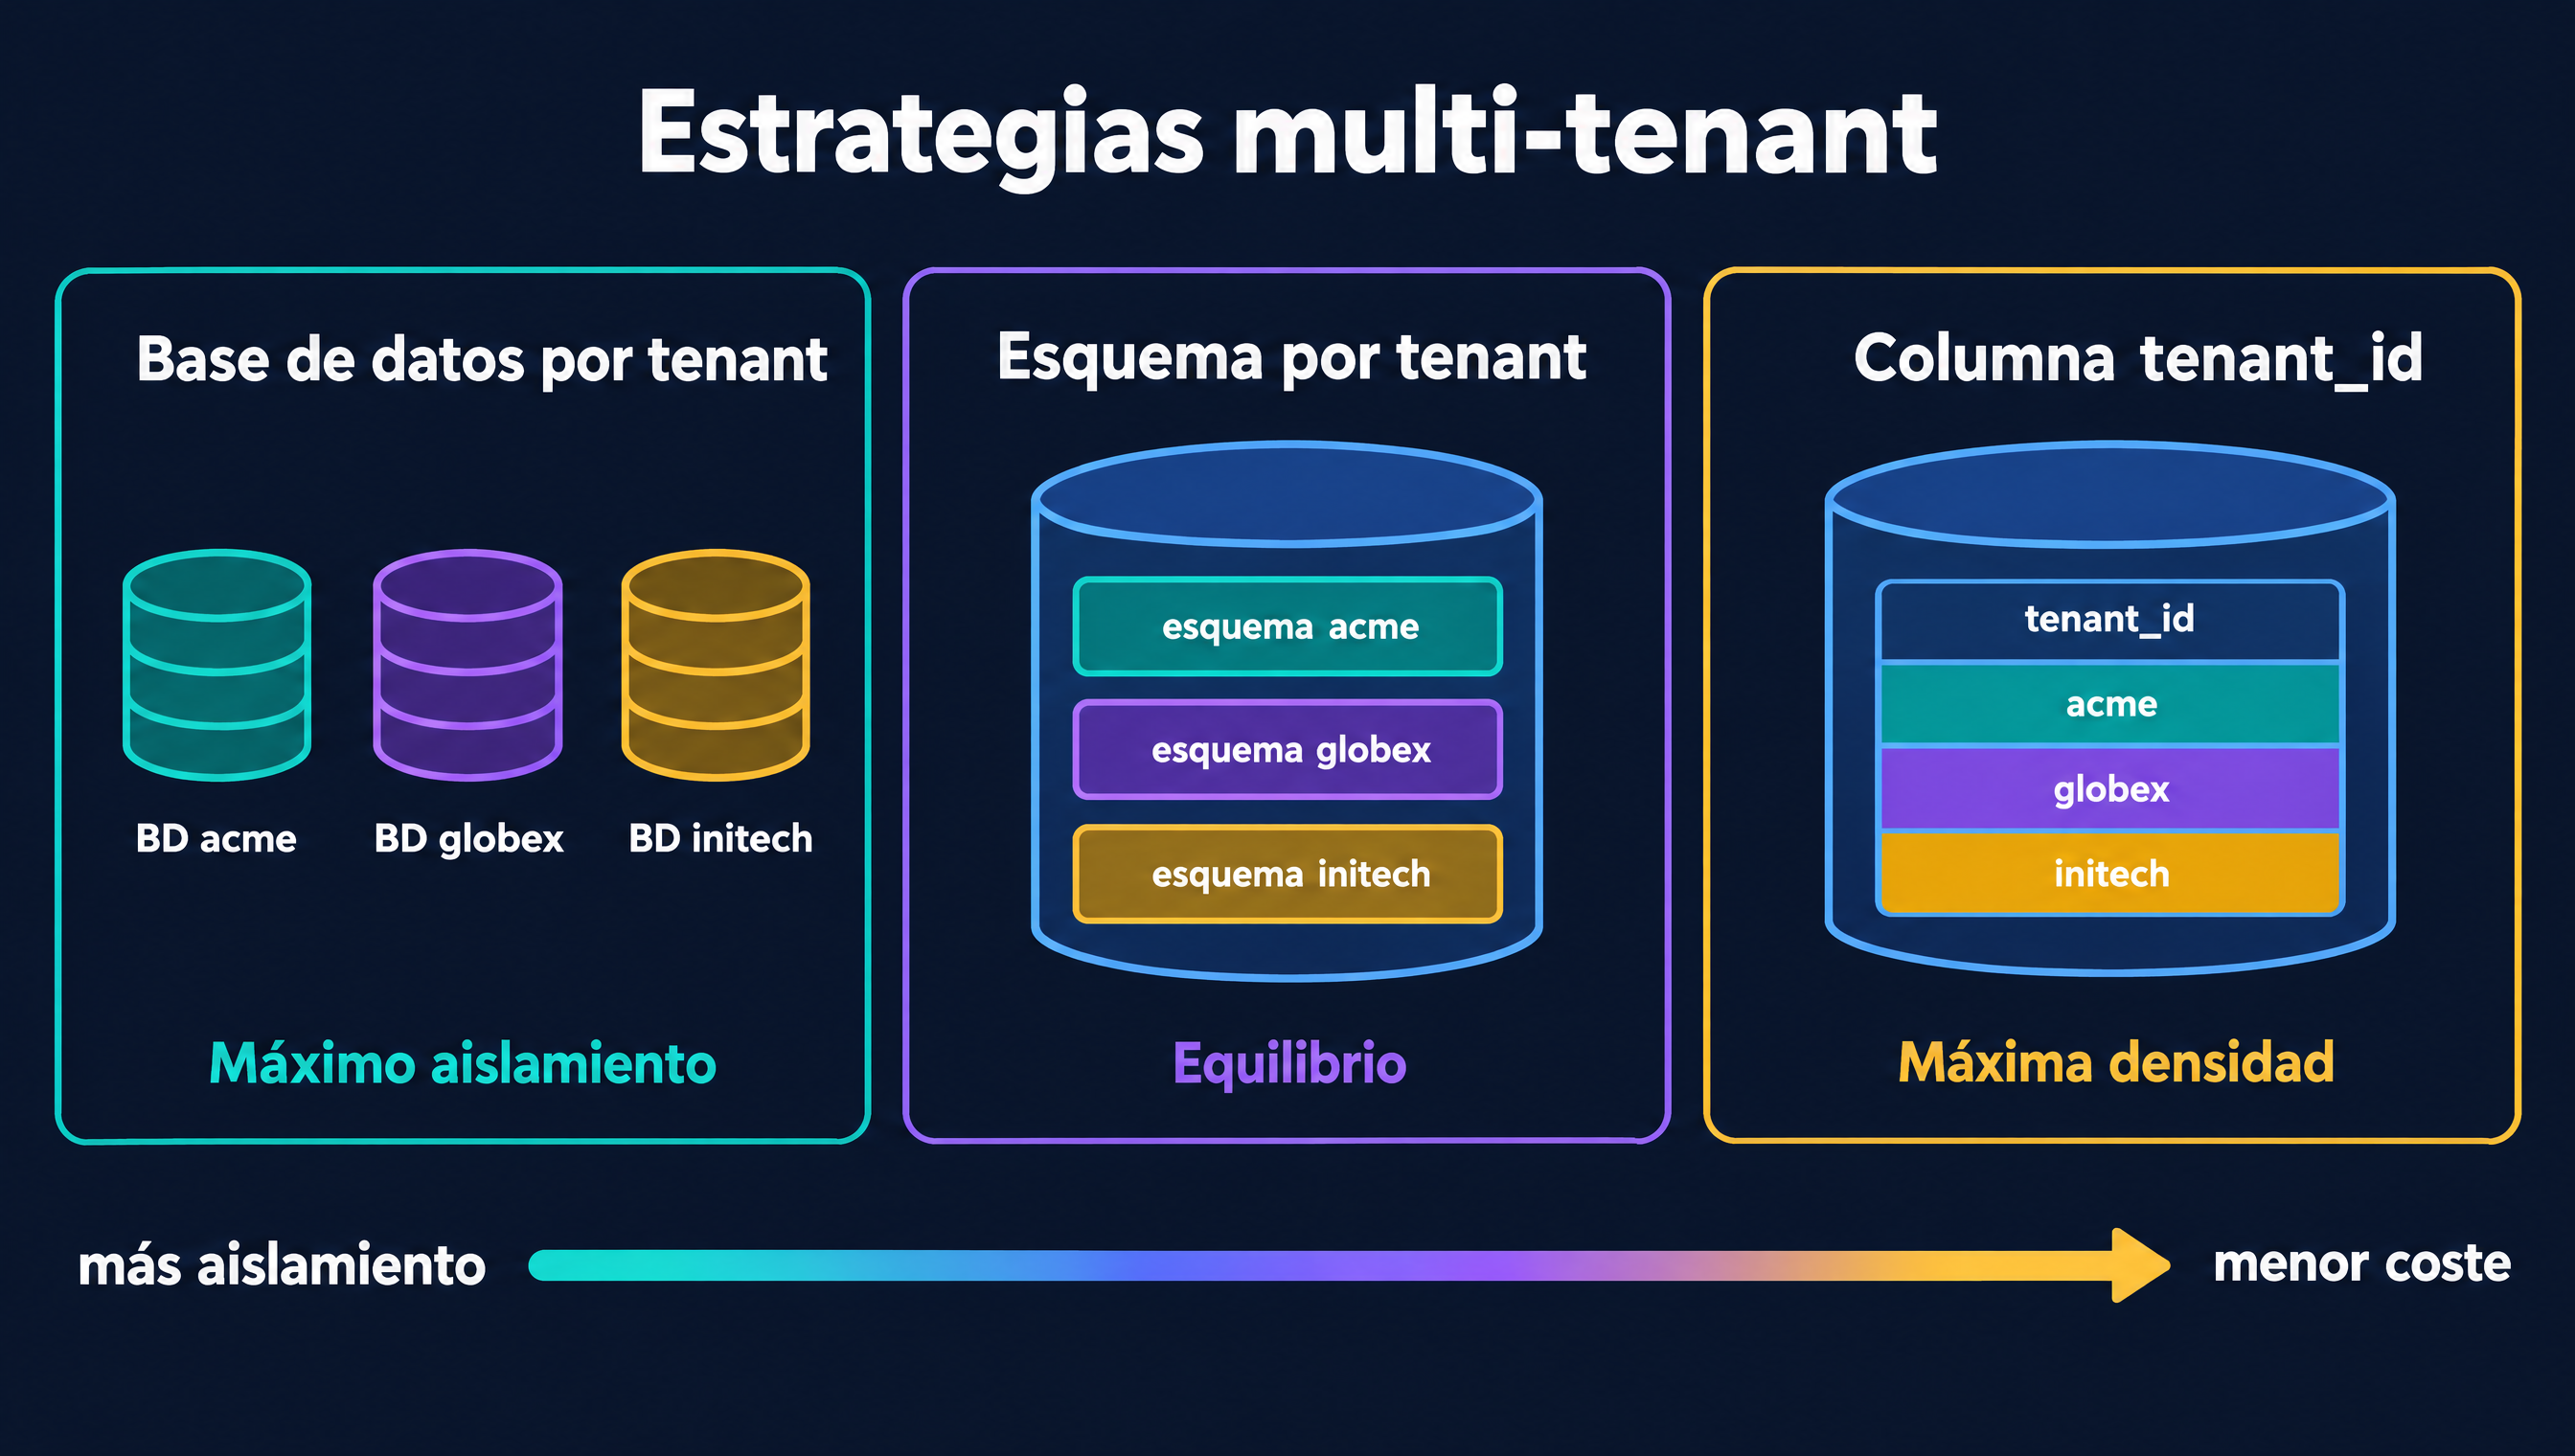
Base de datos por tenant. Cada cliente tiene su propia base de datos, incluso su propio servidor. Es el aislamiento más fuerte: un backup, una restauración o un borrado por RGPD afectan a un solo cliente, y un tenant ruidoso no degrada a los demás. El precio es operativo: un pool de conexiones por base de datos, migraciones multiplicadas y un coste fijo por cliente que hace inviable el plan gratuito.
Esquema por tenant. Una sola base de datos PostgreSQL con un esquema (acme, globex…) por cliente, todos con las mismas tablas. Comparten servidor y pool, pero los datos están en tablas físicamente distintas. Exportar o borrar un cliente es un pg_dump -n acme o un DROP SCHEMA acme CASCADE. Escala bien hasta cientos o pocos miles de tenants; más allá, el catálogo de PostgreSQL y las migraciones empiezan a pesar.
Columna tenant_id (discriminador). Todas las tablas compartidas y una columna que indica el dueño de cada fila. Es la opción más densa y barata: añadir un cliente es insertar una fila, y una sola migración actualiza a todos. A cambio, el aislamiento depende enteramente de que todas las consultas filtren, y un tenant enorme comparte índices y estadísticas con los pequeños.
| Criterio | Base de datos por tenant | Esquema por tenant | Columna tenant_id |
|---|---|---|---|
| Aislamiento | Físico, el más fuerte | Lógico fuerte (tablas separadas) | Solo por filtro en las consultas |
| Coste por tenant | Alto | Medio | Mínimo |
| Nº de tenants razonable | Decenas | Cientos a pocos miles | Miles a millones |
| Alta de un tenant | Crear BD + pool + migrar | CREATE SCHEMA + migrar | Insertar una fila |
| Migraciones | Una por BD | Una por esquema | Una para todos |
| Backup/borrado por cliente | Trivial | Fácil (pg_dump -n) | Requiere DELETE por tablas |
| Consultas entre tenants | Muy difíciles | Posibles con UNION | Triviales |
| Soporte en Hibernate | MultiTenantConnectionProvider | MultiTenantConnectionProvider o TenantSchemaMapper | @TenantId |
No hay ganadora universal. La regla práctica: columna tenant_id para SaaS con muchos clientes pequeños, esquema por tenant cuando los clientes exigen aislamiento demostrable o hay que borrar y exportar sus datos a menudo, y base de datos por tenant para pocos clientes grandes con requisitos regulatorios o de rendimiento propios. También se pueden combinar: esquema compartido para el plan básico y base de datos dedicada para los clientes enterprise.
Paso 1: de dónde sale el tenant (y por qué no de una cabecera)
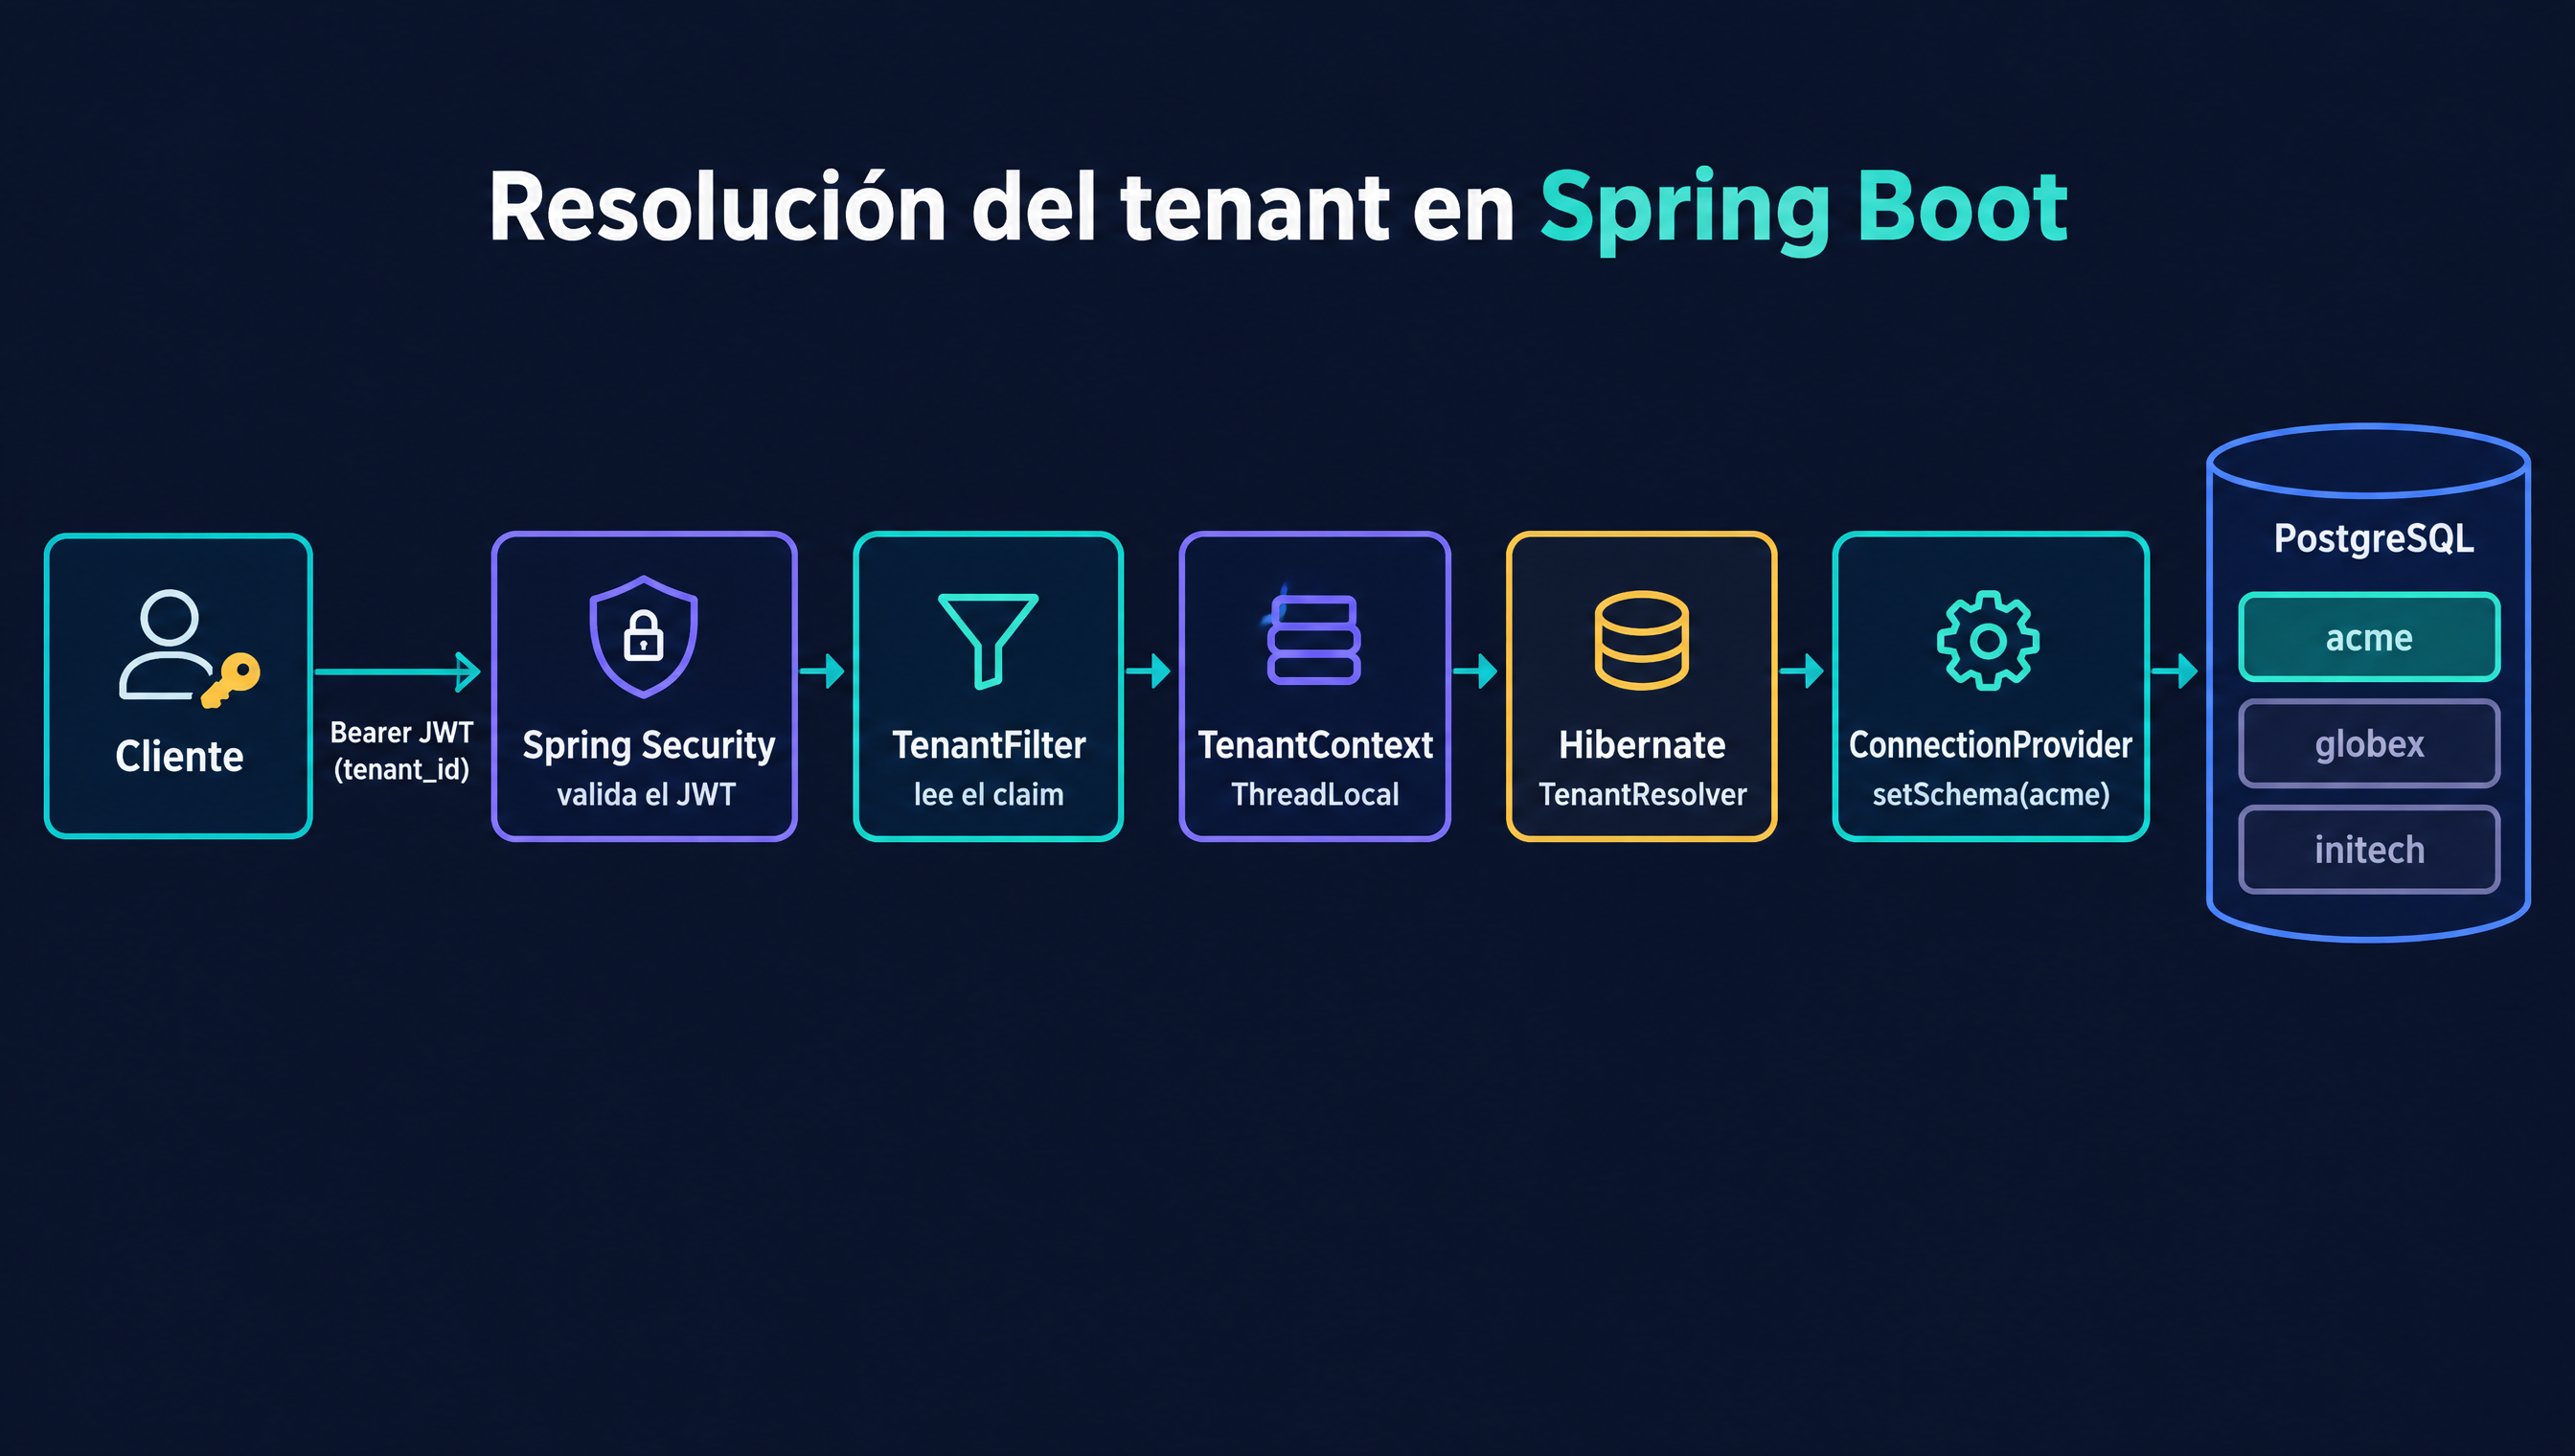
Antes de tocar Hibernate hay que decidir cómo sabe la aplicación quién es el tenant de cada petición. La mayoría de ejemplos leen una cabecera X-Tenant-ID. Es cómodo y peligroso: cualquier usuario autenticado puede cambiar la cabecera y leer los datos de otra empresa. El tenant tiene que salir de algo que el cliente no pueda falsificar: el token firmado.
Si usas Keycloak como vimos en el artículo de Keycloak con Spring Boot, hay dos patrones:
- Un realm compartido con un claim
tenant_id. Guardas el tenant como atributo del usuario y lo publicas en el access token con un protocol mapperoidc-usermodel-attribute-mapper(claim.name: tenant_id). Es lo más simple cuando todos los clientes comparten pantalla de login. - Un realm por tenant. Cada cliente tiene su propio realm (su propia política de contraseñas, su propio SSO con el Active Directory de la empresa) y el tenant se deduce del emisor (
iss). Spring Security lo soporta de serie conJwtIssuerAuthenticationManagerResolver, que acepta tokens de una lista de emisores de confianza, como explica la documentación de multi-tenancy de Spring Security.
En ambos casos, el tenant se guarda en un ThreadLocal mientras dura la petición:
public final class TenantContext {

    private static final ThreadLocal<String> ACTUAL = new ThreadLocal<>();

    private TenantContext() {
    }

    public static void set(String tenant) {
        ACTUAL.set(tenant);
    }

    public static String get() {
        return ACTUAL.get();
    }

    // Imprescindible: los hilos de Tomcat se reutilizan entre peticiones
    public static void clear() {
        ACTUAL.remove();
    }
}
El filtro que lo rellena debe ejecutarse después de que Spring Security haya validado el JWT, nunca antes:
// Sin @Component a propósito: Spring Boot registraría automáticamente cualquier
// Filter que sea un bean y lo ejecutaría ANTES de la cadena de seguridad
public class TenantFilter extends OncePerRequestFilter {

    private final TenantRegistry tenants;

    public TenantFilter(TenantRegistry tenants) {
        this.tenants = tenants;
    }

    @Override
    protected void doFilterInternal(HttpServletRequest request, HttpServletResponse response,
                                    FilterChain chain) throws ServletException, IOException {
        if (!(SecurityContextHolder.getContext().getAuthentication() instanceof JwtAuthenticationToken auth)) {
            chain.doFilter(request, response); // endpoints públicos: sin tenant
            return;
        }
        String tenant = auth.getToken().getClaimAsString("tenant_id");
        // Lista blanca: el valor acabará en un setSchema(), así que nada de confiar a ciegas
        if (tenant == null || !tenants.existe(tenant)) {
            response.sendError(HttpServletResponse.SC_FORBIDDEN, "Tenant desconocido");
            return;
        }
        try {
            TenantContext.set(tenant);
            chain.doFilter(request, response);
        } finally {
            TenantContext.clear(); // aunque la petición falle
        }
    }
}
@Configuration
class SecurityConfig {
@Bean
SecurityFilterChain securityFilterChain(HttpSecurity http, TenantRegistry tenants) throws Exception {
http
.authorizeHttpRequests(auth -> auth
.requestMatchers("/actuator/health/**").permitAll()
.anyRequest().authenticated())
.oauth2ResourceServer(oauth2 -> oauth2.jwt(Customizer.withDefaults()))
// Justo después de validar el Bearer token
.addFilterAfter(new TenantFilter(tenants), BearerTokenAuthenticationFilter.class)
.sessionManagement(s -> s.sessionCreationPolicy(SessionCreationPolicy.STATELESS))
.csrf(csrf -> csrf.disable());
return http.build();
}
}TenantRegistry es simplemente una consulta (cacheada) a una tabla tenant en un esquema de administración, con los identificadores válidos y su estado (activo, suspendido). Además de validar, el finally con clear() no es opcional: Tomcat reutiliza hilos, y un ThreadLocal sin limpiar es exactamente el tipo de error que hace que la petición de un cliente se ejecute con el tenant del anterior.
Paso 2: esquema por tenant con Hibernate 7
Hibernate resuelve la multitenencia con dos piezas, documentadas en MultiTenancySettings:
CurrentTenantIdentifierResolver<T>: le dice a Hibernate cuál es el tenant actual cuando abre una sesión.MultiTenantConnectionProvider<T>: le entrega una conexión JDBC preparada para ese tenant.
Desde Hibernate 6 ya no existe la propiedad hibernate.multiTenancy con valores SCHEMA o DATABASE que aparece en tutoriales antiguos: Hibernate deduce el modo a partir de lo que configures. Spring Boot 4.1 trae Hibernate 7.4, así que todo lo que sigue aplica tal cual.
El resolver
@Component
class TenantIdentifierResolver implements CurrentTenantIdentifierResolver<String> {

    // Esquema sin tablas de negocio: si algo se ejecuta sin tenant, falla en lugar de mezclar datos
    static final String SIN_TENANT = "public";

    @Override
    public String resolveCurrentTenantIdentifier() {
        String tenant = TenantContext.get();
        return tenant != null ? tenant : SIN_TENANT;
    }

    @Override
    public boolean validateExistingCurrentSessions() {
        // Hibernate comprueba que una sesión ya abierta no cambie de tenant a mitad
        return true;
    }
}
El valor por defecto es una decisión de seguridad. Devolver un tenant "real" cuando falta el contexto convierte un error de programación en una fuga de datos; devolver un esquema vacío lo convierte en un relation "factura" does not exist, que es exactamente lo que quieres ver en los logs.
El connection provider (y la fuga del pool)
@Component
class SchemaPerTenantConnectionProvider implements MultiTenantConnectionProvider<String> {

    private final DataSource dataSource;

    SchemaPerTenantConnectionProvider(DataSource dataSource) {
        this.dataSource = dataSource; // el HikariCP que Spring Boot ya configura
    }

    @Override
    public Connection getAnyConnection() throws SQLException {
        return dataSource.getConnection(); // usada en el arranque y sin tenant
    }

    @Override
    public void releaseAnyConnection(Connection connection) throws SQLException {
        connection.close();
    }

    @Override
    public Connection getConnection(String tenant) throws SQLException {
        Connection connection = getAnyConnection();
        // En PostgreSQL, setSchema() fija el search_path de la sesión
        connection.setSchema(tenant);
        return connection;
    }

    @Override
    public void releaseConnection(String tenant, Connection connection) throws SQLException {
        // CLAVE: la conexión vuelve al pool; si no se restablece, el siguiente
        // que la reciba sin pasar por getConnection() verá los datos de este tenant
        connection.setSchema(TenantIdentifierResolver.SIN_TENANT);
        connection.close();
    }

    @Override
    public boolean supportsAggressiveRelease() {
        return false;
    }

    @Override
    public boolean isUnwrappableAs(Class<?> unwrapType) {
        return false;
    }

    @Override
    public <T> T unwrap(Class<T> unwrapType) {
        throw new UnknownUnwrapTypeException(unwrapType);
    }
}
El detalle de releaseConnection es el hueco más peligroso de los ejemplos que circulan. HikariCP no sabe nada de tenants: la conexión vuelve al pool con el search_path que tuviera. Si después la recoge código que no pasa por Hibernate (un JdbcTemplate, Flyway, un health check), trabajará en el esquema del último cliente. Restablecer el esquema al liberar cierra esa puerta.
Registrarlo en Spring Boot 4
import org.hibernate.cfg.MultiTenancySettings;
// En Spring Boot 4 la clase vive en el módulo spring-boot-hibernate
import org.springframework.boot.hibernate.autoconfigure.HibernatePropertiesCustomizer;

@Configuration
class MultiTenancyConfig {

    @Bean
    HibernatePropertiesCustomizer multiTenancy(SchemaPerTenantConnectionProvider connectionProvider,
                                               TenantIdentifierResolver tenantResolver) {
        return properties -> {
            properties.put(MultiTenancySettings.MULTI_TENANT_CONNECTION_PROVIDER, connectionProvider);
            properties.put(MultiTenancySettings.MULTI_TENANT_IDENTIFIER_RESOLVER, tenantResolver);
        };
    }
}spring:
jpa:
# Las tablas las crea Flyway en cada esquema, nunca Hibernate
hibernate:
ddl-auto: none
# Evita mantener el EntityManager abierto durante toda la vista
open-in-view: false
flyway:
# Desactivamos la migración automática: la haremos esquema a esquema (paso 4)
enabled: falseSi vienes de Spring Boot 3, el único cambio es el paquete de HibernatePropertiesCustomizer, que antes estaba en org.springframework.boot.autoconfigure.orm.jpa. A partir de aquí, tus entidades y repositorios de Spring Data JPA no cambian en absoluto: un facturaRepository.findAll() lee solo las facturas del esquema del tenant actual.
Un apunte: Hibernate 7.1 añadió TenantSchemaMapper, que activa el modo de esquema por tenant con un solo método (schemaName(tenant)) y fija el esquema en cada conexión sin que escribas el provider. Es más corto, pero está marcado como @Incubating, así que su API puede cambiar entre versiones. Para producción, el MultiTenantConnectionProvider explícito sigue siendo la opción estable y te deja controlar el restablecimiento del esquema.
Paso 3: columna tenant_id con @TenantId
Si eliges el discriminador, Hibernate lo hace aún más sencillo con la anotación @TenantId, disponible desde Hibernate 6. Solo necesitas el resolver del paso anterior (sin connection provider):
@Entity
@Table(name = "factura")
class Factura {

    @Id
    @GeneratedValue
    private Long id;

    // Hibernate la rellena al persistir y la añade a TODAS las consultas JPQL/Criteria
    @TenantId
    @Column(name = "tenant_id", nullable = false, updatable = false)
    private String tenantId;

    private String cliente;
    private BigDecimal total;

    // getters, constructor protegido para JPA...
}
@Bean
HibernatePropertiesCustomizer multiTenancy(TenantIdentifierResolver tenantResolver) {
return properties ->
properties.put(MultiTenancySettings.MULTI_TENANT_IDENTIFIER_RESOLVER, tenantResolver);
}Con eso, new Factura(...) guardada por un usuario de acme lleva tenant_id = 'acme' sin que nadie lo asigne, y select f from Factura f se convierte en ... where f.tenant_id = ?. Hibernate también comprueba al guardar que una entidad no cambie de tenant. Para informes globales de administración, CurrentTenantIdentifierResolver tiene el método isRoot(tenant): si devuelve true para un tenant especial (por ejemplo root), esa sesión ve todas las particiones.
Ahora, la letra pequeña: @TenantId solo protege lo que pasa por Hibernate. Una consulta nativa con @Query(nativeQuery = true), un JdbcTemplate, un proceso de Spring Batch o un analista con acceso a la base de datos no reciben el filtro. Y ningún índice compuesto se crea solo: añade tenant_id como primera columna de los índices de las tablas grandes, o cada consulta recorrerá los datos de todos los clientes.
Red de seguridad: Row Level Security en PostgreSQL
Para que un olvido no se convierta en una fuga, la base de datos puede aplicar el mismo filtro por su cuenta con Row Level Security:
ALTER TABLE factura ENABLE ROW LEVEL SECURITY;
-- Sin FORCE, el dueño de la tabla (a menudo el usuario de la aplicación) se salta las políticas
ALTER TABLE factura FORCE ROW LEVEL SECURITY;

CREATE POLICY aislamiento_tenant ON factura
    USING (tenant_id = current_setting('app.tenant_id', true))
    WITH CHECK (tenant_id = current_setting('app.tenant_id', true));
La aplicación solo tiene que fijar app.tenant_id en cada conexión. Puedes reutilizar el patrón del connection provider: en getConnection(tenant) ejecuta select set_config('app.tenant_id', ?, false) con el tenant como parámetro, y en releaseConnection vuelve a dejarlo vacío. Si app.tenant_id no está definido, current_setting(..., true) devuelve NULL, la comparación nunca es verdadera y la consulta no devuelve filas: el fallo es seguro por defecto. Con RLS, incluso una consulta nativa sin WHERE queda limitada al tenant correcto.
Paso 4: migraciones Flyway en cada esquema
Con esquema por tenant, la migración automática de Spring Boot no sirve: migraría un único esquema. Igual que en el artículo de migraciones con Flyway en Spring Boot, los scripts viven en el classpath, pero los aplicamos esquema a esquema:
@Component
class TenantMigrator implements ApplicationRunner {

    private static final Logger log = LoggerFactory.getLogger(TenantMigrator.class);

    private final DataSource dataSource;
    private final TenantRegistry tenants;

    TenantMigrator(DataSource dataSource, TenantRegistry tenants) {
        this.dataSource = dataSource;
        this.tenants = tenants;
    }

    @Override
    public void run(ApplicationArguments args) {
        List<String> fallidos = new ArrayList<>();
        for (String tenant : tenants.activos()) {
            try {
                migrar(tenant);
            } catch (FlywayException e) {
                // Un tenant roto no debe impedir migrar a los demás
                log.error("Migración fallida para el tenant {}", tenant, e);
                fallidos.add(tenant);
            }
        }
        if (!fallidos.isEmpty()) {
            // La instancia no llega a estar "ready": Kubernetes no le enviará tráfico
            throw new IllegalStateException("Tenants sin migrar: " + fallidos);
        }
    }

    // También se llama al dar de alta un tenant nuevo
    void migrar(String tenant) {
        Flyway.configure()
                .dataSource(dataSource)
                // El primer esquema es el de trabajo: Flyway lo crea si no existe
                // y guarda ahí su propia tabla flyway_schema_history
                .schemas(tenant)
                .locations("classpath:db/migration/tenant")
                .load()
                .migrate();
    }
}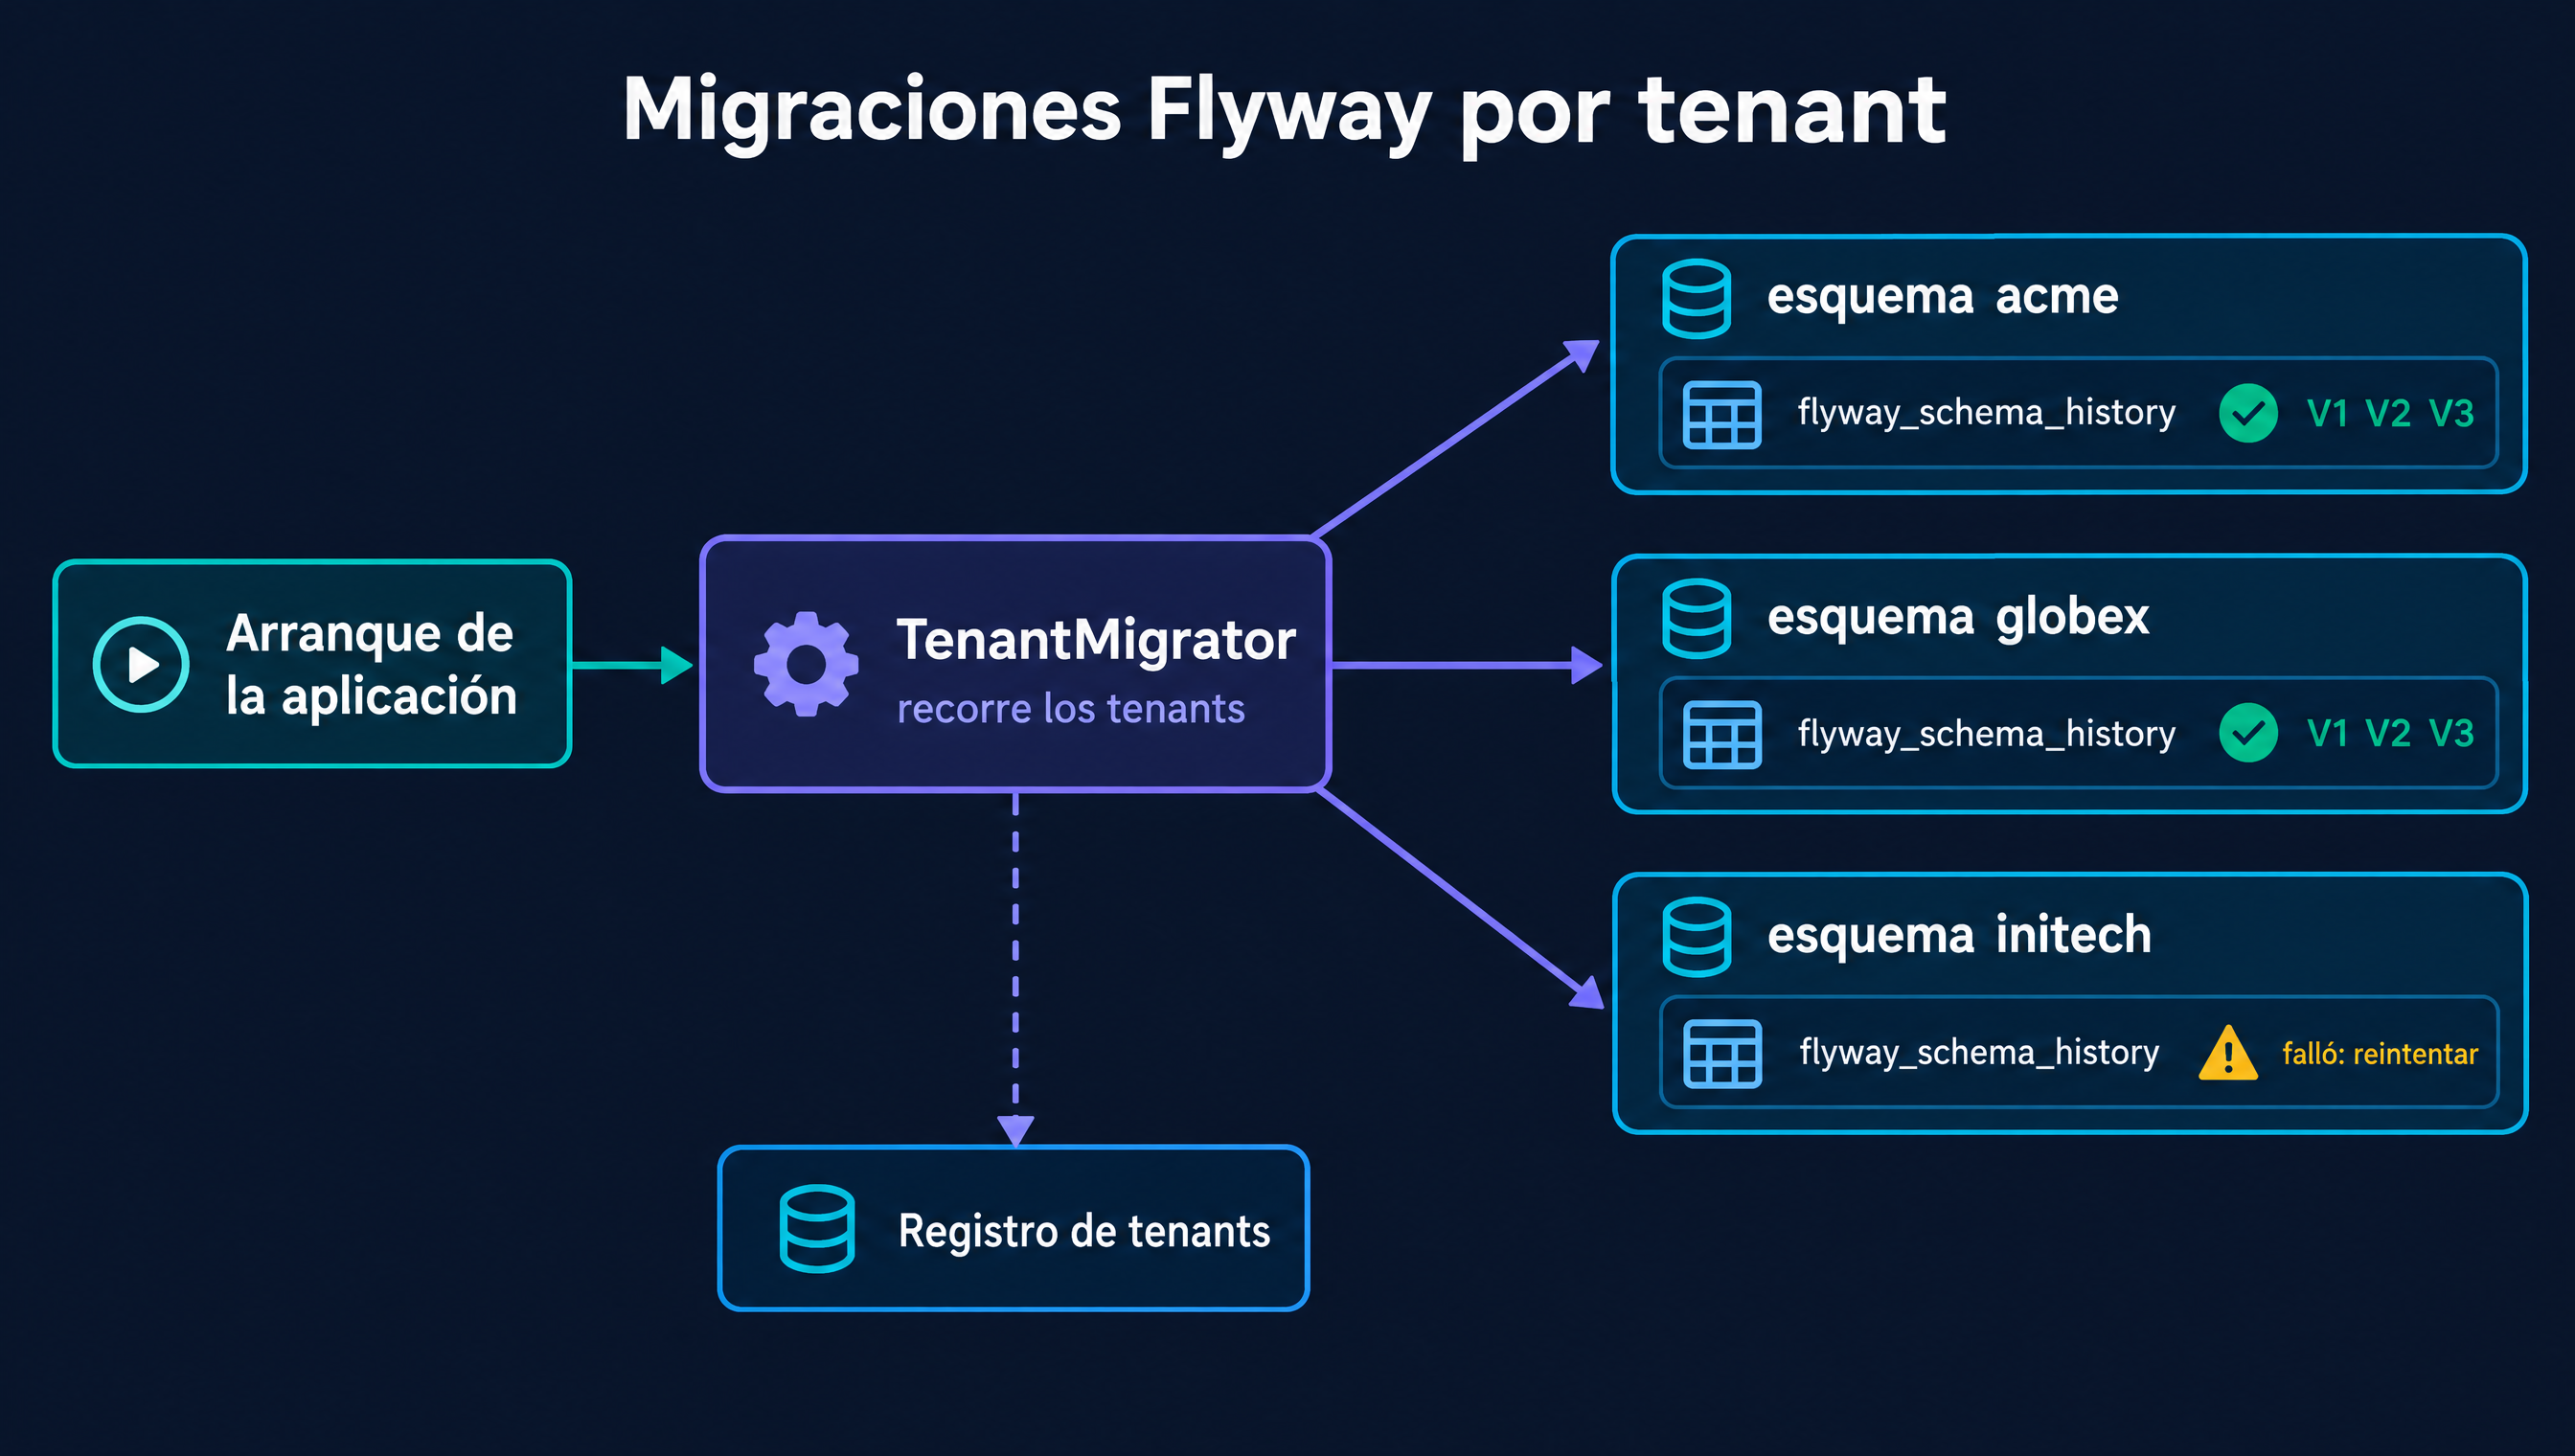
Tres decisiones de este código que marcan la diferencia en producción:
- Cada esquema tiene su propio
flyway_schema_history. Así sabes exactamente en qué versión está cada cliente y un fallo en uno no corrompe el historial de los demás. - Se usa
ApplicationRunner. Spring Boot no marca la aplicación como lista para recibir tráfico hasta que terminan los runners, de modo que la readiness probe que vimos en Spring Boot en Kubernetes protege a los usuarios de un esquema a medio migrar. Con cientos de tenants, eso sí, el arranque se alarga: a partir de cierto tamaño conviene mover las migraciones a unJobde Kubernetes previo al despliegue. - Las migraciones deben ser compatibles hacia atrás. Durante un despliegue progresivo habrá esquemas migrados atendidos por pods con la versión anterior. Añade columnas antes de usarlas y elimínalas en una versión posterior (el patrón expand and contract).
Paso 5: el tenant fuera del hilo de la petición
El ThreadLocal funciona mientras todo ocurre en el hilo de la petición. En cuanto el trabajo salta a otro hilo, el tenant desaparece y el resolver devuelve el esquema vacío (si lo configuraste así; si no, el de otro cliente). Para @Async y los ejecutores de Spring, un TaskDecorator copia el contexto:
@Bean
TaskDecorator tenantTaskDecorator() {
    return tarea -> {
        String tenant = TenantContext.get(); // se captura en el hilo que encola
        return () -> {
            TenantContext.set(tenant);       // se restaura en el hilo que ejecuta
            try {
                tarea.run();
            } finally {
                TenantContext.clear();
            }
        };
    };
}
Spring Boot aplica automáticamente un bean TaskDecorator al ejecutor que autoconfigura para @Async, también cuando usas Virtual Threads en Spring Boot. Los hilos virtuales no cambian el problema: cada tarea nueva empieza sin ThreadLocal. Si trabajas con Java 25, los Scoped Values (JEP 506) son una alternativa más segura, porque el valor está ligado a un bloque de código y desaparece solo al salir de él.
Otros dos sitios donde el tenant se pierde con facilidad:
- Mensajería. Un consumidor de Kafka o RabbitMQ no tiene JWT. El productor debe enviar el tenant en una cabecera del mensaje y el consumidor fijarlo en
TenantContext(y limpiarlo) antes de procesar. - Tareas programadas. Un
@Scheduledno pertenece a ningún tenant: recorretenants.activos()y ejecuta el trabajo dentro de unset/clearpor cada uno.
Y uno que no se pierde, sino que se mezcla: la caché. Una clave #id en @Cacheable es la misma para el producto 42 de acme y el de globex. Incluye el tenant en la clave o usa un KeyGenerator propio, como vimos con la abstracción de caché de Spring.
Paso 6: probar el aislamiento con Testcontainers
El test más importante de una aplicación multi-tenant no comprueba que algo funcione, sino que algo no se vea. Con Testcontainers y un PostgreSQL real:
@SpringBootTest
@Testcontainers
class AislamientoTenantIT {

    @Container
    @ServiceConnection
    static PostgreSQLContainer postgres = new PostgreSQLContainer("postgres:18-alpine");

    @Autowired TenantMigrator migrator;
    @Autowired FacturaRepository facturas;

    @BeforeEach
    void preparar() {
        migrator.migrar("acme");
        migrator.migrar("globex");
    }

    @Test
    void unTenantNoVeLosDatosDeOtro() {
        enTenant("acme", () -> facturas.save(new Factura("Cliente A", new BigDecimal("100.00"))));

        enTenant("globex", () -> assertThat(facturas.findAll()).isEmpty());
        enTenant("acme", () -> assertThat(facturas.findAll()).hasSize(1));
    }

    @Test
    void sinTenantFallaEnLugarDeMezclarDatos() {
        assertThatThrownBy(() -> facturas.findAll())
                .isInstanceOf(InvalidDataAccessResourceUsageException.class);
    }

    private void enTenant(String tenant, Runnable accion) {
        try {
            TenantContext.set(tenant);
            accion.run();
        } finally {
            TenantContext.clear();
        }
    }
}
El segundo test es el que suele faltar: verifica que el valor por defecto del resolver hace fallar la operación en vez de devolver datos. Añade también un test de controlador con dos JWT de tenants distintos y, si usas RLS, uno que ejecute una consulta nativa sin WHERE y compruebe que solo devuelve las filas del tenant activo.
Riesgos y trade-offs
- El fallo típico no es técnico, es de omisión. Una consulta nativa, un job o un script de soporte que no pasa por el mecanismo de tenant. Por eso conviene una segunda capa (esquemas separados o RLS) además del filtro de Hibernate.
- Tenants ruidosos. En las estrategias compartidas, el informe pesado de un cliente grande ralentiza a todos. Combina el aislamiento de datos con rate limiting por tenant y, si hace falta, mueve a ese cliente a su propia base de datos.
- Límites de escala del esquema por tenant. Miles de esquemas significan cientos de miles de tablas en el catálogo de PostgreSQL, migraciones que tardan horas y herramientas de administración que sufren. Mide antes de comprometerte.
- Pools de conexiones con base de datos por tenant. Con un
AbstractRoutingDataSourcey un HikariCP por tenant, cien clientes con diez conexiones por pod y cinco pods son 5.000 conexiones abiertas. Necesitarás pools pequeños, creación perezosa o un PgBouncer delante. - Observabilidad. Un error sin el tenant en el log es casi imposible de investigar. Añade el tenant al MDC en el
TenantFiltery como atributo en las trazas.
¿Cuándo usar multi-tenant y cuándo no?
Usa una arquitectura multi-tenant cuando vendes el mismo producto a muchas organizaciones, el coste por cliente importa (planes gratuitos o baratos) y quieres desplegar una sola versión para todos. Es el modelo natural de cualquier SaaS B2B.
Probablemente no la necesitas si tienes un único cliente o unos pocos con contratos que exigen infraestructura dedicada, si cada cliente necesita una versión distinta del software, o si tu equipo no puede asumir la disciplina de tests y revisiones que exige el aislamiento. En esos casos, un despliegue single-tenant automatizado (un namespace de Kubernetes por cliente, por ejemplo) es más sencillo de razonar, aunque más caro.
Buenas prácticas
- Obtén el tenant del token firmado, nunca de una cabecera, un parámetro o un subdominio sin validar contra el usuario autenticado.
- Valida el tenant contra una lista blanca antes de usarlo en un
setSchema()o en una URL de conexión. - Limpia siempre el
ThreadLocalen unfinallyy propágalo explícitamente a@Async, mensajes y tareas programadas. - Falla de forma segura sin tenant: esquema vacío o RLS que no devuelve filas, nunca un tenant por defecto con datos.
- Restablece el estado de la conexión (esquema, variables de sesión) al devolverla al pool.
- Una segunda capa de aislamiento: esquemas separados o Row Level Security, además del filtro de la aplicación.
- Migraciones por tenant, aisladas y compatibles hacia atrás, con su propio historial y sin bloquear al resto si una falla.
- Tests de aislamiento que comprueben que un tenant no ve los datos de otro, ejecutados en cada pipeline.
Preguntas frecuentes
¿Qué es una aplicación multi-tenant?
Es una aplicación en la que una sola instancia atiende a varios clientes (tenants) con sus datos aislados. Todos comparten el código y el despliegue, y normalmente la infraestructura, pero cada cliente solo ve su información. Es el modelo habitual de los productos SaaS.
¿Qué diferencia hay entre single-tenant y multi-tenant?
En single-tenant cada cliente tiene su propia instalación completa de la aplicación y su base de datos; en multi-tenant todos comparten una misma instalación y el aislamiento se hace en los datos. Single-tenant ofrece más aislamiento y personalización a un coste operativo mucho mayor; multi-tenant reduce costes y simplifica las actualizaciones.
¿Es mejor un esquema por tenant o una columna tenant_id?
Depende del número de clientes y del aislamiento que exijan. La columna tenant_id escala a miles de tenants con una sola migración, pero el aislamiento depende de filtrar todas las consultas. El esquema por tenant aísla las tablas y facilita exportar o borrar un cliente, pero se complica a partir de unos pocos miles de esquemas.
¿Cómo se implementa multi-tenancy en Spring Boot con Hibernate?
Implementando un CurrentTenantIdentifierResolver que lea el tenant actual (por ejemplo, de un ThreadLocal rellenado desde el JWT) y registrándolo con un HibernatePropertiesCustomizer. Para esquema o base de datos por tenant se añade un MultiTenantConnectionProvider; para la columna discriminadora basta con anotar el campo con @TenantId.
¿Cómo ejecutar las migraciones de Flyway en todos los tenants?
Desactiva la migración automática con spring.flyway.enabled=false y, al arrancar, recorre la lista de tenants creando una instancia de Flyway por esquema con .schemas(tenant). Así cada esquema guarda su propio flyway_schema_history, y conviene capturar los errores por tenant para que uno roto no bloquee a los demás.
¿@TenantId filtra también las consultas nativas?
No. @TenantId solo afecta a las operaciones que pasan por Hibernate (JPQL, Criteria y métodos de Spring Data). Las consultas nativas, el JdbcTemplate o los accesos directos a la base de datos no se filtran, por eso es recomendable añadir Row Level Security en PostgreSQL como segunda capa.
Conclusión
Construir una aplicación multi-tenant en Spring Boot no es difícil por la cantidad de código, que cabe en media docena de clases, sino por la cantidad de sitios donde el tenant se puede perder o mezclar: una cabecera falsificable, un ThreadLocal sin limpiar, una conexión que vuelve al pool con el esquema de otro cliente, una consulta nativa, un hilo @Async, una clave de caché. Hibernate 7 resuelve la parte central con CurrentTenantIdentifierResolver, MultiTenantConnectionProvider y @TenantId; el resto es disciplina de diseño.
Si te quedas con lo esencial: elige la estrategia por número de clientes y nivel de aislamiento (columna para muchos pequeños, esquema para aislamiento demostrable, base de datos para pocos grandes), saca el tenant del JWT y valídalo, haz que la ausencia de tenant falle en vez de filtrar datos, migra cada esquema por separado y escribe el test que demuestra que un cliente no ve los datos de otro. Con esas piezas, el cliente número cincuenta llega sin que nadie tenga que acordarse de un WHERE.


