
Spring Boot en Kubernetes: guía para desplegar microservicios listos para producción
Desplegar Spring Boot en Kubernetes parece trivial la primera vez: un Deployment con la imagen, un Service delante, kubectl apply y la aplicación responde. Los problemas llegan después, en producción. Pods que Kubernetes reinicia en bucle porque la JVM tarda más en arrancar de lo que la liveness probe está dispuesta a esperar. Errores 502 en cada despliegue porque el balanceador sigue enviando tráfico a pods que ya se están apagando. Contenedores que terminan en OOMKilled sin un solo stack trace. Y un autoescalado que dispara réplicas nuevas justo cuando el calentamiento del JIT dispara la CPU, empeorando el pico en lugar de absorberlo.
Ninguno de esos problemas es de Kubernetes ni de Spring Boot por separado: aparecen en la frontera entre ambos, donde el orquestador hace suposiciones sobre el proceso que ejecuta y la JVM hace las suyas sobre el entorno. Este artículo continúa donde lo dejamos en cómo dockerizar Spring Boot para producción: con una imagen bien construida en la mano, vamos a escribir los manifiestos de Kubernetes que la ejecutan bien. Veremos el Deployment completo, las tres probes conectadas a Actuator, cómo dimensionar requests y limits pensando en la JVM, la configuración con ConfigMaps y Secrets, el apagado ordenado sin errores, y cómo proteger la disponibilidad con HPA y PodDisruptionBudget. Todo con Spring Boot 4.1 y Java 25.
¿Qué significa desplegar Spring Boot en Kubernetes?
Desplegar Spring Boot en Kubernetes es ejecutar la imagen de la aplicación como un conjunto de pods gestionados por un Deployment, expuestos mediante un Service, configurados desde ConfigMaps y Secrets, y vigilados mediante probes que consultan los endpoints de salud de Actuator. Kubernetes decide dónde corre cada réplica, la reinicia si falla y la reemplaza sin cortar el servicio.
La clave de esa definición es la palabra vigilados. Kubernetes no sabe nada de Java: solo ve un proceso, sus métricas de CPU y memoria, y lo que responden las probes. Si la aplicación no le cuenta con precisión cuándo está viva, cuándo está lista para recibir tráfico y cuándo se está apagando, el orquestador tomará decisiones equivocadas. Por suerte, Spring Boot tiene soporte nativo para todo eso: detecta que corre en Kubernetes (por las variables de entorno *_SERVICE_HOST y *_SERVICE_PORT que el clúster inyecta) y activa automáticamente los grupos de salud liveness y readiness de Actuator, tal como describe la guía oficial de despliegue en la nube.
Los recursos de Kubernetes que necesita un microservicio Spring Boot
Antes de escribir YAML conviene tener el mapa completo. Un microservicio Spring Boot de producción suele necesitar estos objetos:
| Recurso | Para qué sirve |
|---|---|
Deployment | Declara la imagen, el número de réplicas, las probes, los recursos y la estrategia de actualización |
Service | Da un nombre DNS estable y balancea entre los pods que están ready |
Ingress o Gateway | Expone el servicio fuera del clúster con HTTP/TLS |
ConfigMap | Configuración no sensible: perfiles, URLs, flags |
Secret | Credenciales: contraseñas de base de datos, claves de API |
HorizontalPodAutoscaler | Ajusta el número de réplicas según la carga |
PodDisruptionBudget | Garantiza un mínimo de réplicas durante mantenimientos del clúster |
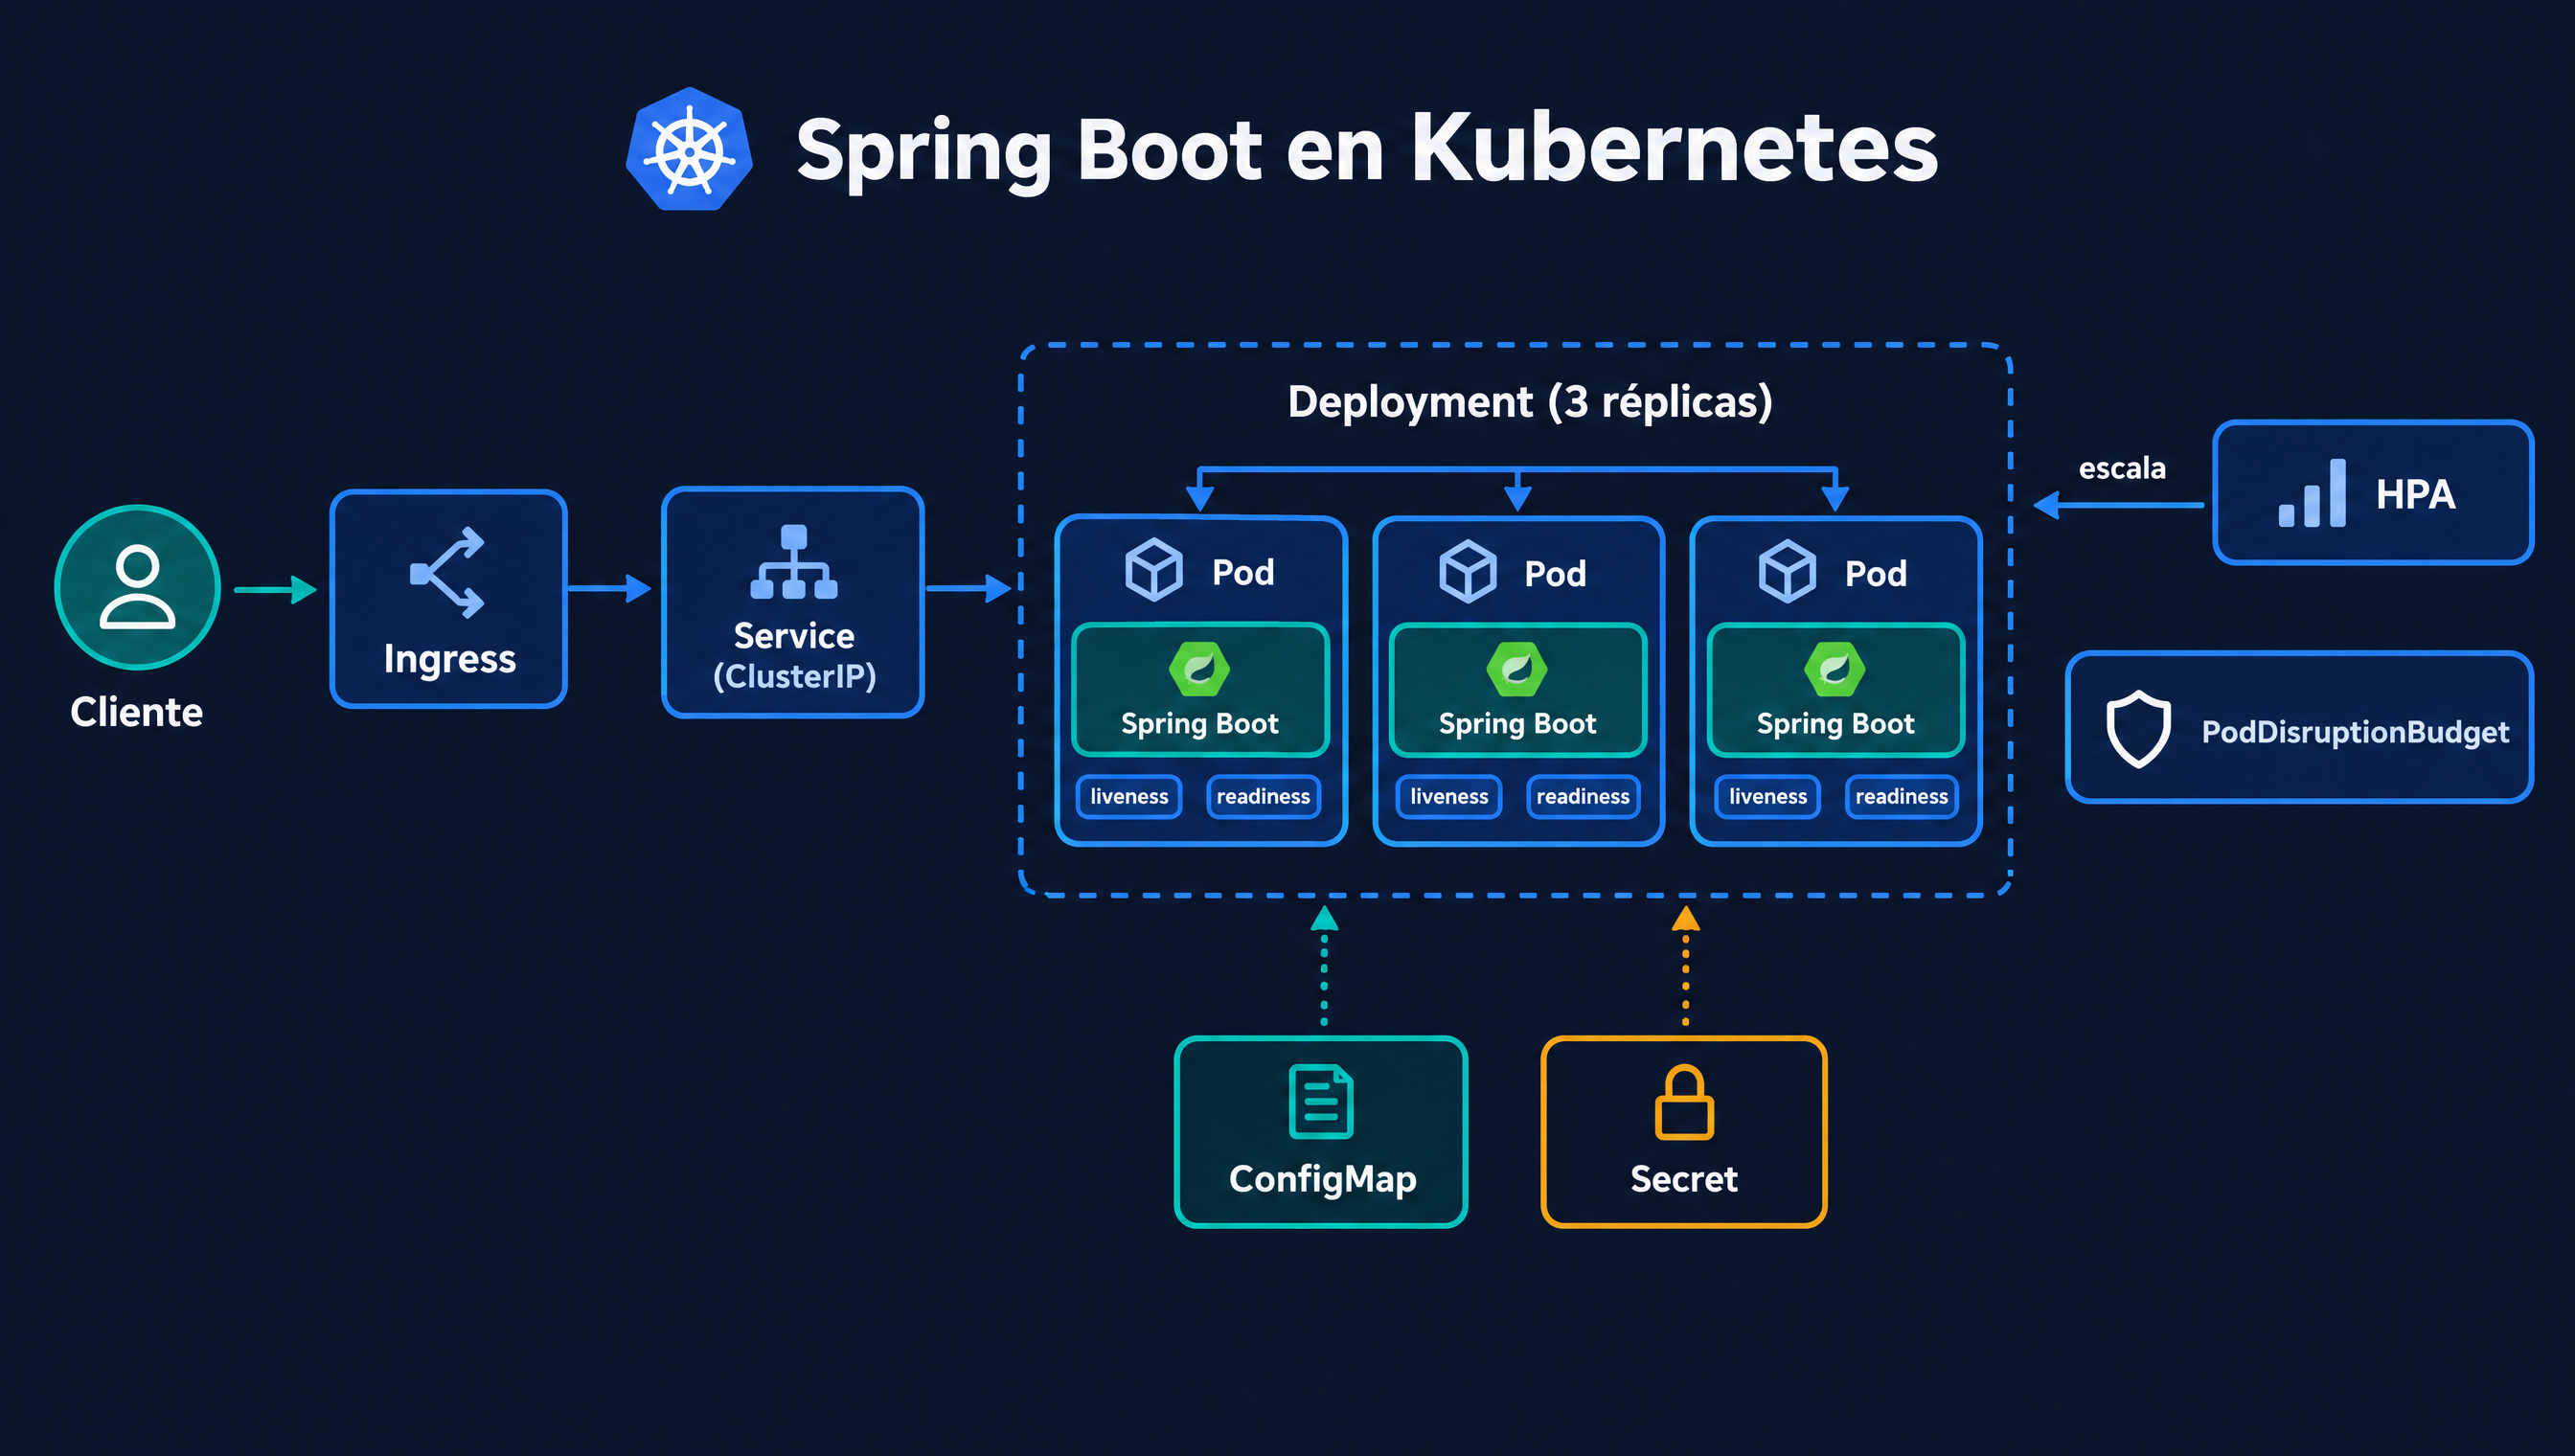
Vamos a construirlos en orden, empezando por la pieza central.
El Deployment completo de Spring Boot en Kubernetes
Este es el Deployment que vamos a desgranar en las siguientes secciones. Parte de la imagen pedidos-service construida en el artículo anterior:
# deployment.yaml
apiVersion: apps/v1
kind: Deployment
metadata:
  name: pedidos-service
  labels:
    app: pedidos-service
spec:
  replicas: 3
  revisionHistoryLimit: 5
  selector:
    matchLabels:
      app: pedidos-service
  strategy:
    type: RollingUpdate
    rollingUpdate:
      maxSurge: 1          # como mucho un pod extra durante la actualización
      maxUnavailable: 0    # nunca bajamos de 3 pods listos
  template:
    metadata:
      labels:
        app: pedidos-service
    spec:
      terminationGracePeriodSeconds: 45   # > preStop (10s) + shutdown de Spring (30s)
      securityContext:
        runAsNonRoot: true
      containers:
        - name: app
          # Nunca "latest": versión o SHA del commit para que el rollback signifique algo
          image: registry.ejemplo.com/pedidos-service:1.4.2
          ports:
            - name: http
              containerPort: 8080
          envFrom:
            - configMapRef:
                name: pedidos-config
          env:
            - name: JAVA_TOOL_OPTIONS
              value: "-XX:MaxRAMPercentage=75 -XX:+ExitOnOutOfMemoryError -XX:ActiveProcessorCount=2"
          volumeMounts:
            - name: secretos
              mountPath: /run/secrets/pedidos
              readOnly: true
          resources:
            requests:
              cpu: "500m"
              memory: "1Gi"
            limits:
              memory: "1Gi"   # memoria: request = limit
          startupProbe:
            httpGet:
              path: /actuator/health/liveness
              port: http
            periodSeconds: 5
            failureThreshold: 24       # hasta 120 s para arrancar
          livenessProbe:
            httpGet:
              path: /actuator/health/liveness
              port: http
            periodSeconds: 10
            failureThreshold: 3
          readinessProbe:
            httpGet:
              path: /actuator/health/readiness
              port: http
            periodSeconds: 5
            failureThreshold: 3
          lifecycle:
            preStop:
              sleep:
                seconds: 10            # Kubernetes 1.32+
          securityContext:
            allowPrivilegeEscalation: false
            readOnlyRootFilesystem: true
      volumes:
        - name: secretos
          secret:
            secretName: pedidos-secret
Y el Service que lo expone dentro del clúster:
# service.yaml
apiVersion: v1
kind: Service
metadata:
  name: pedidos-service
spec:
  type: ClusterIP
  selector:
    app: pedidos-service
  ports:
    - name: http
      port: 80
      targetPort: http
Dentro del clúster, cualquier otro servicio llega a este en http://pedidos-service (o pedidos-service.<namespace>.svc.cluster.local). Ese DNS interno es, de hecho, la razón por la que en Kubernetes rara vez hace falta un registro de servicios como Spring Cloud Eureka: el Service ya resuelve el descubrimiento y el balanceo.
Un detalle sobre readOnlyRootFilesystem: true: es una buena práctica de seguridad, pero Tomcat necesita escribir ficheros temporales. Si lo activas, monta un volumen emptyDir en /tmp; si no quieres lidiar con ello al principio, puedes dejarlo en false y endurecerlo más adelante.
Liveness, readiness y startup probes con Spring Boot Actuator
Las probes son la parte más importante del despliegue y la que más se configura mal. Kubernetes ofrece tres, y cada una responde a una pregunta distinta:
startupProbe: ¿ha terminado de arrancar? Mientras no tenga éxito, Kubernetes no ejecuta las otras dos. Protege a las aplicaciones de arranque lento.livenessProbe: ¿está el proceso en un estado del que no puede recuperarse? Si falla, Kubernetes reinicia el contenedor.readinessProbe: ¿puede atender tráfico ahora mismo? Si falla, el pod sale de los endpoints del Service, pero no se reinicia.
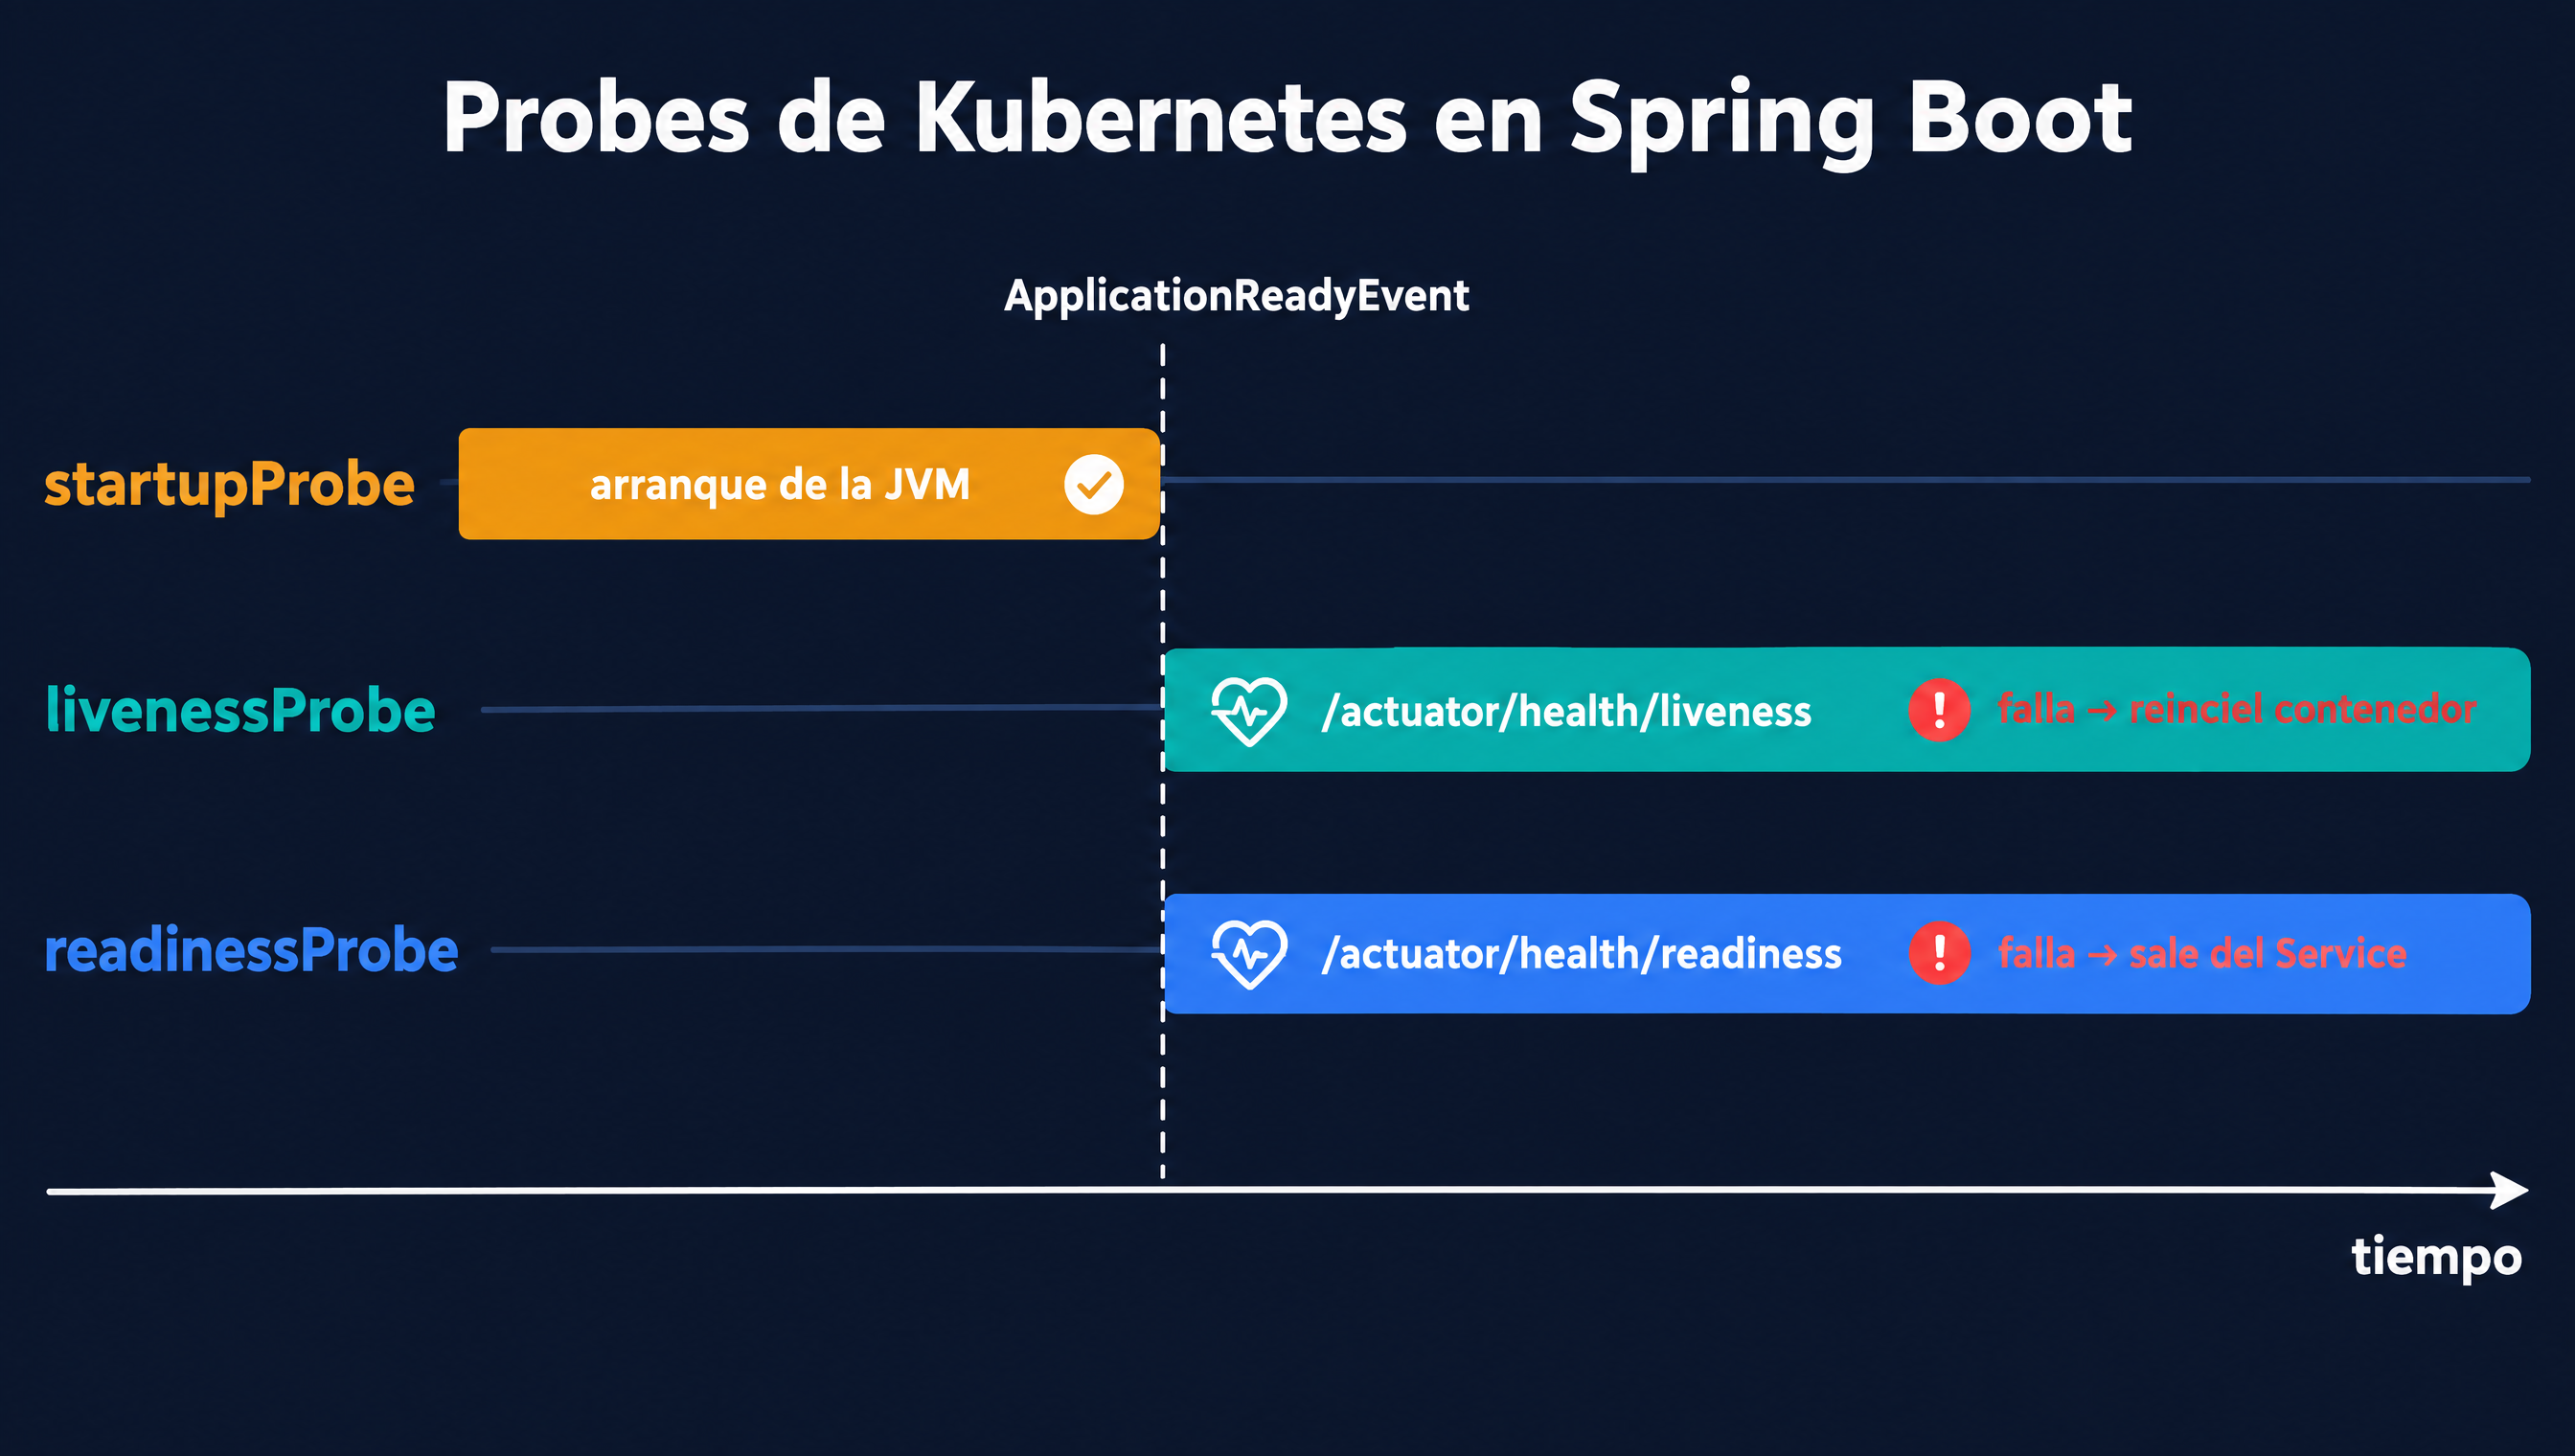
Spring Boot mapea estas preguntas a su modelo de disponibilidad de la aplicación: el estado LivenessState (CORRECT o BROKEN) y el estado ReadinessState (ACCEPTING_TRAFFIC o REFUSING_TRAFFIC). Durante el arranque, la aplicación pasa a LivenessState.CORRECT cuando el contexto está refrescado, y a ReadinessState.ACCEPTING_TRAFFIC solo después de que se ejecuten los ApplicationRunner y CommandLineRunner. Durante el apagado ordenado, vuelve a REFUSING_TRAFFIC. Actuator expone ambos estados en /actuator/health/liveness y /actuator/health/readiness, como documenta la sección de Kubernetes probes de Actuator.
Si ya configuraste Spring Boot Actuator para monitoreo, la configuración mínima es esta:
# application.yml
management:
  endpoint:
    health:
      probes:
        enabled: true               # se activa solo en Kubernetes; así también en local
        add-additional-paths: true  # expone /livez y /readyz en el puerto principal
  endpoints:
    web:
      exposure:
        include: health,info,prometheus
server:
  shutdown: graceful                # valor por defecto, explícito para dejar constancia
spring:
  lifecycle:
    timeout-per-shutdown-phase: 30s
Por qué la liveness probe nunca debe comprobar la base de datos
Este es el error más caro. Es tentador apuntar la livenessProbe a /actuator/health, que incluye el estado de la base de datos, Redis, el broker… Imagina que la base de datos sufre un corte de 40 segundos. Todos los pods fallan la liveness a la vez, Kubernetes reinicia todas las réplicas simultáneamente, y cuando la base de datos vuelve, te encuentras con una flota entera arrancando en frío, compitiendo por conexiones y calentando el JIT. Has convertido una degradación temporal en una caída completa.
La documentación de Spring es explícita: el estado de liveness no debe depender de sistemas externos. Reiniciar el pod no arregla la base de datos. Lo correcto es:
- Liveness: solo el estado interno (
livenessState). Falla solo si el proceso está realmente roto: un deadlock, una caché local corrupta. - Readiness: el estado interno y, con cuidado, dependencias imprescindibles y exclusivas de este servicio.
management:
  endpoint:
    health:
      group:
        readiness:
          include: readinessState,db   # el pod deja de recibir tráfico si pierde su BD
Incluso añadir db a la readiness merece una reflexión: si la base de datos es compartida por todas las réplicas, todas dejarán de estar ready a la vez y el Service se quedará sin endpoints, devolviendo errores de conexión en lugar de respuestas de error controladas. Muchas veces es preferible que la aplicación siga ready y responda un 503 con un mensaje claro, apoyándose en un circuit breaker con Resilience4J.
Startup probe: el arranque lento de la JVM
Una aplicación Spring Boot mediana puede tardar entre 10 y 40 segundos en arrancar, más en nodos con poca CPU. Sin startupProbe, la única forma de no matar el pod durante el arranque es poner un initialDelaySeconds largo en la liveness, que retrasa también la detección de fallos reales durante toda la vida del pod. La startupProbe resuelve esto: con periodSeconds: 5 y failureThreshold: 24, la aplicación tiene hasta 120 segundos para arrancar, y en cuanto lo consigue, la liveness empieza a vigilar con su propio umbral corto.
Si quieres reducir ese tiempo, la caché AOT de Java 25 que vimos al dockerizar Spring Boot recorta el arranque de forma notable, y eso se traduce directamente en despliegues y autoescalados más rápidos.
Cambiar el estado de disponibilidad desde el código
A veces la propia aplicación sabe que no debe recibir tráfico: por ejemplo, mientras recarga en memoria un catálogo grande. Spring Boot permite publicar cambios de estado con AvailabilityChangeEvent:
@Component
public class RecargaCatalogo {

    private final ApplicationEventPublisher publisher;
    private final CatalogoLocal catalogo;

    public RecargaCatalogo(ApplicationEventPublisher publisher, CatalogoLocal catalogo) {
        this.publisher = publisher;
        this.catalogo = catalogo;
    }

    @Scheduled(cron = "0 0 3 * * *")
    public void recargar() {
        // Durante la recarga, la readiness falla y el Service deja de enviarnos tráfico
        AvailabilityChangeEvent.publish(publisher, this, ReadinessState.REFUSING_TRAFFIC);
        try {
            catalogo.recargarDesdeOrigen();
        } catch (CatalogoCorruptoException ex) {
            // Estado irrecuperable: que Kubernetes reinicie el contenedor
            AvailabilityChangeEvent.publish(publisher, ex, LivenessState.BROKEN);
            return;
        }
        AvailabilityChangeEvent.publish(publisher, this, ReadinessState.ACCEPTING_TRAFFIC);
    }
}
Es el mismo mecanismo de Spring Events aplicado a la disponibilidad: cualquier componente puede publicar el cambio y Actuator lo refleja en la probe correspondiente.
Requests, limits y la JVM: memoria y CPU sin sorpresas
Kubernetes usa los requests para decidir en qué nodo cabe un pod y los limits para cortarle los recursos. La JVM, por su parte, lee los límites del cgroup para dimensionarse. Que ambos encajen es la diferencia entre un servicio estable y uno que muere de forma intermitente.
Memoria: requests igual a limits. La memoria no se puede "estrangular" como la CPU: si un contenedor supera su límite, el kernel lo mata (OOMKilled). Si el request es menor que el limit, el pod puede acabar en un nodo sobrecomprometido donde, bajo presión, será de los primeros en ser desalojado. Con request = limit, sabes exactamente cuánta memoria tienes, y la JVM se dimensiona sobre esa cifra con -XX:MaxRAMPercentage=75, dejando el 25 % restante para metaspace, caché de código, stacks de hilos y buffers directos. Es el mismo razonamiento que explicamos en detalle para Docker; en Kubernetes simplemente el límite lo pone el manifiesto en vez de docker run --memory.
CPU: request sí, limit con cuidado. Un límite de CPU se aplica mediante cuotas del CFS: si el contenedor consume su cuota en los primeros milisegundos de un periodo, queda congelado (throttled) hasta el siguiente. La JVM es especialmente sensible a esto en el arranque (el JIT compila en varios hilos a la vez) y durante las pausas del GC. Por eso muchos equipos fijan solo el request de CPU y no ponen limit, o ponen uno generoso.
Pero quitar el límite tiene una consecuencia poco conocida: desde el cambio JDK-8281181 (JDK 19, con backports a versiones LTS anteriores), la JVM ya no usa los CPU shares derivados del request para calcular cuántos procesadores tiene. Sin limit de CPU, la JVM ve todos los núcleos del nodo: en un nodo de 32 núcleos, Runtime.availableProcessors() devuelve 32, y con eso dimensiona los hilos del GC, el ForkJoinPool común y los pools de muchas librerías. Por eso el Deployment de arriba fija -XX:ActiveProcessorCount=2: le dice a la JVM cuántos procesadores debe asumir, coherente con el request, sin imponer el throttling de un límite.
Una regla de partida razonable para un microservicio típico:
| Recurso | Request | Limit | JVM |
|---|---|---|---|
| Memoria | 1Gi | 1Gi | MaxRAMPercentage=75 |
| CPU | 500m–1 | sin límite o 2× request | ActiveProcessorCount ≈ request redondeado hacia arriba |
Mide antes de dar por buenos estos números: Actuator con Micrometer y Prometheus te da jvm.memory.used por área y el uso de CPU real, y es la única forma fiable de ajustar. Si usas Virtual Threads en Spring Boot, la memoria fuera del heap baja porque ya no hay cientos de hilos de plataforma con su stack reservado.
ConfigMaps y Secrets: configuración por entorno
La misma imagen debe correr en desarrollo, staging y producción; lo que cambia es la configuración, como pide el factor III de los doce factores de una aplicación cloud-native. Spring Boot lo pone fácil gracias al relaxed binding: cada variable de entorno en mayúsculas con guiones bajos se convierte en la propiedad equivalente.
# configmap.yaml
apiVersion: v1
kind: ConfigMap
metadata:
  name: pedidos-config
data:
  SPRING_PROFILES_ACTIVE: "prod"
  SPRING_DATASOURCE_URL: "jdbc:postgresql://postgres.datos.svc.cluster.local:5432/pedidos"
  SPRING_CONFIG_IMPORT: "optional:configtree:/run/secrets/pedidos/"
  LOGGING_LEVEL_ROOT: "INFO"
---
# secret.yaml (en la práctica, generado por Sealed Secrets, External Secrets o Vault)
apiVersion: v1
kind: Secret
metadata:
  name: pedidos-secret
type: Opaque
stringData:
  spring.datasource.username: "pedidos"
  spring.datasource.password: "cambia-esto"
El ConfigMap entra como variables de entorno con envFrom. El Secret, en cambio, se monta como volumen en /run/secrets/pedidos, y la propiedad spring.config.import=configtree: le dice a Spring Boot que cada fichero de ese directorio es una propiedad: el fichero spring.datasource.password con la contraseña dentro se convierte en esa propiedad. Montar los secretos como ficheros en vez de variables de entorno tiene dos ventajas: no aparecen en kubectl describe pod ni en volcados del entorno del proceso, y Kubernetes actualiza el fichero si el Secret cambia.
Ten presente que un Secret de Kubernetes solo está codificado en base64, no cifrado. No lo guardes tal cual en Git: usa Sealed Secrets, External Secrets Operator o un gestor como Vault. Y si ya tienes un servidor de configuración con Spring Cloud Config, puedes seguir usándolo, aunque en Kubernetes muchos equipos prefieren ConfigMaps versionados junto a los manifiestos con Kustomize o Helm.
Apagado ordenado: despliegues sin errores 502
Aquí está el origen de los errores intermitentes en cada despliegue. Cuando Kubernetes decide eliminar un pod (por un rolling update, un escalado hacia abajo o un drenado de nodo), ocurren dos cosas en paralelo: por un lado, el kubelet empieza a parar el contenedor; por otro, el control plane retira el pod de los endpoints del Service, y esa información tiene que propagarse a kube-proxy, al Ingress controller y, si lo hay, al service mesh. Esa propagación tarda unos segundos. Si la aplicación se cierra antes de que termine, los balanceadores siguen enviando peticiones a un pod que ya no escucha: conexiones rechazadas y errores 502 o 503.
La solución que recomienda la documentación de Spring Boot es un preStop con una pausa: el contenedor espera unos segundos antes de recibir SIGTERM, dando tiempo a que todos los balanceadores dejen de enviarle tráfico.
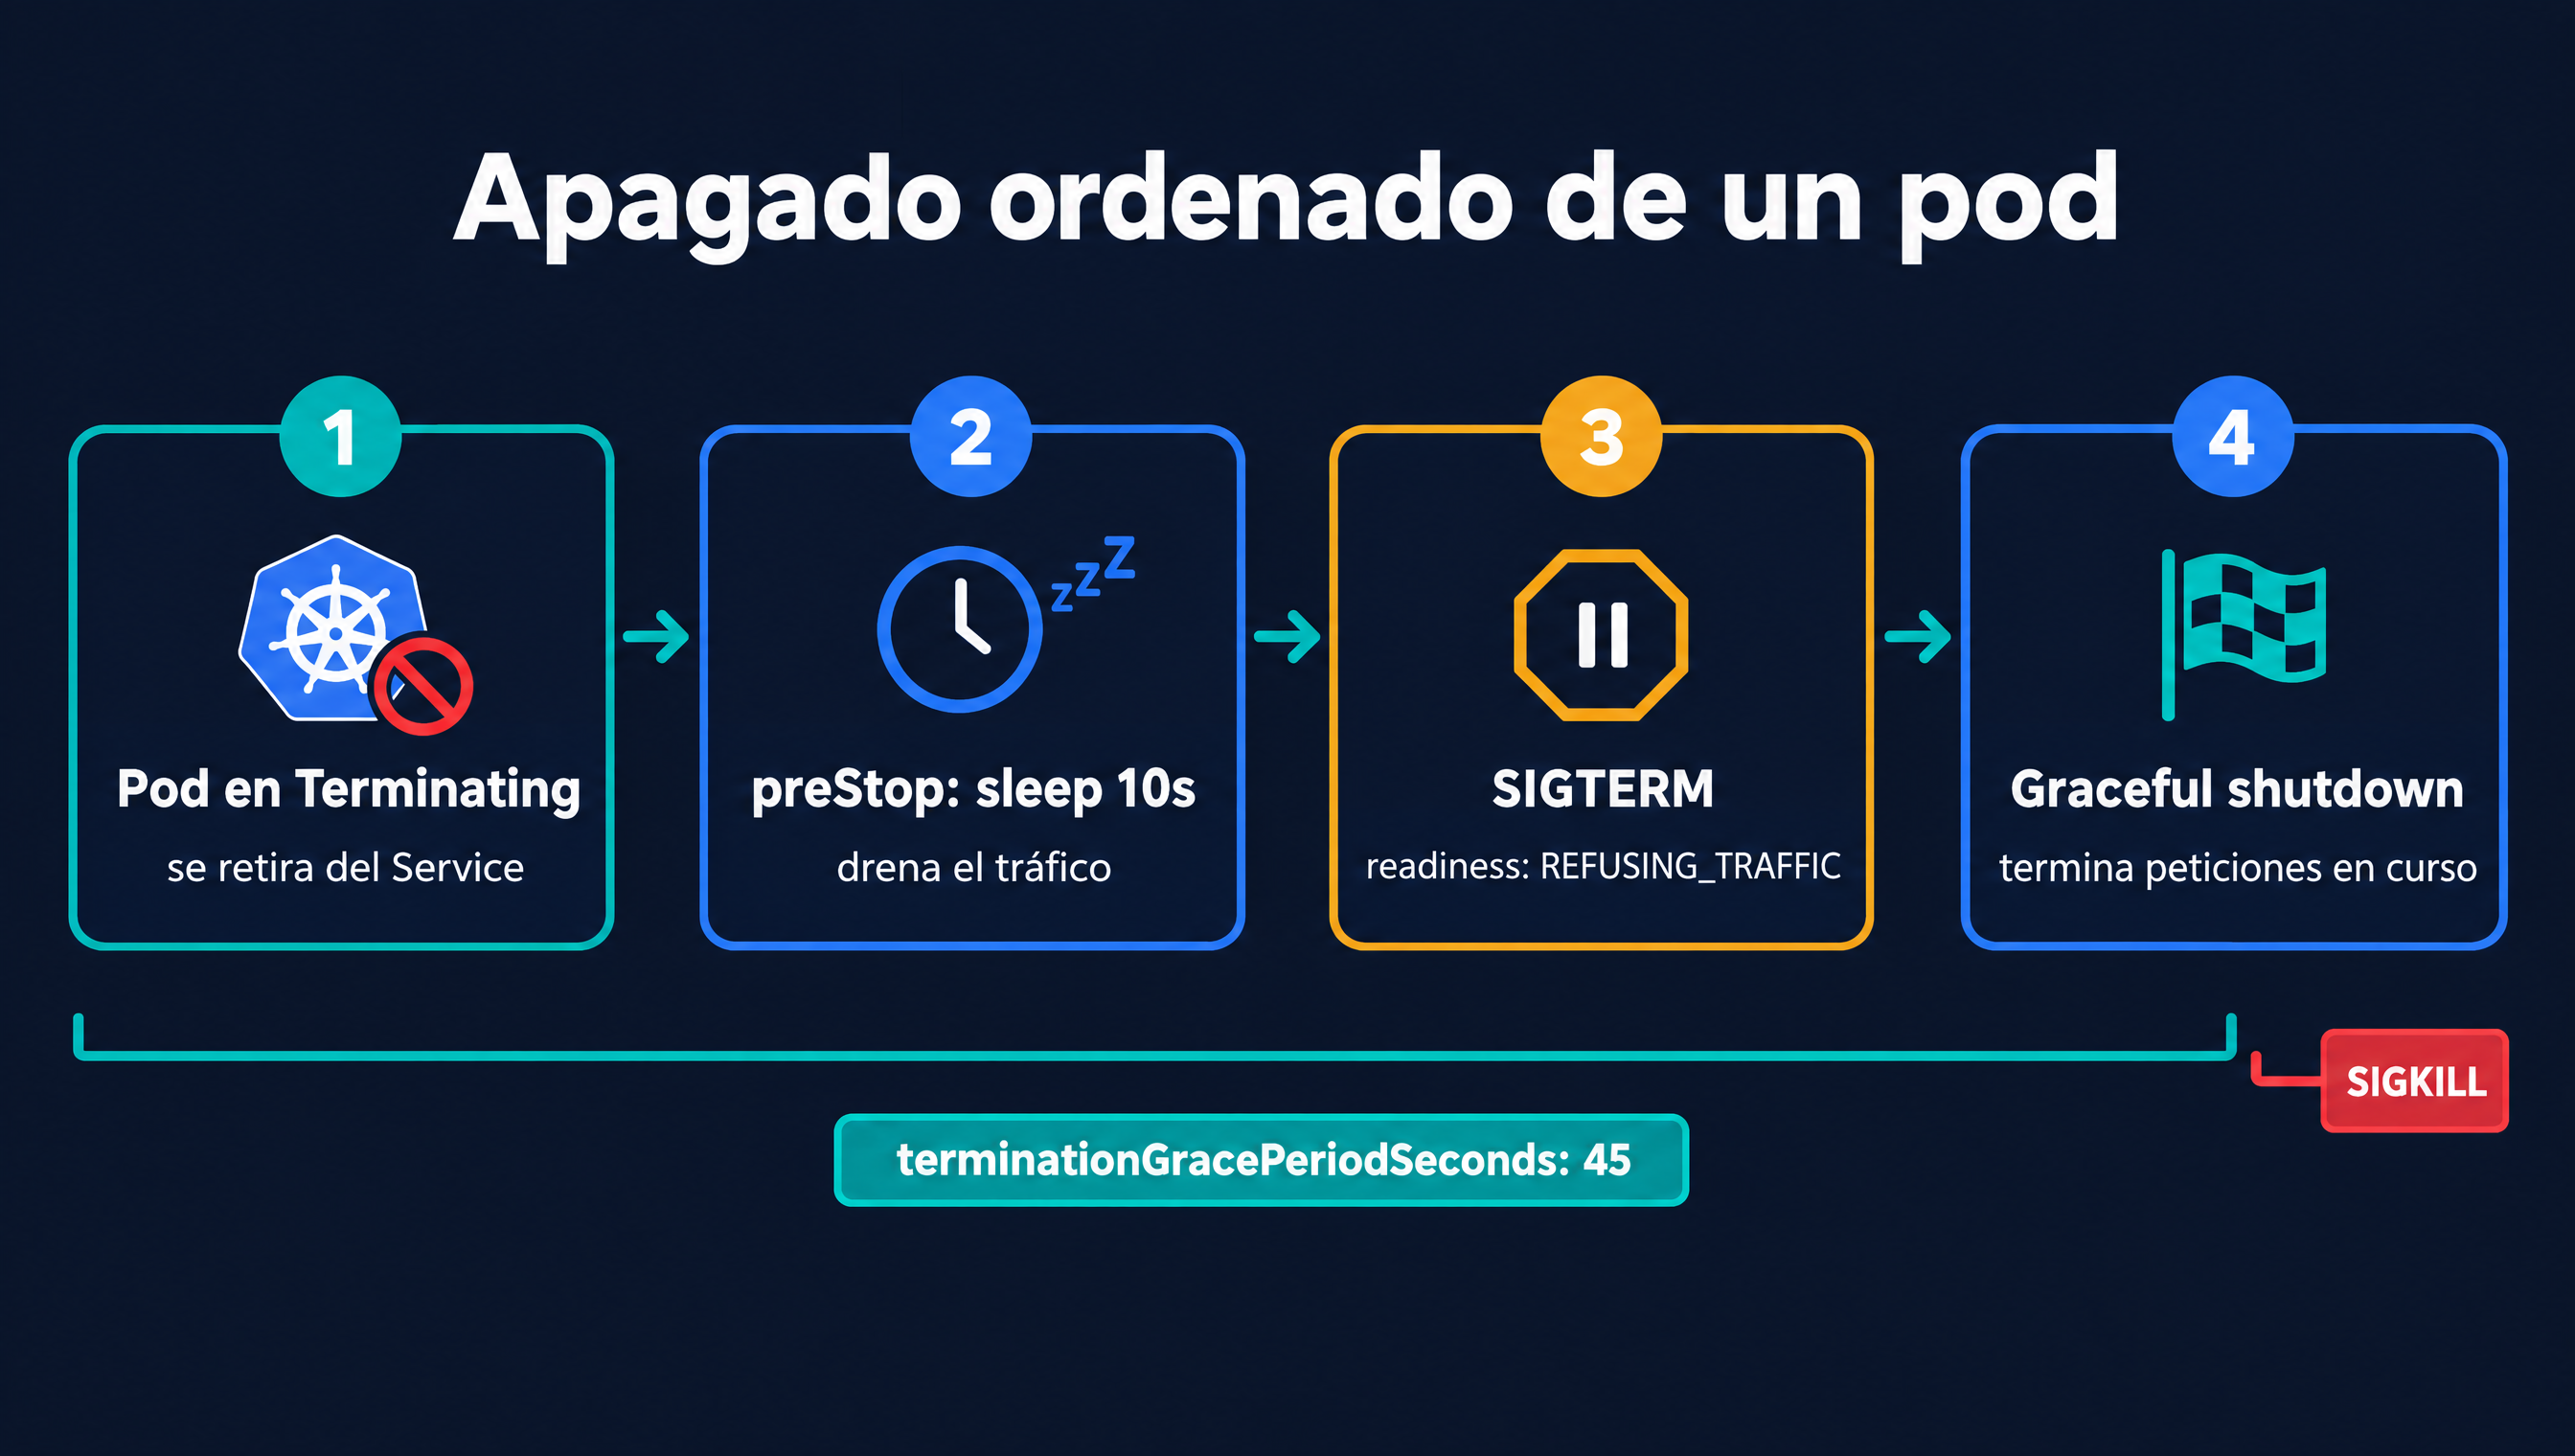
La secuencia completa queda así:
- El pod pasa a
Terminatingy empieza a retirarse de los endpoints del Service. - Se ejecuta el
preStop(sleep: 10). La aplicación sigue atendiendo las peticiones que aún le lleguen. - Kubernetes envía
SIGTERM. Spring Boot pasa la readiness aREFUSING_TRAFFICe inicia el graceful shutdown: el servidor web deja de aceptar conexiones nuevas y espera a que terminen las que están en curso, hastaspring.lifecycle.timeout-per-shutdown-phase(30 s en nuestra configuración). - Si al acabar
terminationGracePeriodSecondsel proceso sigue vivo, Kubernetes envíaSIGKILL.
La regla es que terminationGracePeriodSeconds debe ser mayor que la pausa del preStop más el timeout del apagado de Spring, con algo de margen: 10 + 30 + 5 = 45 en nuestro ejemplo. Por defecto Kubernetes concede solo 30 segundos, así que si subes el timeout de Spring sin tocar el del pod, el SIGKILL cortará las peticiones en curso.
La acción sleep nativa del preStop está disponible desde Kubernetes 1.32. En versiones anteriores necesitas la forma exec, que requiere que la imagen tenga un shell:
lifecycle:
  preStop:
    exec:
      command: ["sh", "-c", "sleep 10"]
Ojo si construiste la imagen con Buildpacks y el builder tiny: esas imágenes no tienen shell, así que en clústeres anteriores a 1.32 tendrás que usar otra imagen base o actualizar el clúster. Y recuerda que el ENTRYPOINT debe estar en forma exec para que SIGTERM llegue a la JVM y no se quede en un /bin/sh intermedio.
Rolling update, HPA y PodDisruptionBudget
Con maxUnavailable: 0 y maxSurge: 1, cada paso del rolling update crea un pod nuevo, espera a que su readiness sea correcta y solo entonces retira uno viejo. Combinado con el apagado ordenado, el despliegue no pierde capacidad ni peticiones. Para estrategias más avanzadas, como canary o blue-green, revisa las estrategias de despliegue Blue-Green, Canary y Rolling.
Autoescalado horizontal con HPA
El HorizontalPodAutoscaler ajusta las réplicas según métricas. Con la JVM hay que tener en cuenta el calentamiento: un pod recién arrancado consume mucha CPU mientras el JIT compila, lo que puede inflar la media y provocar escalados en cascada. Una ventana de estabilización y un ritmo de escalado moderado lo evitan:
# hpa.yaml
apiVersion: autoscaling/v2
kind: HorizontalPodAutoscaler
metadata:
  name: pedidos-service
spec:
  scaleTargetRef:
    apiVersion: apps/v1
    kind: Deployment
    name: pedidos-service
  minReplicas: 3
  maxReplicas: 10
  metrics:
    - type: Resource
      resource:
        name: cpu
        target:
          type: Utilization
          averageUtilization: 70   # porcentaje sobre el request de CPU
  behavior:
    scaleUp:
      stabilizationWindowSeconds: 60
      policies:
        - type: Pods
          value: 2                 # como mucho 2 pods nuevos por minuto
          periodSeconds: 60
    scaleDown:
      stabilizationWindowSeconds: 300
Dos advertencias. Primera: el porcentaje de utilización se calcula sobre el request de CPU, así que un request mal dimensionado hace que el HPA escale demasiado o nunca. Segunda: no escales por memoria con la JVM. El heap crece hasta su máximo y el GC no lo devuelve de inmediato al sistema, así que la memoria del pod rara vez baja aunque la carga lo haga; un HPA basado en memoria tiende a escalar y no desescalar nunca. Si la CPU no refleja bien tu carga (servicios muy limitados por E/S), escala por métricas de aplicación, como peticiones por segundo o tamaño de una cola, exportadas con Micrometer.
PodDisruptionBudget: disponibilidad durante el mantenimiento
El HPA protege frente a la carga; el PodDisruptionBudget protege frente al propio clúster. Cuando un administrador drena un nodo para actualizarlo, o el autoescalador de nodos consolida máquinas, Kubernetes desaloja pods. Sin PDB, puede desalojar todas tus réplicas a la vez si coinciden en los nodos drenados. Con él, el desalojo respeta un mínimo:
# pdb.yaml
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: pedidos-service
spec:
  maxUnavailable: 1     # como mucho una réplica fuera por disrupciones voluntarias
  selector:
    matchLabels:
      app: pedidos-service
El PDB solo cubre disrupciones voluntarias (drenados, actualizaciones); no protege frente a la caída de un nodo. Para eso, reparte las réplicas entre zonas o nodos con topologySpreadConstraints. Y no pongas maxUnavailable: 0 con pocas réplicas: bloquearás los drenados del clúster y el equipo de plataforma no te lo agradecerá.
¿Necesito Spring Cloud Kubernetes?
Spring Cloud Kubernetes permite que la aplicación lea ConfigMaps y Secrets directamente desde la API de Kubernetes, recargue la configuración en caliente y use el DiscoveryClient sobre los Services del clúster. Es útil si migras desde Eureka y Config Server y quieres mantener el mismo modelo de programación, o si necesitas recarga de configuración sin reiniciar pods.
Para la mayoría de servicios nuevos, sin embargo, no hace falta: el DNS de los Services cubre el descubrimiento, los ConfigMaps montados como variables o ficheros cubren la configuración, y un reinicio progresivo (kubectl rollout restart) aplica los cambios sin downtime. Menos dependencias significa también no tener que dar permisos sobre la API de Kubernetes a la cuenta de servicio de cada aplicación.
Errores frecuentes al desplegar Spring Boot en Kubernetes
- Liveness apuntando a
/actuator/health, que incluye dependencias externas. Un corte de la base de datos reinicia toda la flota. - Sin
startupProbey con una liveness agresiva: los pods se reinician en bucle (CrashLoopBackOff) en nodos lentos o tras añadir dependencias que alargan el arranque. -Xmxigual al límite de memoria: la memoria no-heap empuja el total por encima del límite y el contenedor termina enOOMKilled.- Sin
preStopo conterminationGracePeriodSecondsmenor que el apagado de Spring: errores 502 en cada despliegue. - Límites de CPU bajos que estrangulan el arranque y las pausas del GC, o sin límite y sin
ActiveProcessorCount, con la JVM creyendo que tiene todos los núcleos del nodo. - Etiqueta
latesten la imagen: los pods de un mismo Deployment pueden acabar ejecutando versiones distintas y el rollback no es fiable. - Secrets en Git en texto plano (o en base64, que es lo mismo).
- Exponer todos los endpoints de Actuator por el puerto principal y el Ingress. Limita la exposición o usa un puerto de gestión separado, accesible solo desde dentro del clúster.
Buenas prácticas
- Una imagen, muchos entornos. Nada específico del entorno dentro de la imagen; todo llega por ConfigMaps y Secrets.
- Probes separadas por responsabilidad: startup para el arranque, liveness solo para el estado interno, readiness para la capacidad de atender tráfico.
- Memoria con
request = limity heap por porcentaje. CPU conrequestrealista yActiveProcessorCountcoherente. - Apagado en tres capas:
preStopcon pausa,server.shutdown=gracefuly unterminationGracePeriodSecondsque cubra ambos. - Mínimo tres réplicas, PDB y reparto entre zonas para los servicios críticos.
- Manifiestos versionados con Kustomize o Helm, desplegados desde el pipeline o con GitOps (Argo CD, Flux), nunca con
kubectl applymanual en producción. - Observabilidad desde el primer día: métricas con Micrometer y Prometheus, logs a la salida estándar en formato estructurado y trazas distribuidas, como vimos en observabilidad en microservicios.
Preguntas frecuentes
¿Cómo desplegar una aplicación Spring Boot en Kubernetes?
Construye una imagen de contenedor de la aplicación, súbela a un registro y crea un Deployment que la ejecute con probes apuntando a /actuator/health/liveness y /actuator/health/readiness. Exponla con un Service y, si debe ser accesible desde fuera, con un Ingress. La configuración llega por ConfigMaps y Secrets, y se aplica con kubectl apply, Helm o una herramienta GitOps.
¿Cuál es la diferencia entre liveness y readiness probe?
La liveness probe indica si el proceso está en un estado irrecuperable: si falla, Kubernetes reinicia el contenedor. La readiness probe indica si puede atender tráfico ahora: si falla, el pod sale del balanceo del Service, pero sigue vivo. Por eso la liveness no debe depender de sistemas externos, y la readiness puede reflejar estados temporales.
¿Cuánta memoria y CPU asignar a un pod de Spring Boot?
No hay una cifra universal, pero un punto de partida habitual para un microservicio REST es 1 GiB de memoria (con request igual a limit) y entre 0,5 y 1 núcleo de CPU como request. Configura el heap con -XX:MaxRAMPercentage=75 en lugar de -Xmx y ajusta después con las métricas reales de Actuator y Prometheus.
¿Por qué mi pod de Spring Boot entra en CrashLoopBackOff?
Las causas más comunes son una liveness probe que empieza a comprobar antes de que la JVM termine de arrancar, un error de configuración que impide arrancar el contexto (una propiedad o un Secret que falta) o un OOMKilled por un límite de memoria demasiado ajustado. Revisa kubectl describe pod y kubectl logs --previous, y añade una startupProbe con margen suficiente.
¿Necesito Eureka o Spring Cloud Kubernetes en Kubernetes?
Normalmente no. Los Services de Kubernetes ya ofrecen un nombre DNS estable y balanceo entre los pods listos, así que cubren el descubrimiento de servicios. Spring Cloud Kubernetes tiene sentido si quieres recarga de configuración en caliente o mantener el modelo de programación de Spring Cloud durante una migración.
¿Cómo evitar errores durante un rolling update de Spring Boot?
Combina tres cosas: maxUnavailable: 0 en la estrategia del Deployment, un preStop con una pausa de unos 10 segundos para que los balanceadores dejen de enviar tráfico al pod, y el graceful shutdown de Spring Boot con un terminationGracePeriodSeconds mayor que la suma de la pausa y el timeout del apagado.
Conclusión
Llevar Spring Boot a Kubernetes no consiste en traducir un docker run a YAML. Consiste en que la aplicación y el orquestador se entiendan: que Kubernetes sepa cuándo la JVM ha terminado de arrancar, cuándo puede enviarle tráfico y cuándo debe dejar de hacerlo; y que la JVM sepa cuánta memoria y cuántos procesadores tiene de verdad. Spring Boot pone de su parte casi todo lo necesario —estados de disponibilidad, probes en Actuator, apagado ordenado, configuración por variables y ficheros—, pero hay que conectarlo con las piezas correctas del manifiesto.
Si te quedas con lo esencial: liveness solo con estado interno, startupProbe para el arranque, memoria con request = limit y heap por porcentaje, preStop más graceful shutdown dentro de un periodo de gracia suficiente, y PDB para los servicios que no pueden caer. Con eso, los reinicios en bucle, los OOMKilled y los 502 en cada despliegue dejan de ser parte de la rutina, y el clúster empieza a hacer lo que prometía: mover, escalar y reemplazar tus servicios sin que nadie lo note.