
OpenTelemetry con Spring Boot: trazas, métricas y logs de tus microservicios en un solo lugar
Un cliente se queja de que confirmar un pedido "a veces tarda ocho segundos". La petición entra por el gateway, pasa por pedidos-service, consulta inventario-service, cobra en pagos-service y publica un evento en Kafka. Cada servicio tiene sus logs y sus métricas en Actuator, pero ninguno sabe qué pasó en los demás. Buscar la causa significa abrir cinco pestañas, cruzar timestamps a ojo y esperar que los relojes estén sincronizados. OpenTelemetry con Spring Boot resuelve justo ese problema: cada petición lleva un identificador que viaja entre servicios, y trazas, métricas y logs llegan a un mismo backend donde puedes saltar de una a otra.
En el artículo sobre observabilidad en microservicios vimos la teoría de los tres pilares. Aquí pasamos a la práctica con Spring Boot 4.1: qué es OpenTelemetry y qué no es, las tres formas de integrarlo (y cuál elegir en 2026), cómo configurar el nuevo spring-boot-starter-opentelemetry para exportar todo por OTLP, cómo montar un OpenTelemetry Collector con Grafana, cómo controlar el muestreo para no arruinarte en almacenamiento y qué cambia al desplegarlo en Kubernetes o en una imagen nativa. Es la continuación natural de la serie sobre Spring Boot en Kubernetes: ya sabes desplegar; ahora toca ver qué pasa dentro.
¿Qué es OpenTelemetry?
OpenTelemetry (OTel) es un estándar abierto de la CNCF para generar, recopilar y exportar telemetría (trazas, métricas y logs) de forma independiente del proveedor. Define una API, un SDK por lenguaje, un protocolo de transporte llamado OTLP y un componente opcional, el Collector, que recibe, procesa y reenvía los datos a cualquier backend.
La idea importante es la última: OpenTelemetry no es un backend. No guarda ni dibuja nada. Es el "cable" estándar entre tus aplicaciones y la herramienta donde analizas los datos, sea Grafana, Jaeger, Datadog, New Relic o Elastic. Si instrumentas con OpenTelemetry y exportas por OTLP, cambiar de proveedor es cambiar una URL, no reescribir la instrumentación.
Tres conceptos que aparecen en todo lo que sigue:
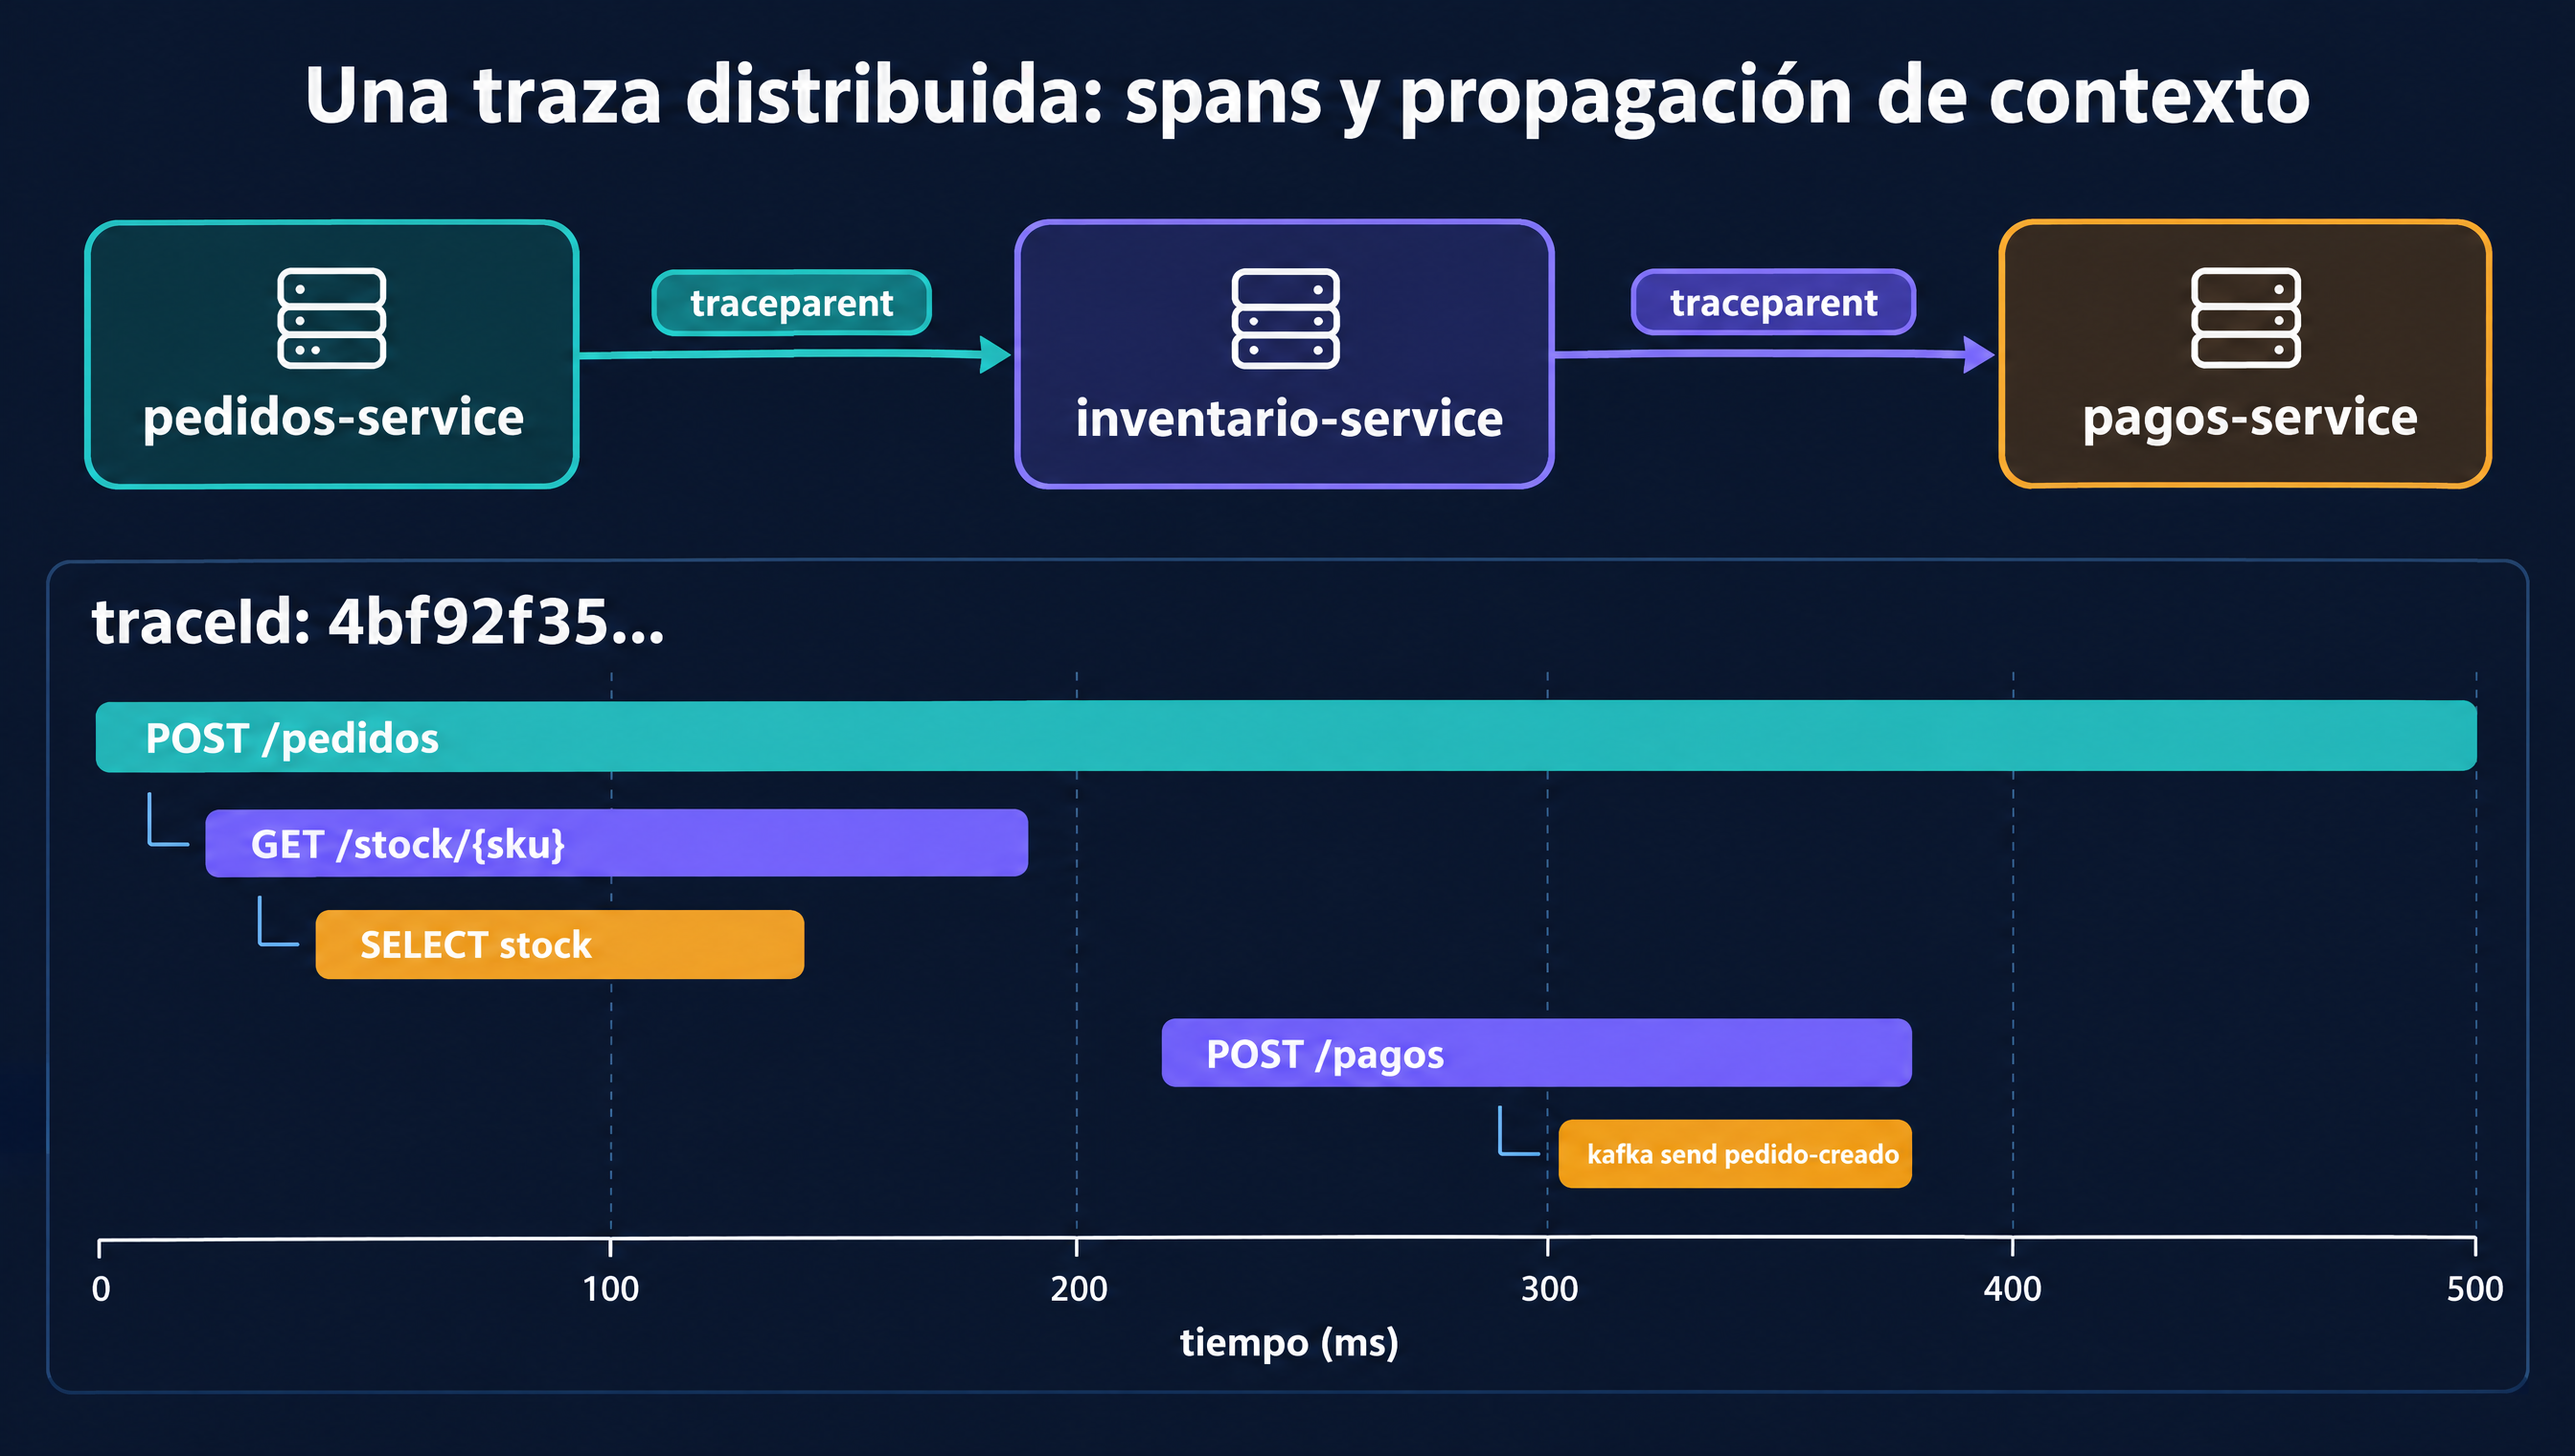
- Traza (trace): el recorrido completo de una petición por el sistema, identificado por un
traceIdde 128 bits. - Span: una operación dentro de la traza (una petición HTTP, una consulta SQL, el envío de un mensaje), con inicio, duración, atributos y un
spanId. Los spans forman un árbol padre-hijo. - Propagación de contexto: el mecanismo por el que el
traceIdviaja entre servicios, normalmente en la cabecera HTTPtraceparentdefinida por el estándar W3C Trace Context.
OpenTelemetry, Micrometer y Zipkin: quién es quién
En el ecosistema Spring hay una pieza más que conviene ubicar: Micrometer. Es la fachada de observabilidad de Spring desde hace años; Spring Boot Actuator la usa para las métricas y, desde Spring Boot 3, Micrometer Tracing para las trazas. Spring instrumenta su propio código (Spring MVC, WebFlux, RestClient, KafkaTemplate, Spring Data…) con la Observation API de Micrometer, y un bridge traduce esas observaciones a spans de OpenTelemetry.
Es decir: en Spring Boot no tienes que elegir entre Micrometer y OpenTelemetry. Micrometer instrumenta, OpenTelemetry transporta. Y Zipkin, que durante años fue el destino por defecto, va de salida: OpenTelemetry ha deprecado su exportador de Zipkin y la documentación de tracing de Spring Boot avisa de que esa autoconfiguración se eliminará en Spring Boot 4.2. Si hoy empiezas un proyecto, la respuesta es OTLP.
Las tres formas de usar OpenTelemetry en Spring Boot
Aquí está la confusión más habitual: casi todos los tutoriales mezclan tres enfoques distintos con dependencias parecidas.
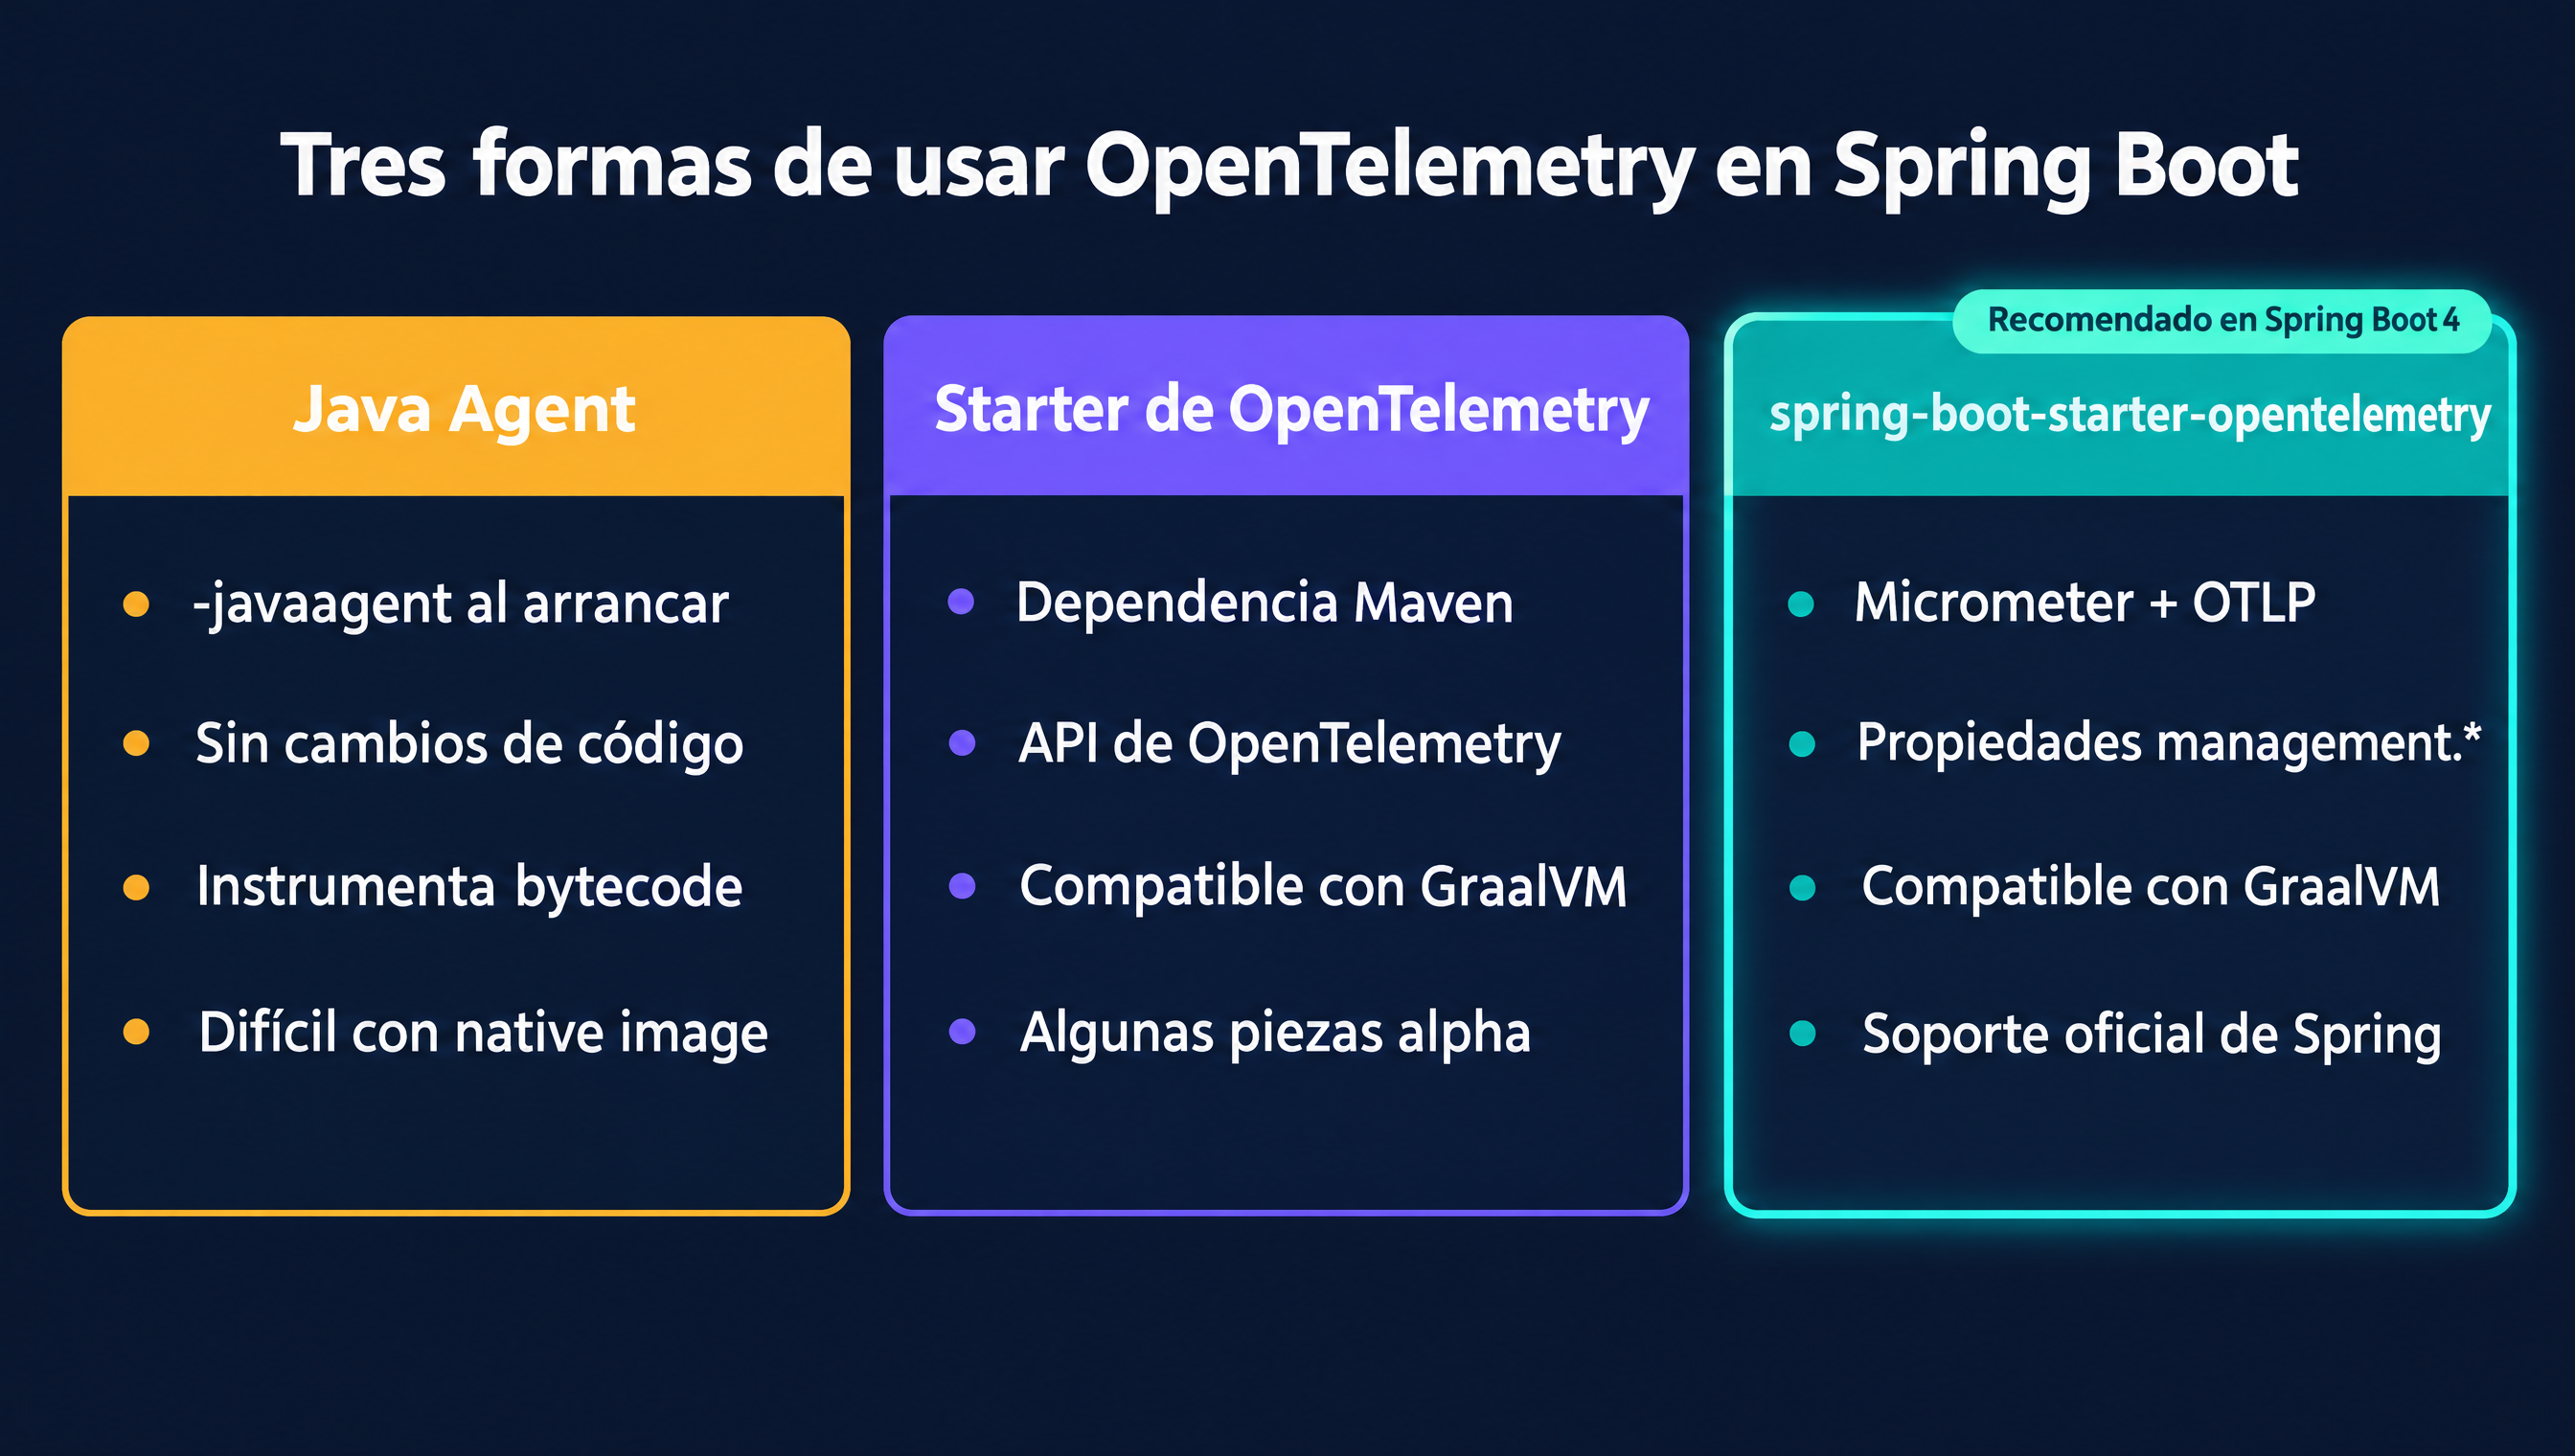
- OpenTelemetry Java Agent. Un jar que se añade al arranque con
-javaagent:opentelemetry-javaagent.jar. Modifica el bytecode de cientos de librerías para instrumentarlas sin tocar el código. Es lo que el proyecto OpenTelemetry recomienda por defecto en Java genérico y brilla en aplicaciones heredadas. A cambio, su compatibilidad depende de que las versiones de tus librerías coincidan con las que el agente sabe instrumentar, choca con otros agentes, añade tiempo de arranque y no funciona en una imagen nativa de GraalVM ni encaja bien con la caché AOT de la JVM. - Starter de OpenTelemetry para Spring Boot (
io.opentelemetry.instrumentation:opentelemetry-spring-boot-starter). Lo mantiene el proyecto OpenTelemetry: instrumentación por configuración, sin agente, usando la API de OTel directamente. Funciona con imágenes nativas, pero arrastra varias dependencias con sufijo-alphay convive regular con la instrumentación de Micrometer que Spring ya trae. spring-boot-starter-opentelemetry, el starter oficial de Spring Boot introducido en la versión 4.0. Reúne la API de OpenTelemetry, el bridge de Micrometer Tracing y los exportadores OTLP de métricas y trazas, todo configurable con propiedadesmanagement.*. El equipo de Spring lo presenta como su opción favorita en el anuncio de OpenTelemetry con Spring Boot.
| Criterio | Java Agent | Starter de OTel | spring-boot-starter-opentelemetry |
|---|---|---|---|
| Cambios en el código | Ninguno | Dependencia y propiedades | Dependencia y propiedades |
| Instrumentación | Bytecode, muy amplia | API de OTel | Observation API de Micrometer |
| Imagen nativa GraalVM | No | Sí | Sí |
| Mantenimiento | OpenTelemetry | OpenTelemetry | Spring Boot |
| Mejor para | Apps heredadas, Spring Boot 2 | Equipos que quieren la API de OTel pura | Proyectos Spring Boot 4 |
Mi recomendación: si estás en Spring Boot 4, usa el starter oficial. Es el que mejor convive con todo lo que Spring ya instrumenta, se configura igual que el resto de Actuator y no te ata a un agente. El resto del artículo se centra en él.
Cómo configurar OpenTelemetry con Spring Boot 4 paso a paso
1. Dependencias
<dependencies>
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-webmvc</artifactId>
    </dependency>
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-actuator</artifactId>
    </dependency>
    <!-- API de OpenTelemetry + bridge de Micrometer Tracing + exportadores OTLP -->
    <dependency>
        <groupId>org.springframework.boot</groupId>
        <artifactId>spring-boot-starter-opentelemetry</artifactId>
    </dependency>
    <!-- Solo si quieres exportar los logs por OTLP (ver más abajo) -->
    <dependency>
        <groupId>io.opentelemetry.instrumentation</groupId>
        <artifactId>opentelemetry-logback-appender-1.0</artifactId>
        <version>2.32.0-alpha</version>
    </dependency>
</dependencies>
Con solo el starter, la aplicación ya genera spans para cada petición HTTP entrante y saliente, métricas de JVM, HTTP y pools de hilos, y añade el traceId y el spanId a cada línea de log.
2. Configuración en application.yml
spring:
  application:
    name: pedidos-service   # se convierte en el service.name de la telemetría

management:
  tracing:
    sampling:
      probability: 1.0      # 100 % en local; en producción, mucho menos (ver "Sampling")
  otlp:
    metrics:
      export:
        url: http://localhost:4318/v1/metrics
        step: 30s           # cada cuánto se envían las métricas
  opentelemetry:
    resource-attributes:
      deployment.environment: local
      service.version: 1.4.2
    tracing:
      export:
        otlp:
          endpoint: http://localhost:4318/v1/traces
    logging:
      export:
        otlp:
          endpoint: http://localhost:4318/v1/logs
Dos detalles que causan la mitad de los "no me llegan las trazas": el puerto 4318 es OTLP sobre HTTP y el 4317 es OTLP sobre gRPC; y en HTTP la ruta de cada señal (/v1/traces, /v1/metrics, /v1/logs) forma parte de la URL. Si mezclas puerto y protocolo, la exportación falla sin hacer ruido.
Desde Spring Boot 4.1, además, la mayoría de las variables de entorno estándar de OpenTelemetry se traducen a estas propiedades: OTEL_SERVICE_NAME, OTEL_EXPORTER_OTLP_ENDPOINT, OTEL_TRACES_SAMPLER_ARG, OTEL_RESOURCE_ATTRIBUTES… Con OTEL_EXPORTER_OTLP_ENDPOINT=http://otel-collector:4318, Spring Boot añade por su cuenta /v1/traces, /v1/metrics y /v1/logs. Es muy cómodo en Kubernetes, donde muchas plataformas inyectan esas variables por defecto.
3. Exportar los logs por OTLP
Spring Boot configura el SDK de logs de OpenTelemetry, pero no conecta Logback con él: hace falta el appender de OpenTelemetry (todavía publicado como -alpha) y una pequeña clase que lo instale. Primero, src/main/resources/logback-spring.xml:
<?xml version="1.0" encoding="UTF-8"?>
<configuration>
    <!-- Mantiene la configuración por defecto de Spring Boot (consola, patrones...) -->
    <include resource="org/springframework/boot/logging/logback/base.xml"/>

    <appender name="OTEL"
              class="io.opentelemetry.instrumentation.logback.appender.v1_0.OpenTelemetryAppender">
        <!-- Copia el MDC (traceId, spanId, etc.) como atributos del log -->
        <captureMdcAttributes>*</captureMdcAttributes>
    </appender>

    <root level="INFO">
        <appender-ref ref="CONSOLE"/>
        <appender-ref ref="OTEL"/>
    </root>
</configuration>
Y después, el componente que le entrega al appender el OpenTelemetry configurado por Spring Boot:
@Component
class InstalarAppenderOpenTelemetry implements InitializingBean {

    private final OpenTelemetry openTelemetry;

    InstalarAppenderOpenTelemetry(OpenTelemetry openTelemetry) {
        this.openTelemetry = openTelemetry;
    }

    @Override
    public void afterPropertiesSet() {
        // Sin esta llamada el appender existe pero no envía nada:
        // los logs se quedan en la consola y nunca llegan al backend
        OpenTelemetryAppender.install(this.openTelemetry);
    }
}
Si ya recoges los logs de la salida estándar con Fluent Bit, Promtail o el agente de tu proveedor, este paso es opcional: el traceId ya aparece en cada línea gracias al patrón de correlación de Spring Boot y puedes saltar de la traza al log igualmente.
4. Un backend en local en un minuto: Grafana LGTM
Para desarrollo, la imagen grafana/otel-lgtm empaqueta en un solo contenedor un Collector de OpenTelemetry, Loki (logs), Tempo (trazas), Prometheus (métricas) y Grafana. Con el soporte de Docker Compose de Spring Boot, ni siquiera tienes que escribir las URLs: detecta el contenedor y configura los endpoints OTLP por ti.
# compose.yaml en la raíz del proyecto
services:
  lgtm:
    image: grafana/otel-lgtm:latest
    ports:
      - "3000:3000"   # Grafana
      - "4317:4317"   # OTLP gRPC
- "4318:4318" # OTLP HTTP<dependency>
<groupId>org.springframework.boot</groupId>
<artifactId>spring-boot-docker-compose</artifactId>
<optional>true</optional>
</dependency>Arranca con ./mvnw spring-boot:run, lanza unas cuantas peticiones y abre http://localhost:3000: en Explore → Tempo verás las trazas, y desde cada span puedes saltar a los logs de Loki con el mismo traceId. En producción fija la versión de la imagen en lugar de usar latest, como haces con cualquier otra dependencia. Si ya usas Testcontainers con Spring Boot, existe también un LgtmStackContainer para levantar el mismo stack en los tests de integración.
Propagación de contexto: que la traza no se rompa
Una traza distribuida solo es útil si es completa. El traceId vive en un ThreadLocal mientras la petición se procesa en un hilo, y viaja entre servicios en la cabecera traceparent. Hay tres sitios donde se pierde con facilidad.
Clientes HTTP creados con new. Spring Boot solo instrumenta los clientes que construye él. Si haces RestClient.create() o new RestTemplate(), la cabecera traceparent no se envía y la traza se parte en dos. Inyecta siempre el builder, como vimos en los clientes REST de Spring:
@Component
class InventarioClient {

    private final RestClient restClient;

    // RestClient.Builder viene preconfigurado con la observación de Micrometer:
    // cada llamada crea un span hijo y propaga traceparent al otro servicio
    InventarioClient(RestClient.Builder builder) {
        this.restClient = builder.baseUrl("http://inventario-service").build();
    }

    StockResponse consultarStock(String sku) {
        return restClient.get()
                .uri("/stock/{sku}", sku)
                .retrieve()
                .body(StockResponse.class);
    }
}
Mensajería. La observación de Kafka viene desactivada por defecto. Actívala en productor y consumidor para que el traceId viaje en las cabeceras del mensaje y el consumidor continúe la misma traza:
spring:
  kafka:
    template:
      observation-enabled: true
    listener:
      observation-enabled: true
En RabbitMQ las propiedades equivalentes son spring.rabbitmq.template.observation-enabled y spring.rabbitmq.listener.simple.observation-enabled. Si usas Spring Kafka con el patrón Outbox, recuerda que el evento lo publica otro proceso más tarde: guarda el traceparent junto al evento en la tabla outbox y restáuralo al publicar, o tendrás dos trazas inconexas.
Hilos propios. En Spring Boot 4.1 el contexto se propaga automáticamente a los métodos @Async del ejecutor autoconfigurado. Si creas tus propios ExecutorService, envuélvelos con ContextExecutorService.wrap(...) de la librería context-propagation de Micrometer. Con virtual threads la regla es la misma: el problema no es el tipo de hilo, sino cambiar de hilo sin copiar el contexto.
Devolver el traceId al cliente
Un truco barato y muy útil en soporte: devolver el traceId en una cabecera de respuesta. Cuando un usuario reporta un error, te da ese identificador y vas directo a la traza.
@Component
class TraceIdResponseFilter extends OncePerRequestFilter {

    private final Tracer tracer; // io.micrometer.tracing.Tracer

    TraceIdResponseFilter(Tracer tracer) {
        this.tracer = tracer;
    }

    @Override
    protected void doFilterInternal(HttpServletRequest request, HttpServletResponse response,
                                    FilterChain chain) throws ServletException, IOException {
        Span span = tracer.currentSpan();
        if (span != null) {
            response.setHeader("X-Trace-Id", span.context().traceId());
        }
        chain.doFilter(request, response);
    }
}
Combínalo con tu manejo de excepciones con @ControllerAdvice para incluir el mismo identificador en el cuerpo de los errores ProblemDetail.
Instrumentación personalizada: spans de negocio
Lo automático cubre la "fontanería" (HTTP, mensajería, base de datos si añades la instrumentación de JDBC). Lo que nunca sabrá un framework es qué operaciones son importantes para tu negocio. Para eso está la Observation API, que genera a la vez un span y una métrica de tiempo:
@Service
class CheckoutService {

    private final ObservationRegistry registry;
    private final PagosClient pagosClient;

    CheckoutService(ObservationRegistry registry, PagosClient pagosClient) {
        this.registry = registry;
        this.pagosClient = pagosClient;
    }

    Recibo confirmar(Pedido pedido) {
        return Observation.createNotStarted("checkout.confirmar", registry)
                // Baja cardinalidad: va a métricas Y trazas (pocos valores posibles)
                .lowCardinalityKeyValue("metodo.pago", pedido.metodoPago().name())
                // Alta cardinalidad: solo a trazas (un valor por pedido)
                .highCardinalityKeyValue("pedido.id", pedido.id().toString())
                .observe(() -> pagosClient.cobrar(pedido));
    }
}
La distinción entre baja y alta cardinalidad es crítica. Un identificador de pedido como etiqueta de métrica crea una serie temporal nueva por pedido y tumba Prometheus en horas; como atributo de un span no cuesta nada. Si prefieres anotaciones, @Observed(name = "checkout.confirmar") hace lo mismo, pero necesita spring-boot-starter-aspectj y la propiedad management.observations.annotations.enabled=true. No anotes métodos que Spring ya instrumenta (controladores, repositorios): tendrás observaciones duplicadas.
Para la base de datos, Spring Boot no instrumenta JDBC por defecto. La librería datasource-micrometer-spring-boot (proyecto net.ttddyy.observation) añade un span por consulta y conexión, que es exactamente lo que necesitas para encontrar el N+1 que hace lento el checkout.
El OpenTelemetry Collector en producción
En local, enviar la telemetría directamente al backend es cómodo. En producción, casi siempre conviene poner en medio un OpenTelemetry Collector: un proceso independiente que recibe OTLP, procesa los datos y los reenvía a uno o varios destinos.
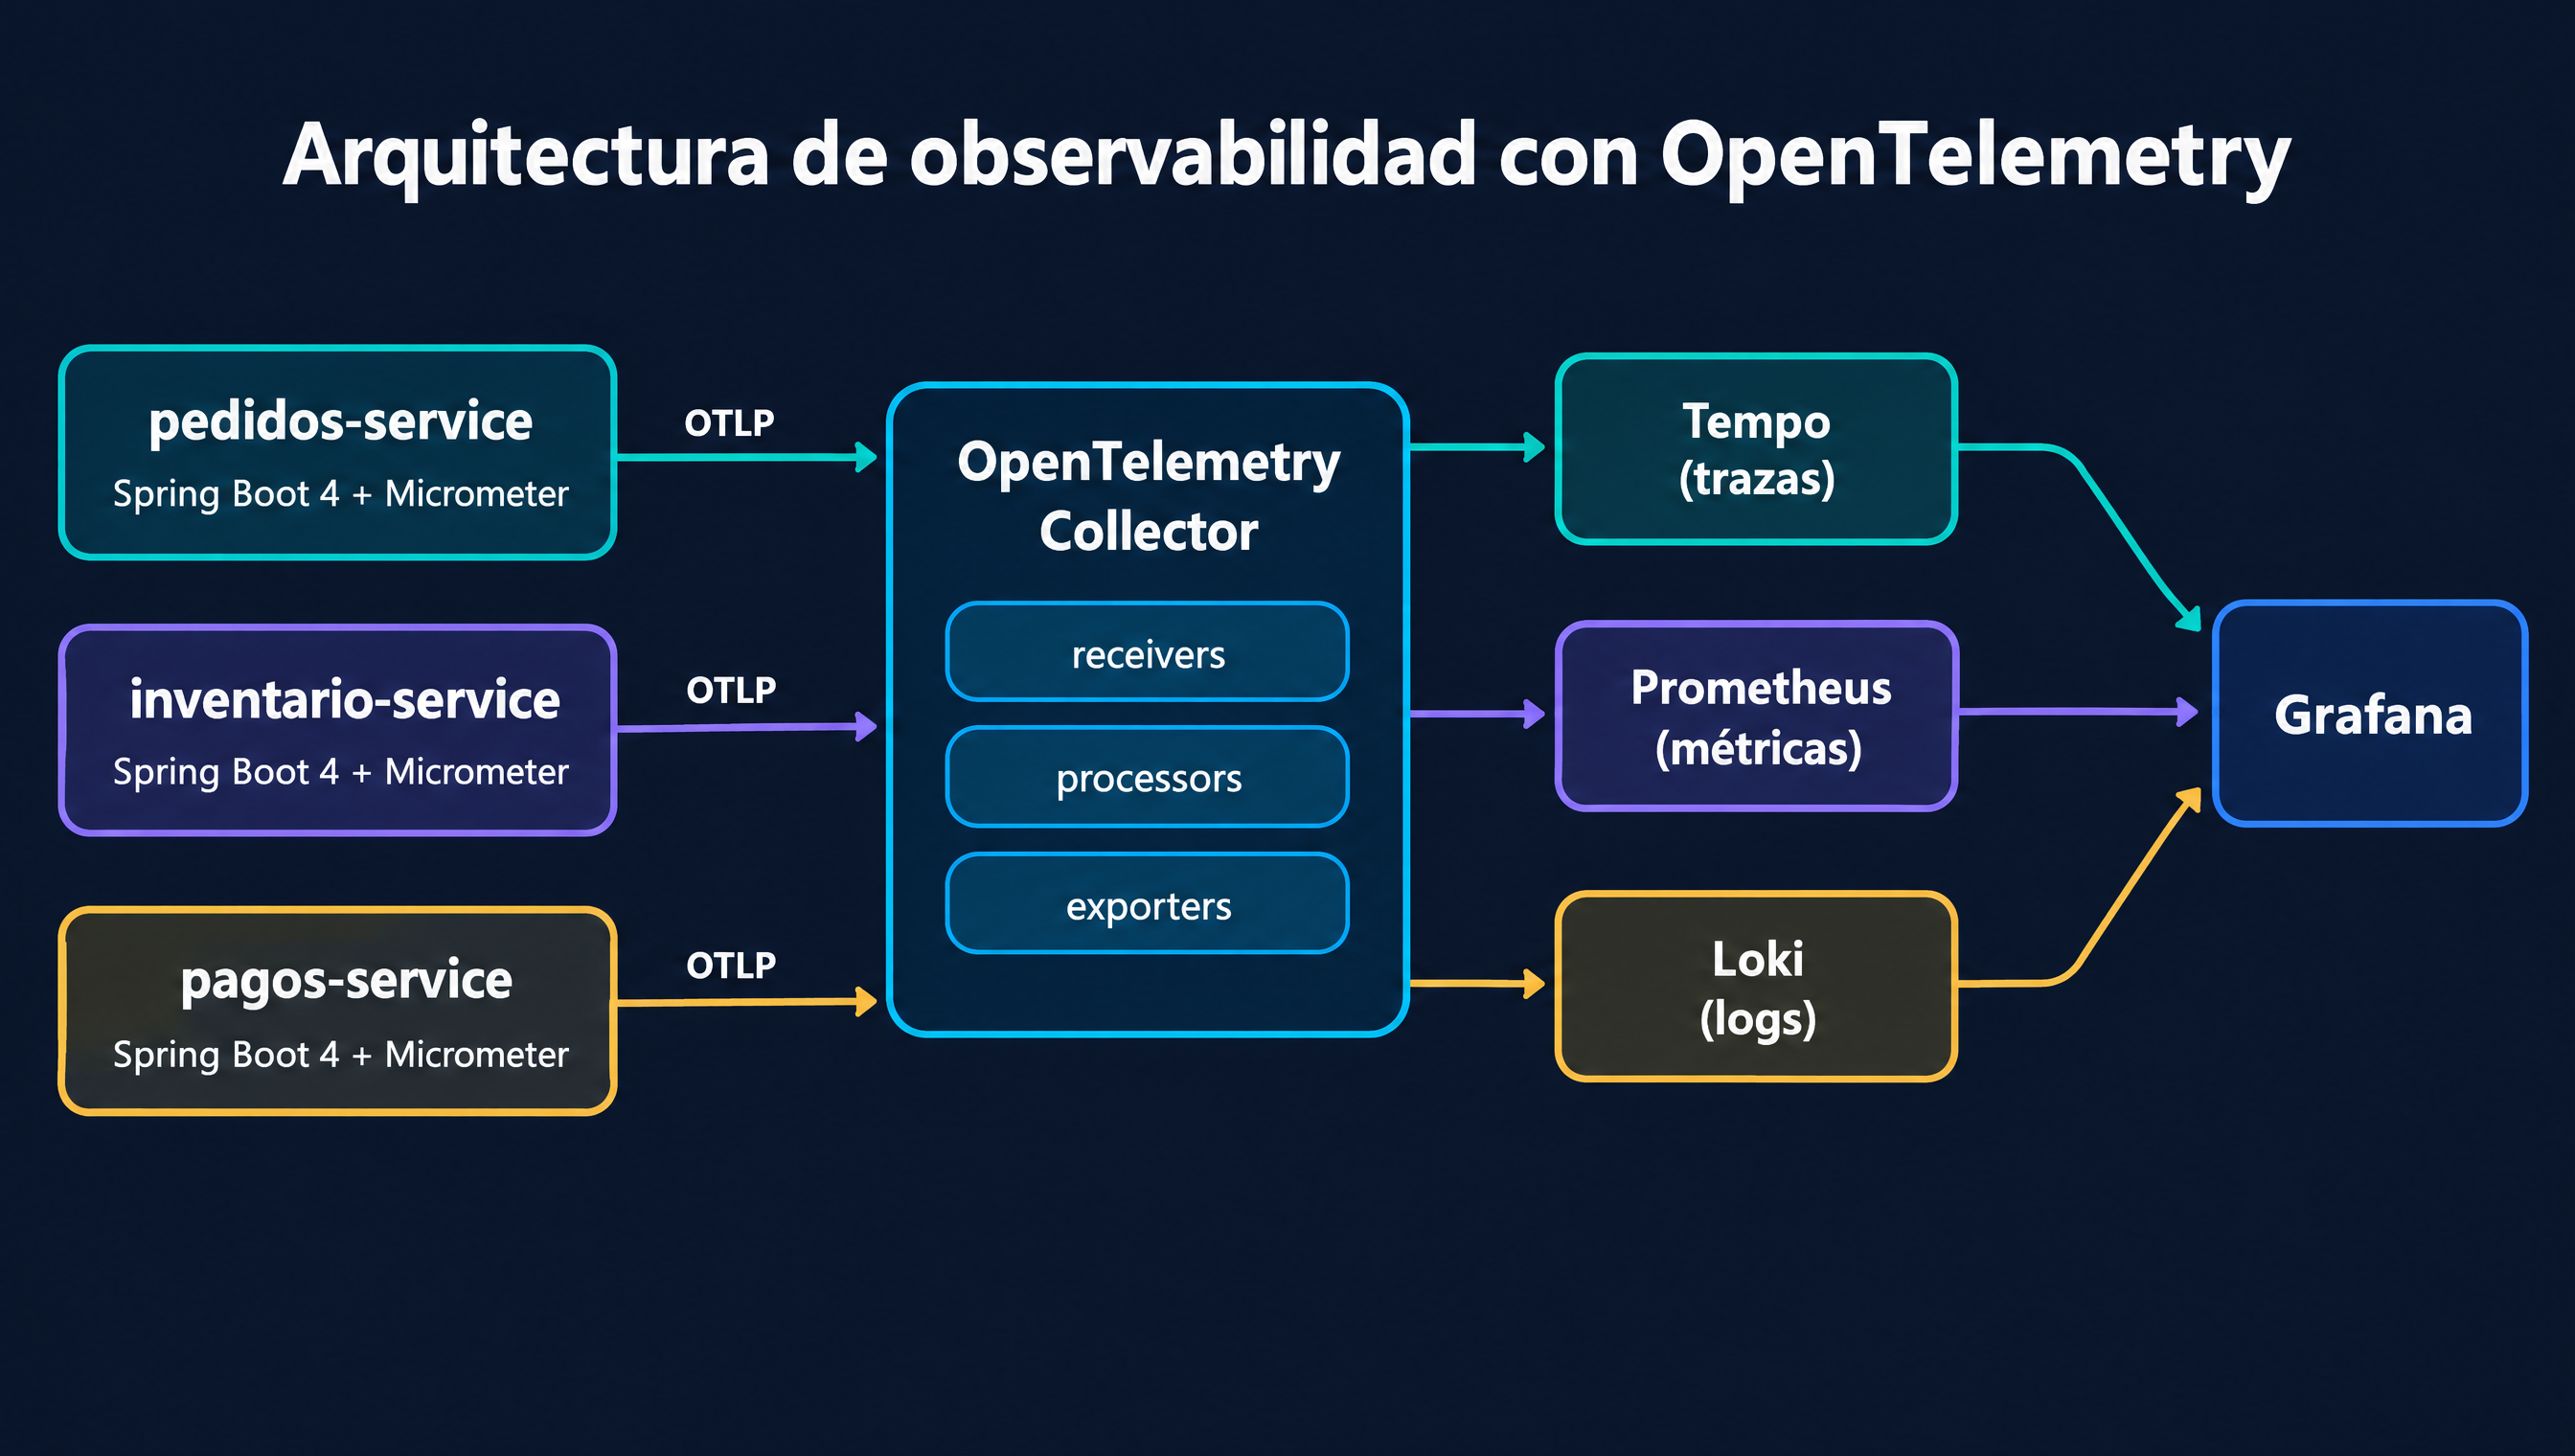
Las razones para usarlo:
- Desacopla las aplicaciones del backend. Los servicios solo conocen
otel-collector:4318. Cambiar de Tempo a otro proveedor, o enviar a dos a la vez durante una migración, es un cambio en el Collector, no un despliegue de cada microservicio. - Procesa en un solo sitio: agrupar en lotes, reintentar, filtrar datos sensibles, añadir atributos de Kubernetes y aplicar tail sampling.
- Saca trabajo de la aplicación: si el backend va lento, el que acumula y reintenta es el Collector, no tu servicio.
Una configuración mínima pero realista:
# otel-collector.yaml
receivers:
  otlp:
    protocols:
      grpc:
        endpoint: 0.0.0.0:4317
      http:
        endpoint: 0.0.0.0:4318

processors:
  # Protege al Collector de quedarse sin memoria ante picos
  memory_limiter:
    check_interval: 1s
    limit_percentage: 80
    spike_limit_percentage: 25
  # Elimina datos sensibles antes de que salgan del clúster
  attributes/sin-pii:
    actions:
      - key: http.request.header.authorization
        action: delete
      - key: user.email
        action: hash
  batch: {}

exporters:
  otlp/tempo:
    endpoint: tempo:4317
    tls:
      insecure: true
  otlphttp/loki:
    endpoint: http://loki:3100/otlp
  otlphttp/prometheus:
    # Prometheus 3 acepta OTLP con --web.enable-otlp-receiver
    endpoint: http://prometheus:9090/api/v1/otlp

service:
  pipelines:
    traces:
      receivers: [otlp]
      processors: [memory_limiter, attributes/sin-pii, batch]
      exporters: [otlp/tempo]
    metrics:
      receivers: [otlp]
      processors: [memory_limiter, batch]
      exporters: [otlphttp/prometheus]
    logs:
      receivers: [otlp]
      processors: [memory_limiter, attributes/sin-pii, batch]
      exporters: [otlphttp/loki]
El orden de los procesadores importa: memory_limiter siempre primero y batch al final. La documentación del Collector detalla cada componente; los procesadores avanzados como tail_sampling o k8sattributes están en la distribución contrib.
Sampling: cuántas trazas guardar
Guardar el 100 % de las trazas de un sistema con miles de peticiones por segundo es caro y, la mayoría de las veces, inútil: el 99 % de esas trazas son peticiones correctas e idénticas. Por eso existe el muestreo. Spring Boot muestrea por defecto solo el 10 % de las peticiones, con un sampler parent-based-trace-id-ratio configurable en management.opentelemetry.tracing.sampler.
Hay dos estrategias, y en producción suelen combinarse:
- Head sampling (en la aplicación). La decisión se toma al empezar la traza, con
management.tracing.sampling.probability. Es barato y, al ser parent-based, coherente: si el primer servicio decide muestrear, todos los demás respetan la decisión y la traza llega completa. Su límite es que decide antes de saber si la petición va a fallar. - Tail sampling (en el Collector). El Collector espera a que la traza termine y decide con toda la información: guardar todas las que tienen errores, todas las que superan un umbral de latencia y solo un porcentaje de las demás.
# Fragmento del Collector (distribución contrib)
processors:
  tail_sampling:
    decision_wait: 10s
    policies:
      - name: errores
        type: status_code
        status_code: { status_codes: [ERROR] }
      - name: lentas
        type: latency
        latency: { threshold_ms: 2000 }
      - name: resto
        type: probabilistic
        probabilistic: { sampling_percentage: 5 }
Si usas tail sampling, envía el 100 % desde las aplicaciones (probability: 1.0) y deja que el Collector filtre. Y con varias réplicas del Collector, todos los spans de una traza deben llegar a la misma réplica: se resuelve con un primer nivel de Collectors que reparte por traceId (el exportador loadbalancing). Es la parte más delicada de operar OpenTelemetry a escala.
OpenTelemetry en Kubernetes
Si despliegas como vimos en el artículo de Spring Boot en Kubernetes, el patrón más común es un Collector como DaemonSet (uno por nodo, recibe de los pods de ese nodo y añade metadatos del pod) más, opcionalmente, un Deployment central para el tail sampling. La configuración del servicio se reduce a variables de entorno:
env:
  - name: OTEL_SERVICE_NAME
    value: pedidos-service
  - name: NODE_IP
    valueFrom:
      fieldRef:
        fieldPath: status.hostIP
  # El Collector del DaemonSet escucha en el puerto del host de cada nodo
  - name: OTEL_EXPORTER_OTLP_ENDPOINT
    value: http://$(NODE_IP):4318
  - name: OTEL_RESOURCE_ATTRIBUTES
    value: deployment.environment=prod,service.version=1.4.2
  - name: OTEL_TRACES_SAMPLER_ARG
    value: "1.0"   # el muestreo real lo hace el Collector con tail sampling
Dos notas más. El OpenTelemetry Operator puede inyectar el Java Agent automáticamente con una anotación en el pod; es práctico para servicios que no controlas, pero si ya usas el starter de Spring Boot no lo actives a la vez o duplicarás spans. Y si usas un service mesh como Istio, el mesh también genera spans de red: ambos se integran en la misma traza siempre que la aplicación propague traceparent, que es lo que ya hace el starter.
En cuanto a las imágenes nativas, aquí el starter oficial tiene una ventaja clara sobre el agente: no depende de manipular bytecode en ejecución, así que funciona en una Spring Boot native image con GraalVM con las mismas propiedades.
Coste, rendimiento y riesgos
OpenTelemetry no es gratis, y conviene saber dónde están los costes antes de activarlo en todo:
- Overhead en la aplicación. Crear spans y exportarlos en lotes es barato, pero no nulo: algo de CPU, memoria para la cola del exportador y tráfico de red. Con muestreo razonable suele ser imperceptible; con el 100 % y spans en bucles internos, deja de serlo.
- Coste de almacenamiento. Es la factura que más crece. Las trazas y los logs se pagan por volumen, y las métricas por número de series temporales. La cardinalidad descontrolada en métricas es el error más caro.
- Datos sensibles. Cabeceras, parámetros de URL y logs pueden contener tokens, correos o números de documento. Filtra en el Collector y revisa qué atributos añades a mano.
- Piezas aún inmaduras. El appender de Logback sigue en
-alphay la exportación de logs es la señal más reciente del ecosistema. Fija versiones y prueba las actualizaciones. - Dependencia operativa. Si el Collector cae, pierdes visibilidad justo cuando más la necesitas. Despliégalo con réplicas, límites de memoria y su propia monitorización.
¿Cuándo usar OpenTelemetry y cuándo no?
Úsalo si tienes más de dos o tres servicios que se llaman entre sí, si los incidentes acaban en "no sabemos dónde se va el tiempo", si quieres evitar quedarte atado a un proveedor de APM o si ya estás en Spring Boot 4, donde el coste de entrada es una dependencia y cuatro propiedades.
Puede esperar si tienes un monolito, incluso uno modular con Spring Modulith, donde Actuator, Prometheus y buenos logs cubren casi todo; o si tu proveedor actual de APM ya instrumenta todo con su agente y el equipo no tiene intención de cambiar. Aun así, exportar por OTLP te deja la puerta abierta: la mayoría de proveedores comerciales ya aceptan OTLP de forma nativa.
Buenas prácticas
- Nombra bien los servicios.
spring.application.nameuOTEL_SERVICE_NAMEes la clave por la que filtrarás todo. Añadeservice.versionydeployment.environmentcomo atributos de recurso. - Inyecta siempre los builders de
RestClient,WebClientyRestTemplate, y activa la observación de Kafka y RabbitMQ. - Usa un Collector entre las aplicaciones y el backend en cualquier entorno compartido.
- Decide el muestreo con intención: head sampling bajo si el presupuesto manda, tail sampling si necesitas todas las trazas con errores.
- Vigila la cardinalidad: identificadores únicos solo como atributos de alta cardinalidad, nunca como etiquetas de métrica.
- Correlaciona las tres señales:
traceIden los logs, exemplars en las métricas de latencia y enlaces de Tempo a Loki en Grafana. El valor de OpenTelemetry está en saltar de una señal a otra. - Filtra datos sensibles en el Collector y no confíes en que cada equipo lo haga en su código.
- Devuelve el
traceIdal cliente en una cabecera y en los errores: convierte cada ticket de soporte en un enlace a una traza.
Preguntas frecuentes
¿Qué es OpenTelemetry en Spring Boot?
Es la forma estándar de exportar trazas, métricas y logs de una aplicación Spring Boot a cualquier backend de observabilidad. En Spring Boot 4, el starter spring-boot-starter-opentelemetry traduce la instrumentación de Micrometer a OpenTelemetry y la envía por el protocolo OTLP, configurable con propiedades management.*.
¿OpenTelemetry Java Agent o starter de Spring Boot?
En proyectos con Spring Boot 4, el starter oficial: se integra con la instrumentación que Spring ya trae, se configura con propiedades y funciona con imágenes nativas de GraalVM. El Java Agent es mejor opción para aplicaciones heredadas que no puedes modificar o versiones antiguas de Spring Boot.
¿Qué diferencia hay entre Micrometer y OpenTelemetry?
Micrometer es la fachada de instrumentación que usa Spring: genera observaciones, métricas y spans desde el código del framework. OpenTelemetry es el estándar de transporte y el SDK que exporta esos datos por OTLP. En Spring Boot trabajan juntos: Micrometer instrumenta y OpenTelemetry exporta.
¿Por qué no veo todas las trazas en Grafana Tempo?
Lo más habitual es el muestreo: Spring Boot solo guarda el 10 % de las peticiones por defecto, así que en desarrollo conviene subir management.tracing.sampling.probability a 1.0. Si las trazas aparecen partidas, revisa que los clientes HTTP se creen con los builders inyectados y que la observación de Kafka esté activada.
¿Necesito un OpenTelemetry Collector?
No es obligatorio: las aplicaciones pueden enviar OTLP directamente al backend. Pero en producción es muy recomendable, porque desacopla los servicios del proveedor, centraliza el filtrado de datos sensibles y permite tail sampling, reintentos y envío a varios destinos sin desplegar de nuevo cada microservicio.
¿OpenTelemetry reemplaza a Zipkin y Prometheus?
Reemplaza a sus formatos de envío, no necesariamente a los backends. Zipkin como exportador está deprecado y Spring Boot 4.2 eliminará su autoconfiguración, así que lo recomendable es enviar por OTLP. Prometheus sigue siendo un backend válido de métricas y puede recibir OTLP directamente o a través del Collector.
Conclusión
OpenTelemetry con Spring Boot ha dejado de ser un proyecto de integración para convertirse en una dependencia y unas pocas propiedades. Spring Boot 4 trae su propio starter, Micrometer ya instrumenta casi todo lo que usas (HTTP, clientes REST, mensajería, seguridad) y OTLP te permite elegir backend sin tocar el código. Lo que sigue exigiendo criterio no es la configuración, sino las decisiones de operación: cuánto muestrear, dónde filtrar datos sensibles, cómo controlar la cardinalidad y cómo mantener la traza intacta al cruzar hilos, colas y procesos.
Si te quedas con lo esencial: usa spring-boot-starter-opentelemetry, inyecta los builders de los clientes HTTP, activa la observación de la mensajería, pon un Collector entre tus servicios y el backend y empieza con Grafana LGTM en local para ver tus primeras trazas hoy mismo. La próxima vez que alguien diga "a veces tarda ocho segundos", no abrirás cinco pestañas: abrirás una traza.


