
Spring Boot native image con GraalVM: arranque en milisegundos sin sorpresas en producción
Una aplicación Spring Boot típica tarda varios segundos en arrancar y necesita cientos de megas de memoria antes de atender la primera petición. En un servidor que se reinicia una vez al mes da igual. En Kubernetes, donde el autoescalado crea réplicas justo cuando llega el pico, o en plataformas serverless que arrancan una instancia por petición, esos segundos y esos megas son latencia para el usuario y dinero en la factura. La promesa de una Spring Boot native image con GraalVM es exactamente esa: compilar la aplicación a un ejecutable que arranca en decenas de milisegundos y ocupa una fracción de la memoria.
La promesa es real, pero viene con letra pequeña: builds de varios minutos, librerías que fallan en tiempo de ejecución porque usan reflexión, perfiles de Spring que dejan de comportarse como esperas y un rendimiento pico que no siempre iguala al de la JVM. En los dos artículos anteriores vimos cómo dockerizar Spring Boot para producción y cómo desplegar Spring Boot en Kubernetes sobre la JVM. Aquí completamos la serie con la alternativa nativa: qué ocurre durante la compilación, cómo construir la imagen con Spring Boot 4.1 y GraalVM 25, cómo resolver los problemas de reflexión y perfiles, y, sobre todo, cuándo merece la pena frente a la caché AOT de Java 25.
¿Qué es una native image en Spring Boot?
Una native image de Spring Boot es un ejecutable específico de una plataforma (por ejemplo, Linux x86-64), generado por la herramienta native-image de GraalVM a partir de la aplicación y de todas sus dependencias. Se compila ahead-of-time, no necesita una JVM para ejecutarse, arranca en milisegundos y consume mucha menos memoria que la misma aplicación sobre la JVM.
La diferencia de fondo está en cuándo se hace el trabajo. En la JVM, las clases se cargan bajo demanda, el bytecode se interpreta al principio y el compilador JIT optimiza los caminos calientes a medida que la aplicación se usa. En una imagen nativa todo eso ocurre en la compilación: GraalVM parte del método main, analiza estáticamente qué código es alcanzable, lo compila a código máquina y descarta el resto. Lo que llega a producción es un binario con exactamente el código que se puede ejecutar, ya compilado y con parte del heap inicializado de antemano.
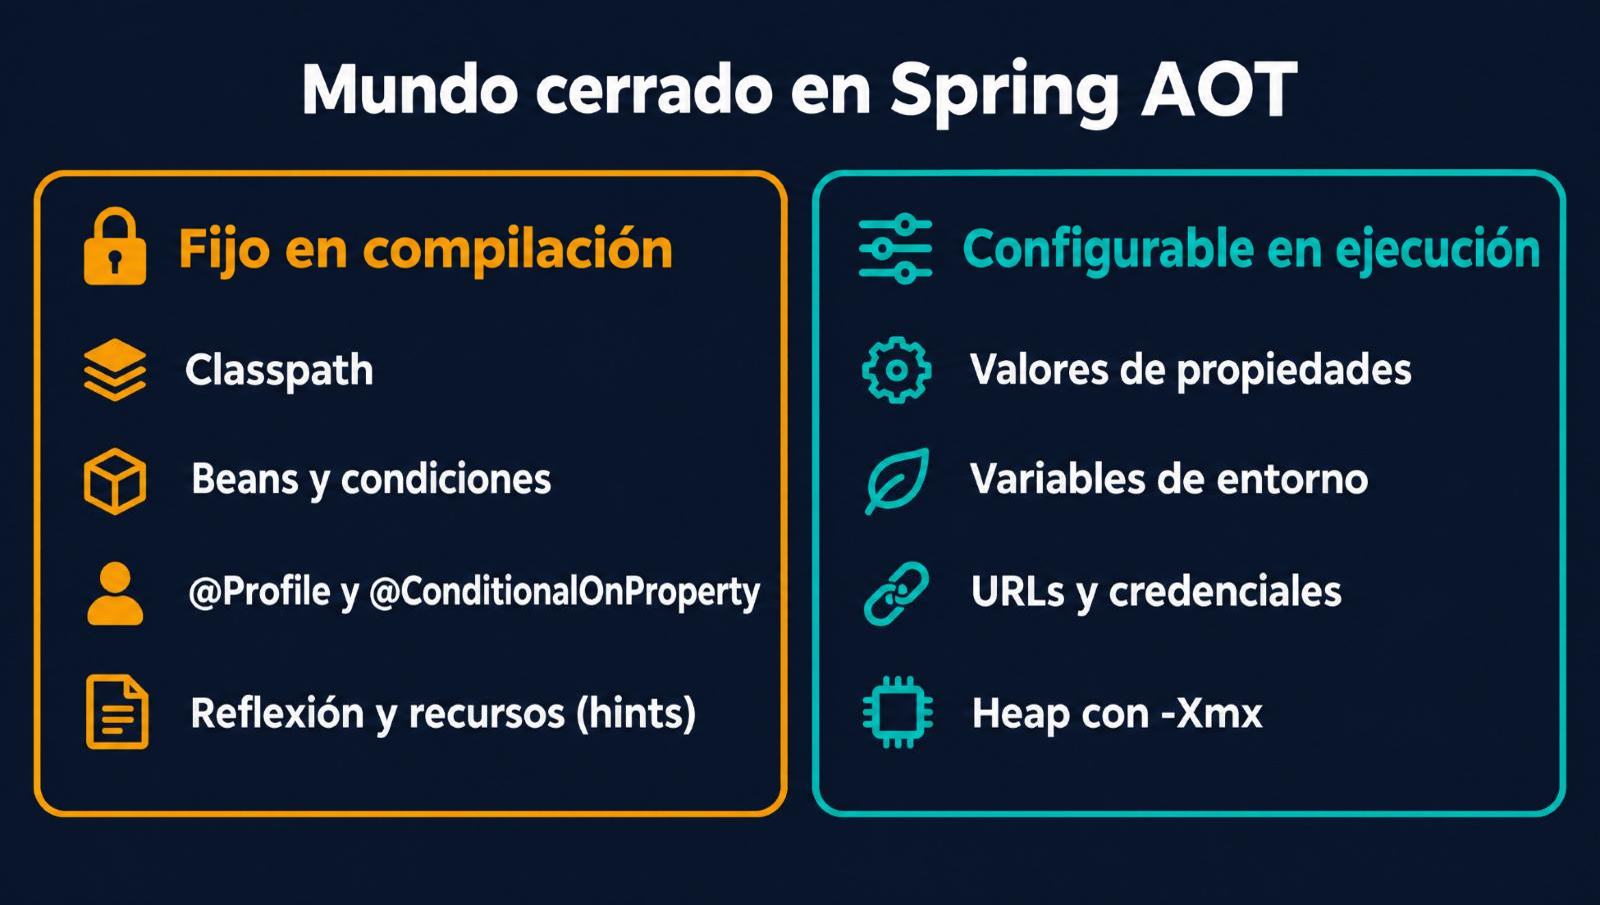
Ese análisis estático tiene una consecuencia que explica casi todos los problemas que veremos: GraalVM trabaja bajo la suposición de mundo cerrado. Si algo no se puede descubrir mirando el código (una clase cargada por reflexión a partir de un String, un recurso leído del classpath, un proxy dinámico), no estará en el ejecutable a menos que alguien se lo diga. La documentación oficial de Spring Boot sobre imágenes nativas resume las diferencias: el classpath queda fijado en la compilación, no hay carga perezosa de clases y la reflexión, los recursos, la serialización y los proxies deben declararse.
Cómo funciona: Spring AOT + GraalVM native-image
Spring es, por diseño, un framework muy dinámico: escanea el classpath, evalúa condiciones de autoconfiguración, crea proxies CGLIB para @Transactional o @Configuration y usa reflexión para inyectar dependencias. Nada de eso encaja con un análisis estático. Por eso, antes de que GraalVM entre en juego, Spring Boot ejecuta su propio paso de compilación: el procesamiento AOT (goal process-aot en Maven, tarea processAot en Gradle).
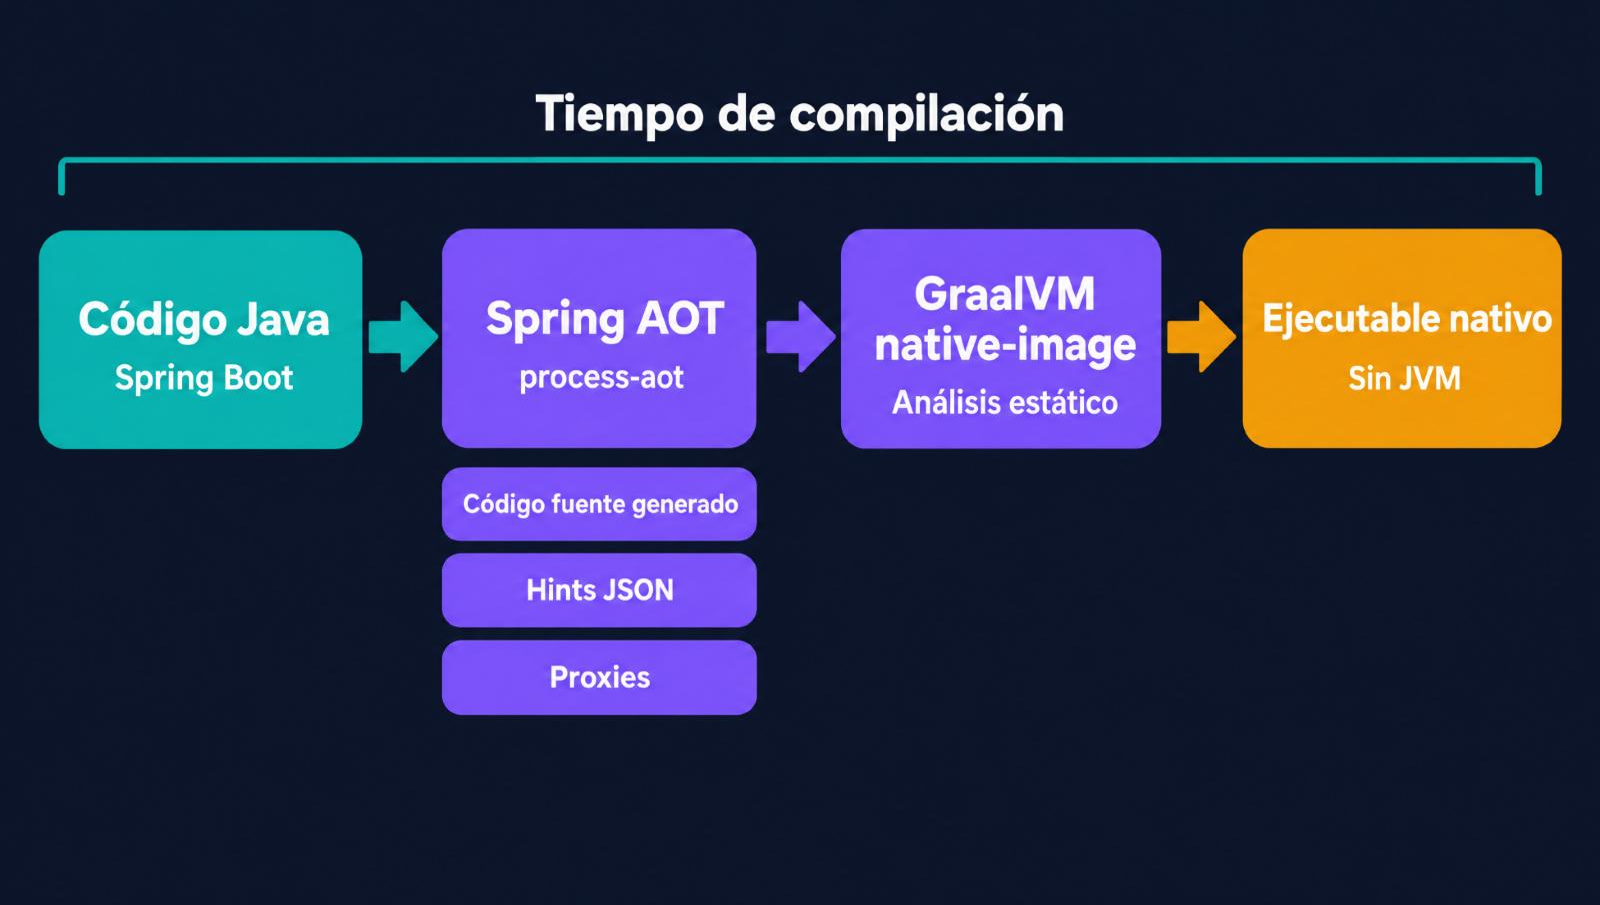
Durante ese paso, Spring arranca la aplicación hasta tener las definiciones de beans, sin llegar a crear las instancias, y genera tres tipos de artefactos:
- Código fuente Java que registra cada bean de forma programática, sin reflexión ni parsing de anotaciones en el arranque. Una clase
@ConfigurationllamadaPedidosConfigproduce unPedidosConfig__BeanDefinitionscon losRootBeanDefinitionya resueltos. Este código es legible y muy útil para depurar: está entarget/spring-aot/main/sources. - Ficheros de hints en JSON (
reflect-config.json,resource-config.json,proxy-config.json…) que le dicen a GraalVM qué necesita reflexión, qué recursos incluir y qué proxies existen. - Bytecode de los proxies CGLIB, generado en la compilación porque en una imagen nativa no se pueden crear clases en tiempo de ejecución.
Con eso, native-image ya tiene todo lo que necesita para su análisis estático. Un detalle importante: el código AOT también se puede usar en la JVM con -Dspring.aot.enabled=true. Arranca algo más rápido y, sobre todo, es la forma más barata de comprobar que la aplicación funciona con las restricciones de AOT antes de esperar diez minutos a una compilación nativa.
Requisitos: Spring Boot 4.1 y GraalVM 25
Según los requisitos del sistema de Spring Boot 4.1, las imágenes nativas necesitan GraalVM 25 o superior (con Native Build Tools 1.1.x). Hay dos formas de compilarlas:
- Cloud Native Buildpacks: solo necesitas Docker. El buildpack de Paketo descarga la toolchain de GraalVM dentro de un contenedor. Debes compilar con JDK 25 como mínimo, porque el buildpack usa la versión de
native-imagecorrespondiente a la versión de Java del proyecto. - Native Build Tools: necesitas una distribución de GraalVM instalada localmente (GraalVM Community, Oracle GraalVM o Liberica NIK). Genera directamente el ejecutable, sin contenedor.
En ambos casos la configuración del proyecto es la misma. Con spring-boot-starter-parent, basta con añadir el plugin de GraalVM; el parent ya declara un perfil native que activa el procesamiento AOT:
<parent>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-starter-parent</artifactId>
    <version>4.1.1</version>
</parent>

<properties>
    <java.version>25</java.version>
</properties>

<build>
    <plugins>
        <plugin>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-maven-plugin</artifactId>
        </plugin>
        <!-- La versión la gestiona el parent de Spring Boot -->
        <plugin>
            <groupId>org.graalvm.buildtools</groupId>
            <artifactId>native-maven-plugin</artifactId>
        </plugin>
    </plugins>
</build>
En Gradle es aún más corto: aplicar el plugin org.graalvm.buildtools.native en el bloque plugins hace que el plugin de Spring Boot active AOT automáticamente.
Cómo compilar una Spring Boot native image paso a paso
Opción 1: imagen de contenedor con Buildpacks
Es el camino más directo si el destino es Docker o Kubernetes, y no exige instalar GraalVM:
# Maven: el perfil "native" activa AOT y el buildpack de native image
./mvnw -Pnative spring-boot:build-image

# Gradle: con el plugin de GraalVM aplicado, bootBuildImage genera una imagen nativa
./gradlew bootBuildImage

# Ejecutar
docker run --rm -p 8080:8080 docker.io/library/pedidos-service:1.4.2
El builder por defecto es paketobuildpacks/builder-noble-java-tiny: una imagen mínima, sin shell y con pocas librerías del sistema, lo que reduce la superficie de ataque. Ten en cuenta que la compilación nativa es intensiva en memoria: en macOS la documentación recomienda dar al menos 8 GB a Docker.
Opción 2: ejecutable con Native Build Tools
Con GraalVM instalado (por ejemplo, con SDKMAN: sdk install java 25.r25-nik), compilas directamente el binario:
# Maven: el ejecutable queda en target/
./mvnw -Pnative native:compile
./target/pedidos-service

# Gradle: el ejecutable queda en build/native/nativeCompile/
./gradlew nativeCompile
./build/native/nativeCompile/pedidos-service
Es la opción cómoda para probar en local, aunque el binario solo funciona en el sistema operativo y la arquitectura donde se compiló: un ejecutable generado en macOS no corre en un contenedor Linux.
Opción 3: Dockerfile multietapa
Si prefieres controlar la imagen final como hicimos en el artículo de Docker, puedes compilar dentro de la imagen oficial de GraalVM Community y copiar solo el binario a una imagen de runtime mínima:
# syntax=docker/dockerfile:1
# ---------- Etapa 1: compilar el ejecutable nativo ----------
FROM ghcr.io/graalvm/native-image-community:25 AS build
WORKDIR /workspace
COPY .mvn .mvn
COPY mvnw pom.xml ./
RUN ./mvnw -B dependency:go-offline
COPY src src
# -Pnative activa process-aot; native:compile invoca native-image
RUN ./mvnw -B -Pnative -DskipTests native:compile
# ---------- Etapa 2: runtime sin JVM ----------
FROM gcr.io/distroless/base-debian12:nonroot
WORKDIR /app
COPY /workspace/target/pedidos-service /app/pedidos-service
EXPOSE 8080
# Forma exec: SIGTERM llega directamente al proceso
ENTRYPOINT ["/app/pedidos-service"]Para que el binario funcione en una imagen distroless conviene compilarlo como "mostly static": todo enlazado estáticamente salvo la libc. Se consigue pasando --static-nolibc a native-image desde el plugin:
<plugin>
    <groupId>org.graalvm.buildtools</groupId>
    <artifactId>native-maven-plugin</artifactId>
    <configuration>
        <buildArgs>
            <!-- Enlaza todo estáticamente excepto glibc: compatible con distroless/base -->
            <buildArg>--static-nolibc</buildArg>
            <!-- Permite volcados de heap y JFR en producción -->
            <buildArg>--enable-monitoring=heapdump,jfr</buildArg>
        </buildArgs>
    </configuration>
</plugin>
La imagen resultante no contiene JDK, ni JRE, ni shell: solo el binario y la libc. Suele quedarse por debajo de la mitad del tamaño de una imagen JVM bien optimizada.
El mundo cerrado: qué deja de funcionar y cómo arreglarlo
Aquí está la parte que los tutoriales de "hola mundo" no enseñan. La aplicación compila, el binario arranca en 60 ms… y la primera petición real devuelve un error porque Jackson no encuentra los constructores de un DTO, o porque una librería carga una clase por nombre. Conviene entender qué queda fijado en la compilación y qué sigue siendo configurable.
Reflexión, recursos y proxies: RuntimeHints
Spring genera automáticamente los hints para lo que conoce: sus propios beans, los tipos de entrada y salida de los métodos de @RestController, las entidades JPA, los @ConfigurationProperties. Lo que no puede adivinar es lo que tu código hace de forma dinámica. Para eso existe la API de RuntimeHints:
public class PedidosRuntimeHints implements RuntimeHintsRegistrar {

    @Override
    public void registerHints(RuntimeHints hints, ClassLoader classLoader) {
        // Plantillas que leemos con getResourceAsStream: si no se registran,
        // no se incluyen en el ejecutable y la lectura devuelve null
        hints.resources().registerPattern("plantillas/*.html");

        // Clase que un plugin de terceros instancia por nombre con Class.forName
        hints.reflection().registerType(
                TypeReference.of("com.ejemplo.facturacion.CalculadoraIva"),
                MemberCategory.INVOKE_PUBLIC_CONSTRUCTORS,
                MemberCategory.INVOKE_PUBLIC_METHODS);

        // Proxy JDK creado a mano con Proxy.newProxyInstance
        hints.proxies().registerJdkProxy(AuditoriaPort.class);
    }
}
Y se activa desde cualquier clase @Configuration:
@SpringBootApplication
@ImportRuntimeHints(PedidosRuntimeHints.class)
public class PedidosApplication {

    public static void main(String[] args) {
        SpringApplication.run(PedidosApplication.class, args);
    }
}
El caso más frecuente en microservicios es la serialización JSON de clases que no aparecen en ningún controlador: las respuestas de otro servicio que consumes con RestClient o WebClient. Spring no puede saber qué tipos vas a deserializar, así que hay que indicarlo con @RegisterReflectionForBinding:
@Component
@RegisterReflectionForBinding({StockResponse.class, ReservaRequest.class})
public class InventarioClient {

    private final RestClient restClient;

    public InventarioClient(RestClient.Builder builder) {
        this.restClient = builder.baseUrl("http://inventario-service").build();
    }

    public StockResponse consultarStock(String sku) {
        // Sin el hint, Jackson falla en la imagen nativa al no poder
        // acceder por reflexión a los componentes del record
        return restClient.get()
                .uri("/stock/{sku}", sku)
                .retrieve()
                .body(StockResponse.class);
    }
}
Si ya usas los clientes REST de Spring, este es el cambio que más veces tendrás que hacer. Los hints también se pueden probar con un test unitario normal, sin compilar nada nativo, usando RuntimeHintsPredicates:
class PedidosRuntimeHintsTest {

    @Test
    void registraLasPlantillas() {
        RuntimeHints hints = new RuntimeHints();
        new PedidosRuntimeHints().registerHints(hints, getClass().getClassLoader());

        assertThat(RuntimeHintsPredicates.resource().forResource("plantillas/factura.html"))
                .accepts(hints);
    }
}
Librerías de terceros: el repositorio de metadatos
Spring no publica hints para librerías ajenas. Para eso existe el GraalVM Reachability Metadata Repository, un repositorio comunitario con la configuración de cientos de librerías populares que Native Build Tools descarga automáticamente. Antes de adoptar una dependencia en un servicio nativo, comprueba si la soporta de forma oficial o si aparece en ese repositorio. Si no, tienes dos opciones: escribir tú los hints o usar el agente de trazas de GraalVM, que observa la aplicación en la JVM y anota toda la reflexión, los recursos y los proxies que se usan:
# Ejecuta la app en la JVM con el código AOT y el agente activados
java -Dspring.aot.enabled=true \
     -agentlib:native-image-agent=config-output-dir=src/main/resources/META-INF/native-image/com.ejemplo/pedidos-extra/ \
     -jar target/pedidos-service-1.4.2.jar

# Ejercita los flujos reales (tests de humo, colección de Postman...) y para con Ctrl+C:
# el agente escribe los JSON de configuración al terminar
El agente solo registra lo que se ejecuta mientras está activo, así que su calidad depende de lo completo que sea el recorrido. Revisa los ficheros generados y quédate con lo que tenga sentido; no es raro que capture más de lo necesario.
Perfiles y propiedades condicionales
Este es el punto que más sorprende a los equipos que vienen de la JVM. El procesamiento AOT evalúa las condiciones en la compilación: @ConditionalOnProperty, @ConditionalOnClass, @Profile y, en general, cualquier @Conditional. El conjunto de beans resultante queda congelado. Si compilas sin el perfil kafka y tu bean KafkaPublicador está anotado con @Profile("kafka"), no existirá en el ejecutable aunque arranques con SPRING_PROFILES_ACTIVE=kafka. Lo mismo con las propiedades *.enabled que deciden si se crea un bean.
La regla práctica, recogida en la guía de AOT de Spring Boot, es:
- Perfiles que solo cambian valores de propiedades (URLs, timeouts, niveles de log): funcionan sin restricciones. Un
application-prod.ymlcon otra URL de base de datos sigue aplicándose en ejecución. - Perfiles que cambian qué beans existen: deben estar activos durante la compilación.
En Maven se fijan en la ejecución process-aot:
<profile>
    <id>native</id>
    <build>
        <pluginManagement>
            <plugins>
                <plugin>
                    <groupId>org.springframework.boot</groupId>
                    <artifactId>spring-boot-maven-plugin</artifactId>
                    <executions>
                        <execution>
                            <id>process-aot</id>
                            <configuration>
                                <!-- Estos perfiles deciden qué beans entran en el binario -->
                                <profiles>kafka,cache-redis</profiles>
                            </configuration>
                        </execution>
                    </executions>
                </plugin>
            </plugins>
        </pluginManagement>
    </build>
</profile>
Y en Gradle, en la tarea ProcessAot:
tasks.withType(org.springframework.boot.gradle.tasks.aot.ProcessAot).configureEach {
    args('--spring.profiles.active=kafka,cache-redis')
}
La mejor estrategia es diseñar para ello: usar perfiles para configuración y no para cablear implementaciones distintas. Si necesitas elegir entre dos implementaciones en ejecución, crea ambos beans y decide con un valor de propiedad dentro del código, o publica binarios distintos por variante. Un patrón de diseño Strategy resuelve esto mejor que un @Profile.
Configuración anidada
Un detalle menor que causa errores silenciosos: las propiedades de configuración anidadas que no son clases internas deben anotarse con @NestedConfigurationProperty; si no, no se enlazan en la imagen nativa y el valor queda a null sin ningún aviso:
@ConfigurationProperties("pedidos")
public record PedidosProperties(
        String moneda,
        @NestedConfigurationProperty ReintentosProperties reintentos) {
}
Testing de imágenes nativas
La compilación nativa es lenta, así que no tiene sentido hacerla en cada cambio. Una estrategia en tres niveles funciona bien:
- Tests normales en la JVM para el día a día, incluidos los de integración con Testcontainers.
- Arranque con AOT en la JVM en cada build de CI: compila con
-Pnative packagey ejecuta el jar con-Dspring.aot.enabled=true. Detecta en segundos los problemas de condiciones y perfiles. - Tests en modo nativo una vez al día o antes de cada release. La suite de JUnit se compila a un ejecutable nativo y se ejecuta allí, con lo que se detectan también los fallos de reflexión:
# Maven
./mvnw -PnativeTest test

# Gradle
./gradlew nativeTest
Ten en cuenta que no todo lo que funciona en tests de la JVM está soportado en nativo: Mockito, por ejemplo, depende de generar clases en tiempo de ejecución, así que los tests nativos deben centrarse en integración real más que en mocks.
Native image vs JVM: rendimiento, memoria y tiempo de build
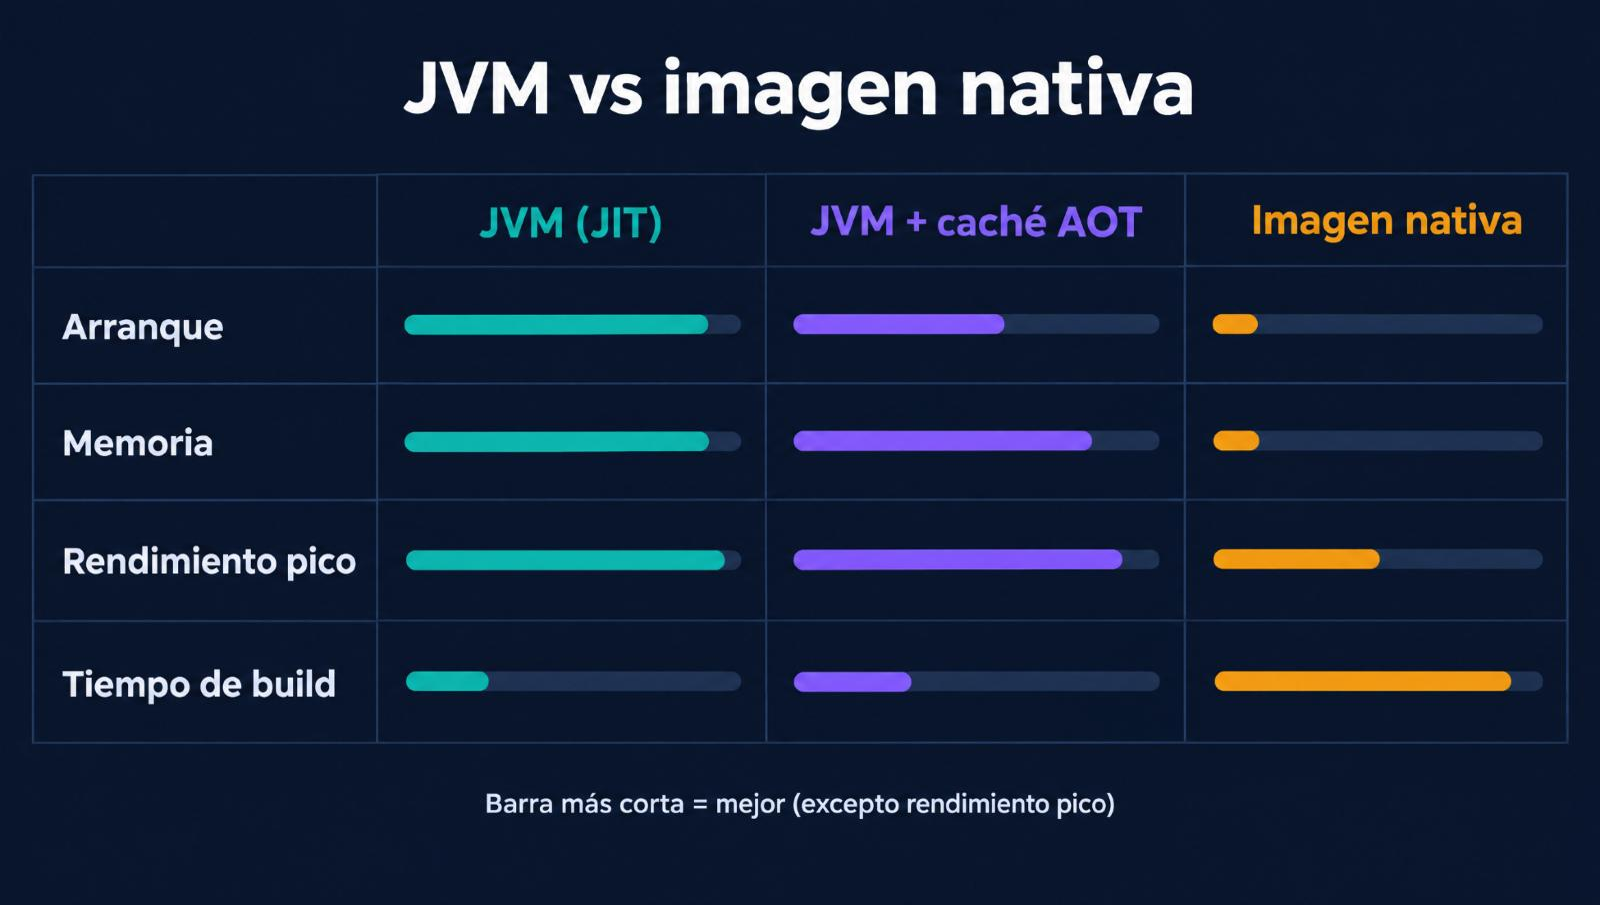
Las cifras exactas dependen de cada aplicación, pero el patrón se repite en cualquier medición seria:
- Arranque: de segundos a decenas de milisegundos. Es la mayor ventaja y la más estable.
- Memoria: el uso en reposo baja de forma muy notable, porque no hay JIT, ni metadatos de clases cargadas, ni código sin usar. Bajo carga la diferencia se reduce, pero suele seguir siendo favorable.
- Rendimiento pico: aquí la JVM suele ganar. Un servicio de larga duración en la JVM acaba optimizado por el JIT con información real del perfil de ejecución; el binario nativo se optimizó en la compilación sin conocer ese perfil. La optimización guiada por perfiles (PGO) reduce la diferencia (se compila una versión instrumentada con
--pgo-instrument, se ejecuta con carga representativa y se recompila con el perfil), pero solo está disponible en Oracle GraalVM, no en la edición Community. - Recolector de basura: GraalVM Community solo ofrece el Serial GC, pensado para heaps pequeños. El G1 está disponible en Oracle GraalVM en Linux. Para un microservicio con heap modesto el Serial GC funciona bien; para heaps de varios gigas con mucha asignación, la JVM está en ventaja.
- Tiempo de build: de segundos a varios minutos, con varios gigas de RAM. Afecta al ciclo de CI y a cuántas veces al día puedes desplegar.
¿GraalVM o caché AOT de Java 25?
Esta es la comparación que suele faltar. Desde JEP 483 (Java 24) y JEP 514 (Java 25), la propia JVM ofrece una caché AOT que guarda las clases ya cargadas y enlazadas de una ejecución de entrenamiento, como vimos al dockerizar Spring Boot. No llega a los milisegundos de una imagen nativa, pero recorta el arranque de forma notable sin ninguna de sus restricciones: sigue siendo la JVM, con JIT, con todos los GC, con reflexión libre, con perfiles normales y con un build casi igual de rápido.
Una forma razonable de decidir:
| Situación | Mejor opción |
|---|---|
| Funciones serverless, CLIs, jobs efímeros que arrancan por cada ejecución | Imagen nativa |
| Autoescalado agresivo con scale-to-zero (Knative, Cloud Run) | Imagen nativa |
| Muchos microservicios pequeños donde la memoria por réplica domina el coste | Imagen nativa, si las librerías lo soportan |
| Servicios de larga duración con alto throughput o heaps grandes | JVM + caché AOT |
| Uso intensivo de librerías con reflexión, generación de bytecode o agents | JVM + caché AOT |
| Equipo sin tiempo para mantener hints y builds nativos en CI | JVM + caché AOT |
Native images en Kubernetes
Si despliegas la imagen nativa con los manifiestos del artículo de Spring Boot en Kubernetes, casi todo sigue igual: Actuator expone las mismas probes de liveness y readiness, el apagado ordenado funciona igual y la configuración por ConfigMaps y Secrets se aplica en ejecución. Cambian algunos detalles:
- Ya no hay
JAVA_TOOL_OPTIONS: no hay JVM que lo lea. Las opciones de memoria se pasan como argumentos al ejecutable. Fija siempre el heap máximo de forma explícita: con el Serial GC, el máximo por defecto es un porcentaje alto de la memoria física (el 80 %), y en un contenedor quieres control total. - Los
requestsylimitsde memoria bajan, y con ellos el coste por réplica. Mide con Actuator y Prometheus antes de recortar: la memoria real bajo carga es la que importa. - La
startupProbepuede ser mucho más corta, porque el arranque pasa de decenas de segundos a menos de uno. Mantenla, pero con un umbral pequeño. - El HPA se comporta mejor: no hay calentamiento del JIT que dispare la CPU de las réplicas nuevas, así que los escalados en cascada que vimos con la JVM desaparecen.
- La imagen es mínima y sin shell: un
preStopconsleepnativo (Kubernetes 1.32+) es la única opción viable, porque no hayshpara la formaexec.
containers:
  - name: app
    image: registry.ejemplo.com/pedidos-service:1.4.2-native
    # El ejecutable acepta -Xmx en tiempo de ejecución
    args: ["-Xmx256m"]
    resources:
      requests:
        cpu: "250m"
        memory: "384Mi"
      limits:
        memory: "384Mi"
    startupProbe:
      httpGet:
        path: /actuator/health/liveness
        port: 8080
      periodSeconds: 2
      failureThreshold: 10
    lifecycle:
      preStop:
        sleep:
          seconds: 10
Errores frecuentes con Spring Boot native image
- Compilar sin haber probado AOT en la JVM: diez minutos de build para descubrir un bean que falta por un
@Profile. Prueba primero con-Dspring.aot.enabled=true. - DTOs de clientes HTTP sin
@RegisterReflectionForBinding: el binario arranca y falla en la primera llamada a otro servicio. - Recursos del classpath no registrados: plantillas, ficheros de datos o certificados que devuelven
nullsolo en nativo. - Usar
@Profileo@ConditionalOnPropertypara elegir implementaciones en ejecución: el conjunto de beans quedó fijado en la compilación. - Copiar el ejecutable entre sistemas: un binario compilado en macOS o en ARM no corre en un nodo Linux x86-64. Compila en el mismo sistema y arquitectura que producción, normalmente dentro de un contenedor en CI.
- No fijar
-Xmxy dejar que el heap máximo se calcule sobre la memoria física. - Dar por hecho que será más rápido en todo: el arranque sí; el throughput sostenido, no necesariamente. Haz una prueba de carga antes de migrar un servicio crítico.
Buenas prácticas
- Decide por caso de uso, no por moda. La imagen nativa brilla donde el arranque y la memoria dominan; la JVM con caché AOT es la opción por defecto para el resto.
- Mantén la aplicación compatible con AOT aunque despliegues en la JVM: sin perfiles que cambien beans, sin reflexión gratuita. Te deja la puerta abierta a migrar sin reescribir.
- Elige dependencias con soporte nativo o presentes en el repositorio de metadatos de GraalVM.
- Pipeline en tres niveles: tests en JVM en cada commit, arranque AOT en cada build y tests nativos diarios o antes de cada release.
- Compila en CI dentro de un contenedor con la misma arquitectura que producción, con caché de dependencias y suficiente memoria para
native-image. - Activa la monitorización en el build (
--enable-monitoring) para poder sacar volcados de heap y JFR si algo va mal en producción. - Mide siempre: arranque, memoria bajo carga, latencia p99 y throughput, comparados con la versión JVM del mismo servicio.
Preguntas frecuentes
¿Qué es una imagen nativa en Spring Boot?
Es un ejecutable generado por GraalVM a partir de la aplicación Spring Boot y sus dependencias, compilado ahead-of-time a código máquina para una plataforma concreta. No necesita JVM para ejecutarse, arranca en milisegundos y usa menos memoria, a cambio de builds más lentos y de fijar en la compilación el classpath y el conjunto de beans.
¿Es una Spring Boot native image más rápida que la JVM?
Arranca mucho más rápido y consume menos memoria, pero no siempre tiene mejor rendimiento sostenido. La JVM optimiza el código con el JIT usando información real de ejecución, y en servicios de larga duración con mucha carga suele alcanzar un throughput igual o superior. PGO en Oracle GraalVM reduce esa diferencia.
¿Cuánto tarda en compilarse una imagen nativa de Spring Boot?
Depende del tamaño de la aplicación y de la máquina, pero lo habitual es de uno a varios minutos y varios gigas de memoria, frente a los segundos de un jar. Por eso se recomienda compilar en CI y usar la JVM para el desarrollo local.
¿Funcionan los perfiles de Spring en una native image?
Los perfiles que solo cambian valores de propiedades funcionan con normalidad en ejecución. Los que cambian qué beans se crean, mediante @Profile o condiciones como @ConditionalOnProperty, se evalúan en la compilación, así que deben activarse en el paso process-aot.
¿Qué hago si una librería no funciona con GraalVM?
Comprueba primero si aparece en el GraalVM Reachability Metadata Repository, que Native Build Tools usa automáticamente. Si no, registra los hints que falten con RuntimeHintsRegistrar o genéralos con el agente de trazas de GraalVM ejecutando la aplicación en la JVM. Si la librería genera bytecode en tiempo de ejecución, puede que no sea compatible.
¿GraalVM native image o caché AOT de Java 25?
Si necesitas arranque en milisegundos o scale-to-zero, la imagen nativa. Si quieres arrancar más rápido sin renunciar al JIT, a los GC de la JVM ni a la libertad de reflexión y perfiles, la caché AOT de Java 25 es la opción más sencilla y suele ser suficiente para microservicios de larga duración.
Conclusión
Una Spring Boot native image no es una versión "mejor" de la aplicación, sino una versión con otro reparto de costes: se paga en la compilación (tiempo, memoria, hints, disciplina con perfiles y dependencias) lo que se ahorra en cada arranque y en cada mega de memoria en producción. Spring Boot 4.1 y GraalVM 25 hacen que el camino feliz sea casi trivial —un plugin y ./mvnw -Pnative spring-boot:build-image—, y el procesamiento AOT de Spring resuelve por sí solo la mayor parte del dinamismo del framework. Lo que queda es tu código y tus librerías: reflexión, recursos, clientes HTTP y perfiles que cambian beans.
Si te quedas con lo esencial: prueba AOT en la JVM antes de compilar nada nativo, registra los hints de lo que el análisis estático no puede ver, activa en la compilación los perfiles que deciden beans, fija -Xmx en el contenedor y mide frente a la versión JVM. Y si tu servicio vive semanas sin reiniciarse y empuja mucho tráfico, considera seriamente la caché AOT de Java 25: a veces la mejor optimización es la que no te obliga a cambiar cómo trabajas.