
Dockerizar Spring Boot: imágenes pequeñas, rápidas y listas para producción
Si buscas cómo dockerizar Spring Boot, casi todos los tutoriales llegan al mismo resultado: un Dockerfile de cuatro líneas que parte de una imagen con el JDK completo, copia el fat jar y lo ejecuta con java -jar. Funciona en local y sirve para una demo. El problema aparece cuando esa imagen entra en un pipeline real: pesa cientos de megas más de lo necesario, cada commit vuelve a subir al registro todas las dependencias aunque solo hayas cambiado una línea de un controlador, el proceso corre como root y la JVM, sin ninguna configuración, decide por su cuenta cuánta memoria usar dentro de un contenedor que tiene un límite que ella no respeta del todo.
Este artículo recorre el camino completo desde ese Dockerfile ingenuo hasta una imagen pensada para producción con Spring Boot 4.1 y Java 25: build multietapa, extracción del jar en capas para aprovechar la caché de Docker, la alternativa sin Dockerfile con Cloud Native Buildpacks, la caché AOT que recorta el arranque, la configuración de memoria de la JVM en contenedores, el usuario no root y un compose.yaml para desarrollo. Es el paso previo natural a todo lo que vimos en estrategias de despliegue Blue-Green, Canary y Rolling: antes de desplegar bien, hay que empaquetar bien.
¿Qué significa dockerizar una aplicación Spring Boot?
Dockerizar una aplicación Spring Boot es empaquetarla, junto con el runtime de Java que necesita, en una imagen de contenedor OCI inmutable que se ejecuta igual en el portátil, en CI y en producción. Una buena imagen contiene solo el JRE y la aplicación, separa dependencias y código en capas cacheables, arranca rápido y corre sin privilegios de administrador.
Esa definición deja fuera muchas cosas que suelen colarse en la imagen: el JDK completo, Maven o Gradle, el código fuente, la caché local de dependencias o herramientas de depuración. Todo eso es necesario para construir la aplicación, no para ejecutarla, y cada mega que sobra es superficie de ataque, tiempo de descarga en cada nodo y espacio en el registro.
El Dockerfile ingenuo y sus cuatro problemas
Este es el Dockerfile que aparece en la mayoría de guías en español:
# NO recomendado para producción
FROM openjdk:17-jdk-alpine
WORKDIR /app
COPY target/mi-app.jar app.jar
EXPOSE 8080
ENTRYPOINT ["java", "-jar", "app.jar"]
Tiene cuatro problemas que conviene entender antes de arreglarlos:
- La imagen base está obsoleta. La imagen oficial
openjdkde Docker Hub está deprecada desde 2022 y no recibe actualizaciones; las alternativas mantenidas son distribuciones como Eclipse Temurin, Liberica o Amazon Corretto. Además usa un JDK cuando en runtime solo hace falta un JRE. - El jar se construye fuera. El Dockerfile asume que alguien ejecutó
mvn packageantes, con su versión de Java y su entorno. La imagen deja de ser reproducible: depende de la máquina que hizo el build. - Una sola capa para todo. El fat jar mezcla 80 MB de dependencias que cambian una vez al mes con 200 KB de código propio que cambia en cada commit. Para Docker es un único fichero: cualquier cambio invalida la capa entera y obliga a subirla y descargarla completa.
- Corre como
rooty sin límites de memoria pensados. Si alguien explota una vulnerabilidad de la aplicación, obtiene root dentro del contenedor. Y la JVM, por defecto, reserva solo el 25 % de la memoria del contenedor para el heap, lo que desperdicia recursos o, si se ajusta mal a mano, termina en unOOMKilled.
Vamos a resolverlos uno a uno.
Dockerfile multietapa para Spring Boot
Un Dockerfile multietapa (multi-stage build) usa varias instrucciones FROM en el mismo fichero. La primera etapa tiene todo lo necesario para compilar; la última parte de una imagen mínima y copia de la anterior solo los artefactos resultantes. Lo que se queda en las etapas intermedias no llega a la imagen final.
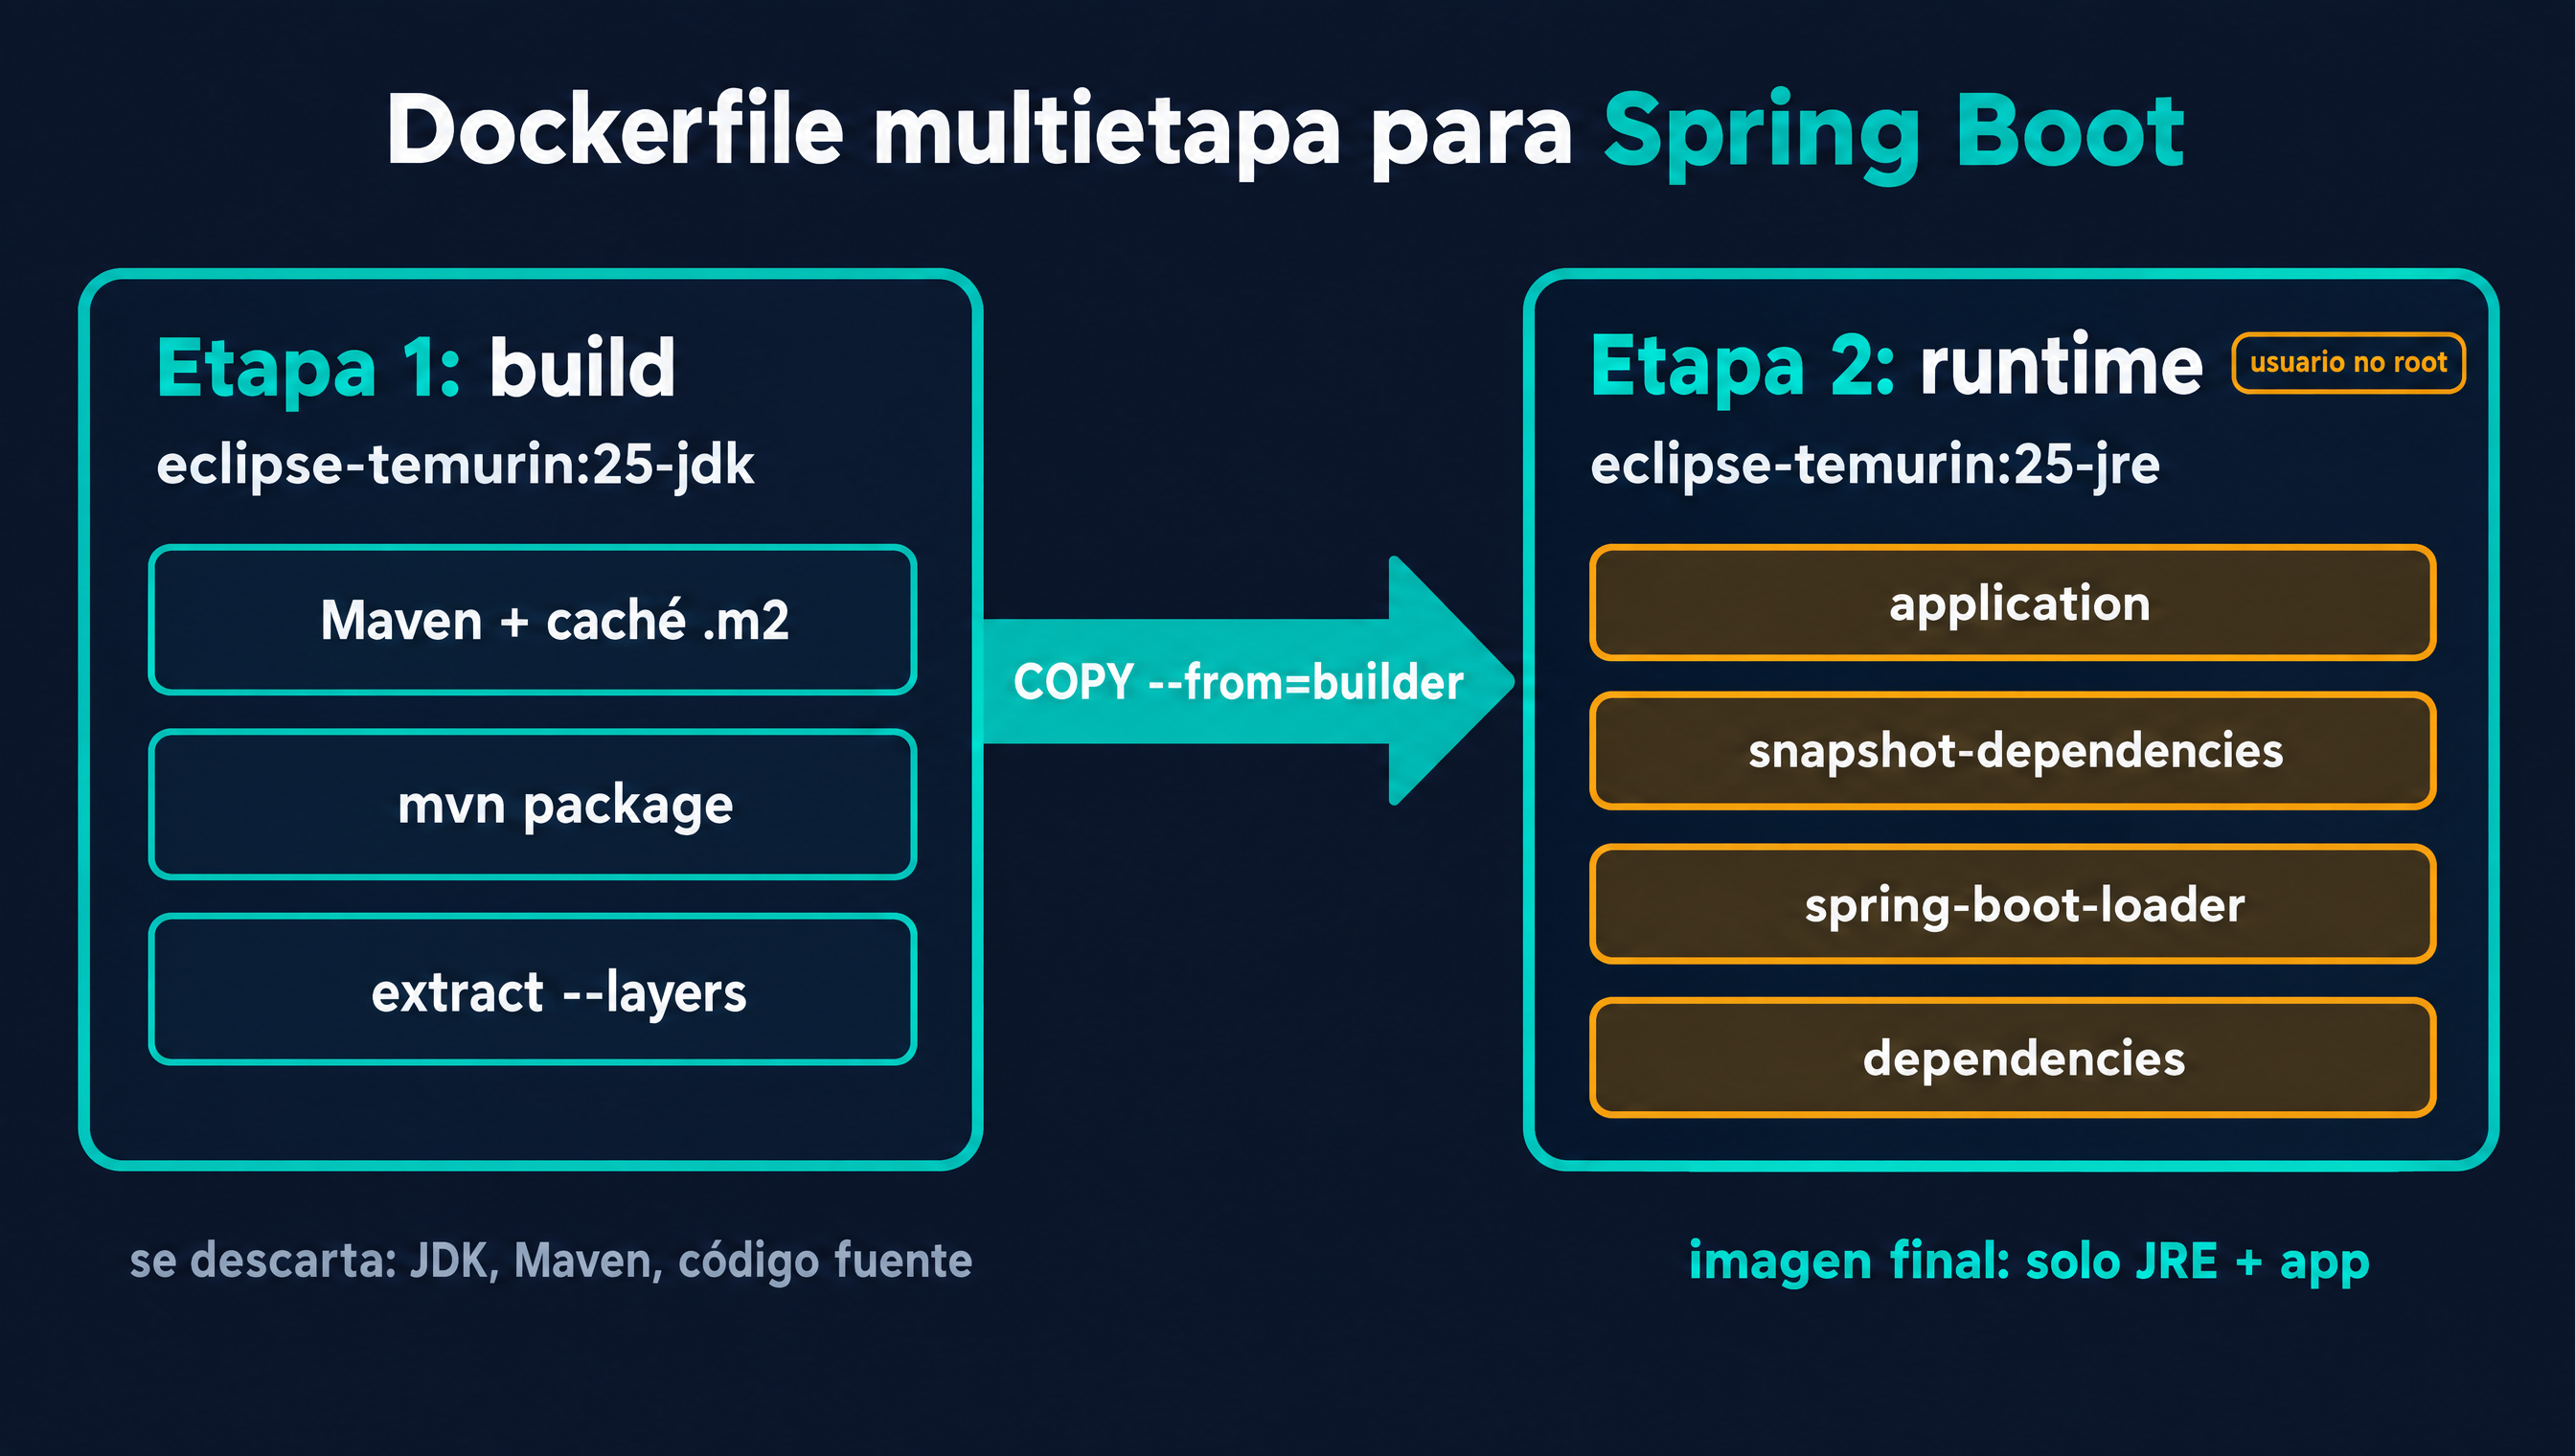
Este es el Dockerfile completo que vamos a desgranar, para un proyecto Maven con el wrapper (mvnw) en la raíz:
# syntax=docker/dockerfile:1
# ---------- Etapa 1: compilar y extraer ----------
FROM eclipse-temurin:25-jdk AS builder
WORKDIR /build
# 1) Copiamos primero solo lo que define las dependencias.
# Si pom.xml no cambia, esta capa y la descarga de dependencias se cachean.
COPY mvnw pom.xml ./
COPY .mvn .mvn
RUN ./mvnw -B -q dependency:go-offline
# 2) Ahora el código fuente: cambia en cada commit.
COPY src src
RUN ./mvnw -B -q package -DskipTests
# 3) Extraemos el jar en capas con el modo "tools" de Spring Boot
RUN cp target/*.jar application.jar \
&& java -Djarmode=tools -jar application.jar extract --layers --destination extracted
# ---------- Etapa 2: runtime mínimo ----------
FROM eclipse-temurin:25-jre
WORKDIR /application
# Usuario sin privilegios para ejecutar la aplicación
RUN groupadd --system spring && useradd --system --gid spring --no-create-home spring
# Una instrucción COPY por capa: de la que menos cambia a la que más
COPY /build/extracted/dependencies/ ./
COPY /build/extracted/spring-boot-loader/ ./
COPY /build/extracted/snapshot-dependencies/ ./
COPY /build/extracted/application/ ./
USER spring
EXPOSE 8080
# Memoria y comportamiento ante OOM pensados para contenedores
ENV JAVA_TOOL_OPTIONS="-XX:MaxRAMPercentage=75 -XX:+ExitOnOutOfMemoryError"
# Este application.jar no es el fat jar: solo contiene el código propio
# y referencias a las librerías extraídas en lib/
ENTRYPOINT ["java", "-jar", "application.jar"]Tres detalles marcan la diferencia frente al Dockerfile ingenuo:
- El orden de los
COPYen la etapa de build. Copiarpom.xmlantes quesrcpermite que Docker reutilice la capa con las dependencias descargadas mientras elpom.xmlno cambie. Si copias todo el proyecto de golpe, cualquier cambio en una clase invalida también la descarga de dependencias. --mount=type=cache(requiere BuildKit, activo por defecto en Docker moderno) mantiene el repositorio~/.m2entre builds sin meterlo en ninguna capa de la imagen. Es más rápido y no engorda el resultado.- La etapa final parte de
eclipse-temurin:25-jre, sin compilador, sin Maven y sin código fuente. Si tu equipo usa Gradle, el patrón es idéntico cambiando los comandos y la rutabuild/libs/*.jar.
Para construir y probar:
docker build -t pedidos-service:1.0.0 .
docker run --rm -p 8080:8080 --memory=1g pedidos-service:1.0.0
Layered jars: cómo aprovechar la caché de Docker
El paso extract --layers es el corazón de la optimización. Desde hace varias versiones, el plugin de Spring Boot genera dentro del jar un índice BOOT-INF/layers.idx que clasifica su contenido en cuatro capas según la frecuencia con la que cambia, tal como describe la documentación oficial sobre imágenes eficientes:
| Capa | Contenido | Frecuencia de cambio |
|---|---|---|
dependencies | Librerías con versión estable (Spring, Jackson, drivers…) | Baja: cuando actualizas el pom.xml |
spring-boot-loader | Clases del lanzador de Spring Boot | Muy baja: con cada versión de Boot |
snapshot-dependencies | Dependencias -SNAPSHOT | Media |
application | Tus clases y recursos (application.yml, plantillas…) | Alta: en cada commit |
El comando java -Djarmode=tools -jar application.jar extract --layers (el sucesor del antiguo layertools, que quedó deprecado en Spring Boot 3.3) descomprime el jar en una carpeta por capa. Al copiarlas con un COPY independiente cada una, Docker crea una capa de imagen por cada una.
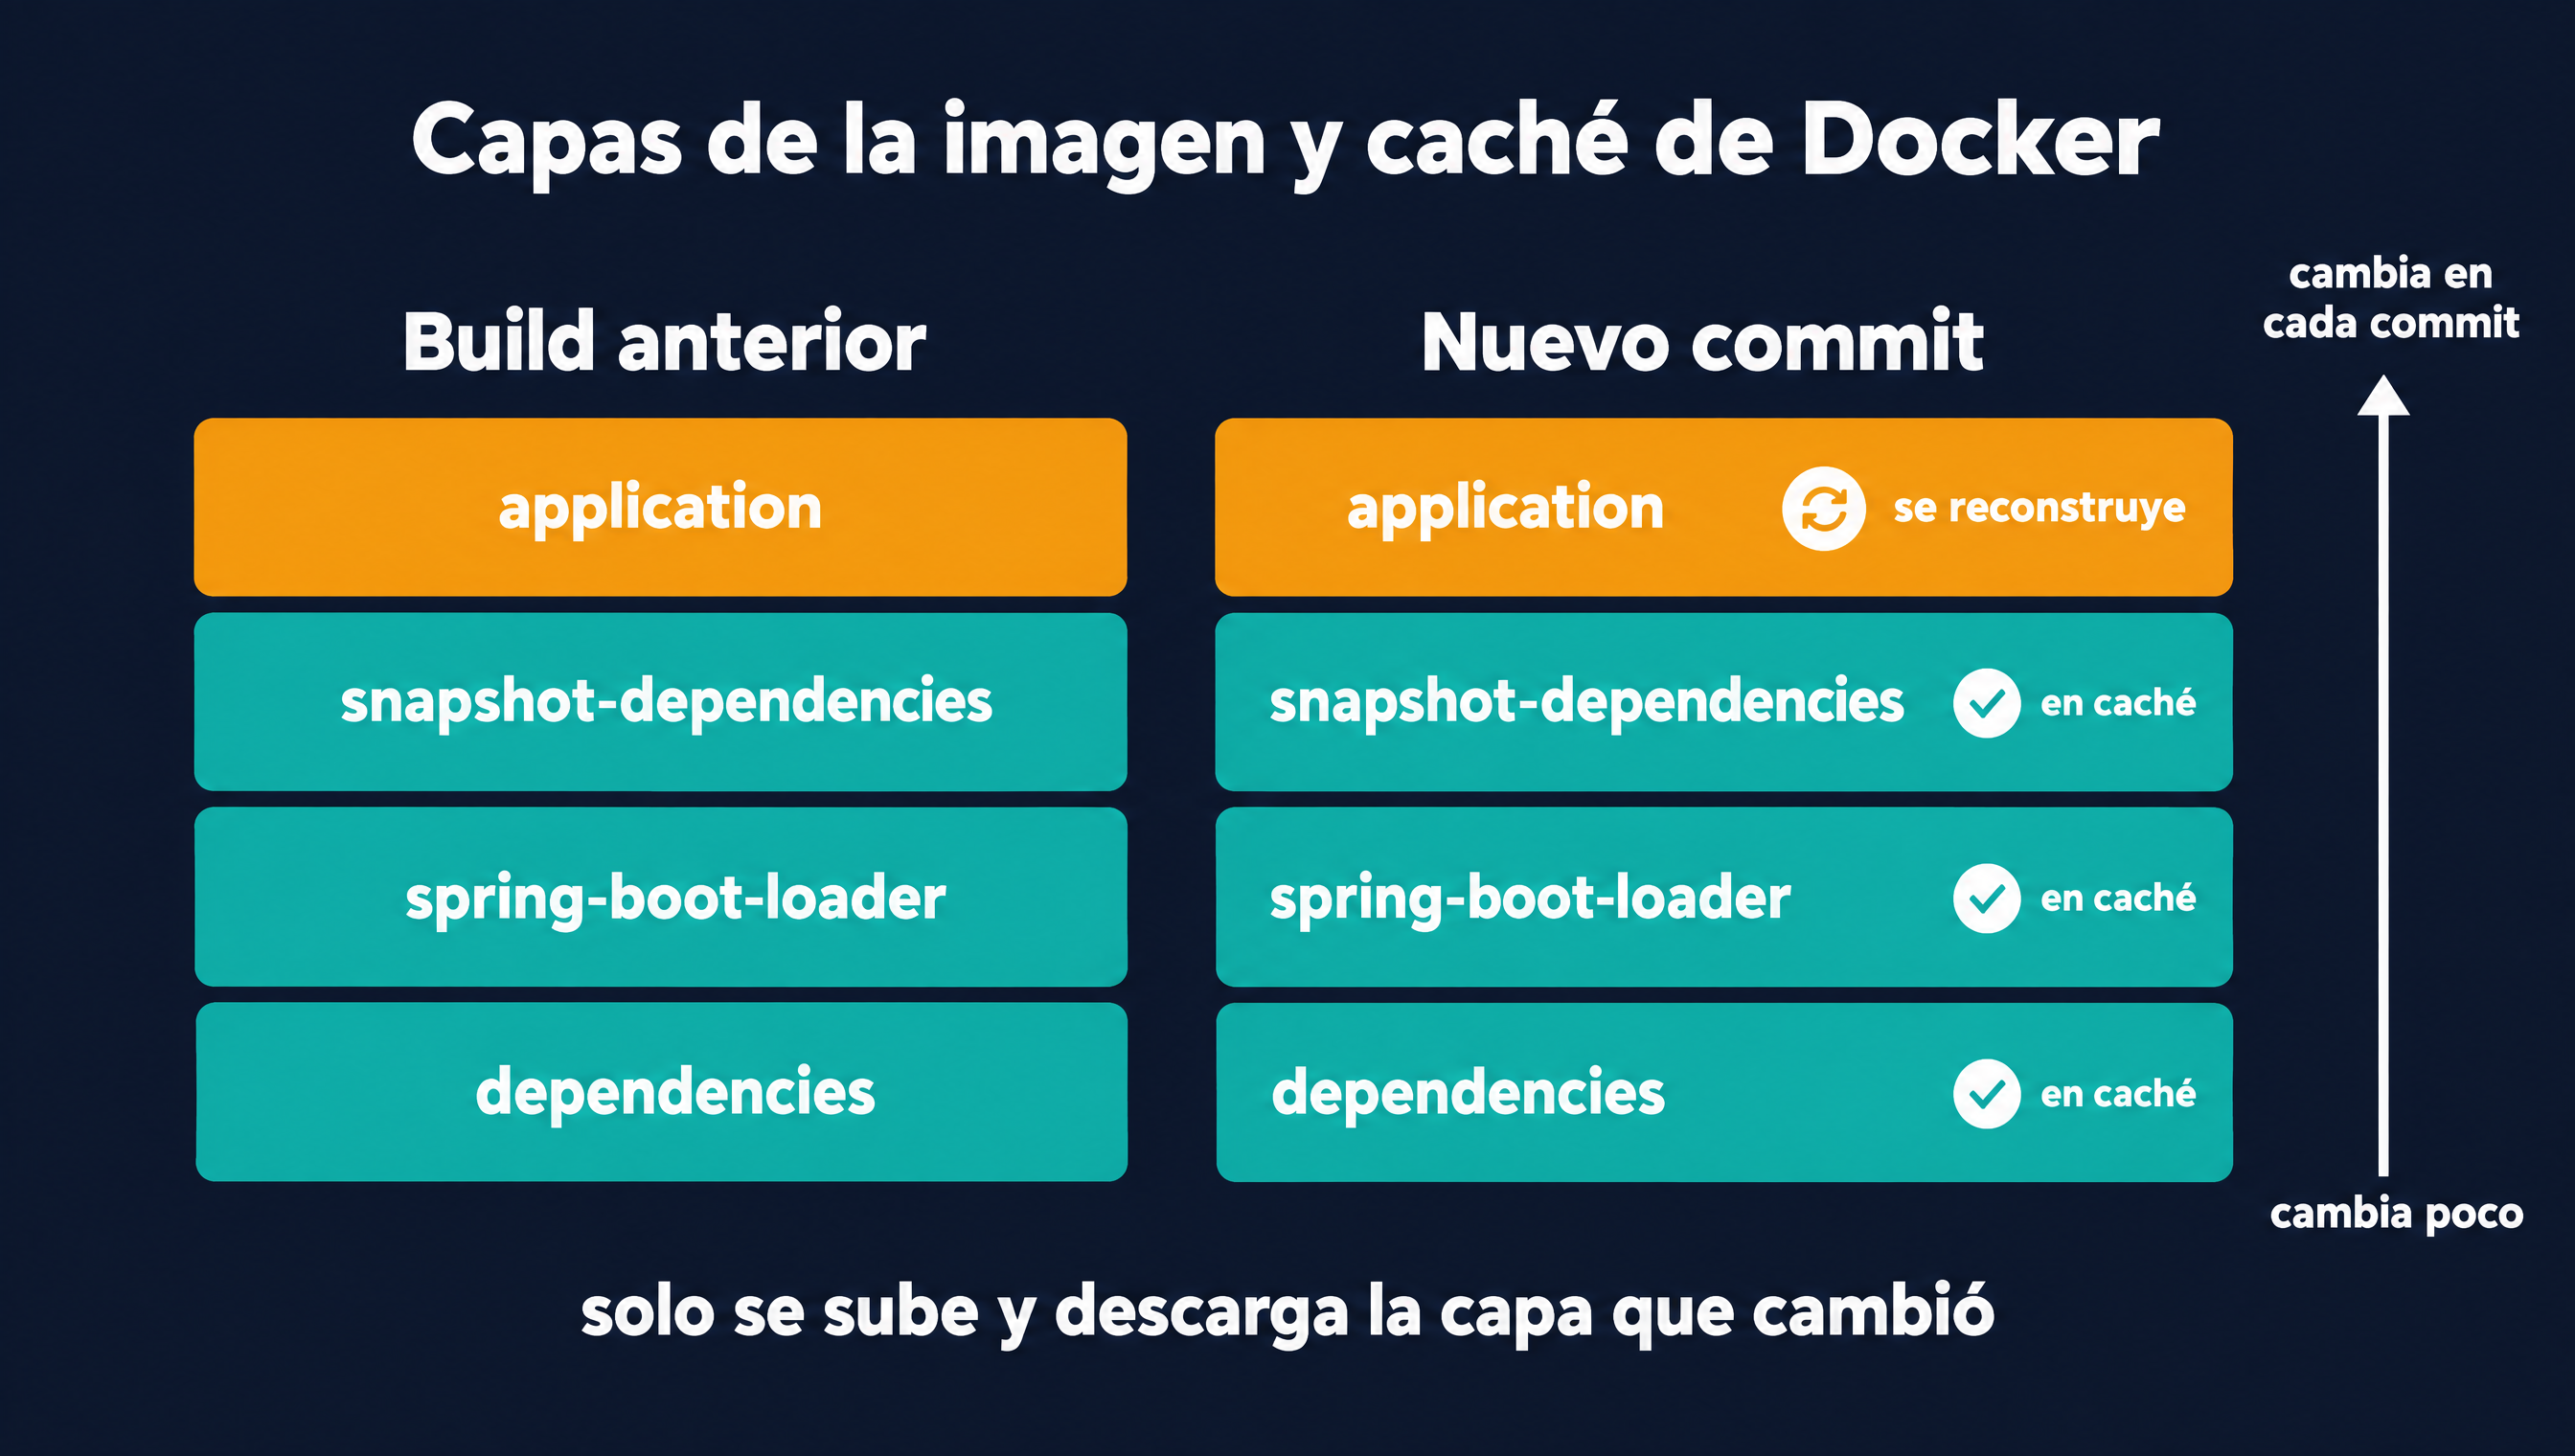
El efecto práctico es enorme. En un microservicio típico, la capa dependencies ronda los 60–100 MB y la capa application pocos cientos de KB. Cuando haces un commit que solo toca código, el docker push sube unos KB en lugar de toda la imagen, y cada nodo de Kubernetes que hace pull de la nueva versión descarga solo esa capa, porque el resto ya está en su caché local. Con decenas de servicios y varios despliegues al día, esto se nota en el tiempo del pipeline y en la factura del registro.
Si quieres ver qué capas tiene tu jar o personalizarlas (por ejemplo, separar las librerías internas de tu empresa en una capa propia), puedes listar las capas con java -Djarmode=tools -jar application.jar list-layers y definir un layers.xml en la configuración del plugin de Maven o Gradle.
Alternativa sin Dockerfile: Cloud Native Buildpacks
Spring Boot incluye una segunda forma de dockerizar la aplicación que no requiere escribir ni mantener un Dockerfile: el goal spring-boot:build-image (o la tarea bootBuildImage en Gradle), basado en Cloud Native Buildpacks.
./mvnw spring-boot:build-image \
  -Dspring-boot.build-image.imageName=registry.ejemplo.com/pedidos-service:1.0.0
El plugin usa por defecto el builder paketobuildpacks/builder-noble-java-tiny, que detecta que es una aplicación Java, elige un JRE, aplica las capas del jar, configura una calculadora de memoria para la JVM y genera una imagen sin shell que se ejecuta con un usuario no root. Se configura desde el pom.xml:
<plugin>
    <groupId>org.springframework.boot</groupId>
    <artifactId>spring-boot-maven-plugin</artifactId>
    <configuration>
        <image>
            <name>registry.ejemplo.com/${project.artifactId}:${project.version}</name>
            <env>
                <!-- Versión de Java del runtime -->
                <BP_JVM_VERSION>25</BP_JVM_VERSION>
                <!-- Entrenamiento de caché AOT durante el build -->
                <BP_JVM_AOTCACHE_ENABLED>true</BP_JVM_AOTCACHE_ENABLED>
            </env>
        </image>
    </configuration>
</plugin>
¿Cuál elegir? Los Buildpacks ganan cuando tienes muchos servicios y quieres imágenes homogéneas sin que cada equipo mantenga su Dockerfile: las actualizaciones de seguridad del JRE y de la imagen base se aplican reconstruyendo, sin tocar código. El Dockerfile gana cuando necesitas control fino: instalar un paquete del sistema, usar una imagen base corporativa aprobada por seguridad, o un build que no tiene acceso al Docker daemon. Ambas opciones son válidas en producción; lo importante es no quedarse en el Dockerfile de cuatro líneas.
Arranque más rápido: CDS y caché AOT de Java 25
En contenedores, el tiempo de arranque importa: un autoescalado que tarda 15 segundos en tener la réplica lista llega tarde al pico de tráfico. Java ofrece desde hace años Class Data Sharing (CDS), que guarda en un archivo las clases ya cargadas y verificadas para no repetir ese trabajo en cada arranque. Con JEP 483 (Java 24) evolucionó a la caché AOT, que además guarda las clases enlazadas, y con JEP 514 (Java 25) se genera en un solo paso con -XX:AOTCacheOutput.
El truco es hacer una "ejecución de entrenamiento" durante el build de la imagen. Spring Boot facilita esto con la propiedad spring.context.exit=onRefresh, que arranca el contexto completo y sale justo después, sin quedarse escuchando peticiones. Basta con añadir dos líneas al final de la etapa de runtime del Dockerfile anterior:
# ... (mismo Dockerfile de antes, tras los COPY de las capas)

# Ejecución de entrenamiento: arranca el contexto, registra las clases y sale.
# Va antes de USER spring porque escribe app.aot en /application (propiedad de root);
# en runtime el usuario spring solo necesita leerlo.
RUN java -XX:AOTCacheOutput=app.aot -Dspring.context.exit=onRefresh -jar application.jar

USER spring
ENV JAVA_TOOL_OPTIONS="-XX:MaxRAMPercentage=75 -XX:+ExitOnOutOfMemoryError"
ENTRYPOINT ["java", "-XX:AOTCache=app.aot", "-jar", "application.jar"]
Hay tres condiciones para que funcione, todas descritas en la guía de Dockerfiles de Spring Boot:
- El jar debe estar extraído, que es precisamente lo que ya hacemos con
extract --layers. Con el fat jar sin extraer la caché no se aprovecha. - La misma JVM en entrenamiento y en ejecución. Por eso el entrenamiento se hace en la misma imagen final y no en la etapa de build con el JDK.
- El entrenamiento no debe depender de servicios externos. Si al arrancar el contexto tu aplicación intenta conectar con la base de datos y no la encuentra, el
RUNfalla. Las soluciones habituales son inicialización perezosa de las conexiones, un perfil de Spring específico para el entrenamiento, o usar Buildpacks conBP_JVM_AOTCACHE_ENABLED, que automatiza el entrenamiento (aunque igualmente necesita que el contexto pueda arrancar sin sus dependencias externas).
La mejora depende de la aplicación, pero es habitual ver reducciones del tiempo de arranque de entre un tercio y la mitad sin cambiar una línea de código. Si te quedas en Java 21, usa el equivalente con CDS: -XX:ArchiveClassesAtExit=application.jsa en el entrenamiento y -XX:SharedArchiveFile=application.jsa al arrancar.
Memoria de la JVM en contenedores: evitar el OOMKilled
Este es el error que más tiempo hace perder en producción. Desde Java 10 la JVM es container-aware: lee el límite de memoria del cgroup en vez de la RAM física del nodo. Pero eso no significa que lo use bien por defecto: el heap máximo por defecto es el 25 % de la memoria del contenedor. Con un límite de 1 GiB, la aplicación solo tendrá unos 256 MB de heap y desperdiciará el resto.
La reacción habitual es poner -Xmx1g con un límite de contenedor de 1 GiB. Es peor: la JVM no solo usa heap. Necesita también metaspace para las clases, la caché de código del JIT, los stacks de cada hilo de plataforma, buffers directos de Netty o NIO y la memoria nativa del propio runtime. Si el heap ocupa todo el límite, la suma lo supera y el kernel mata el proceso con un OOMKilled, sin un OutOfMemoryError ni un stack trace que te diga qué pasó.
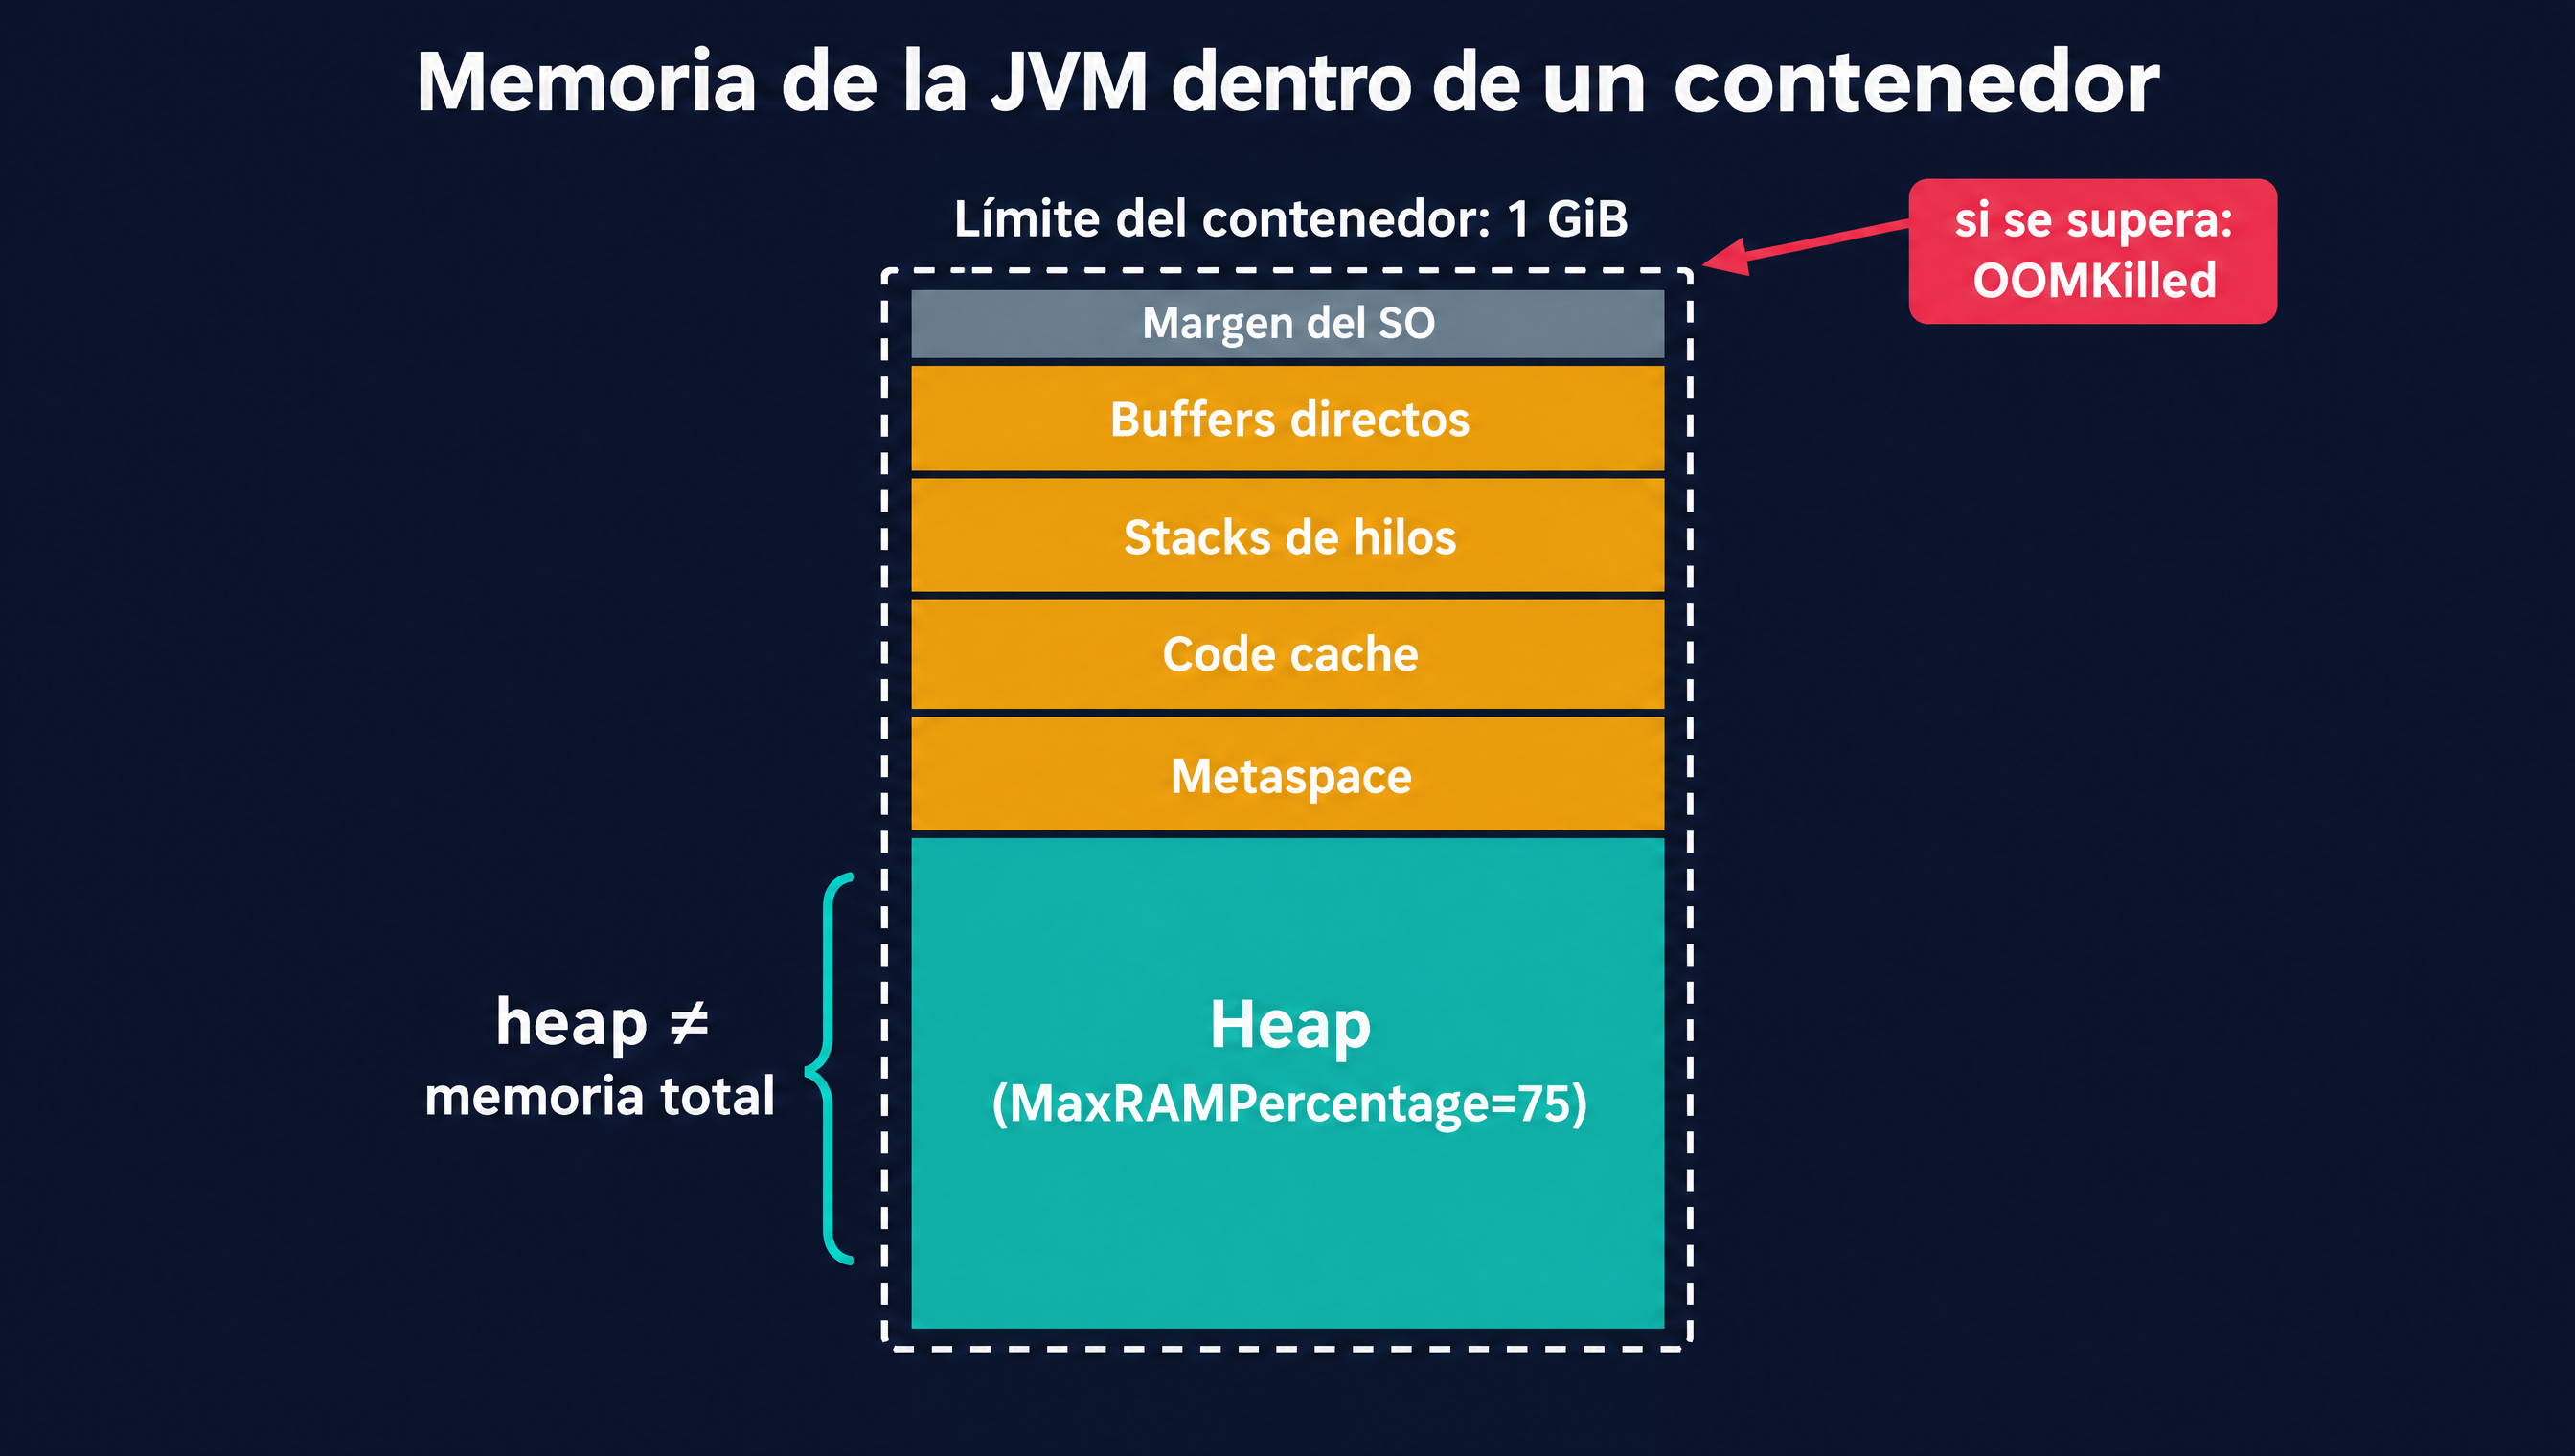
La configuración razonable es dimensionar el heap como porcentaje del límite y dejar margen para el resto:
# Valores de partida razonables para un microservicio Spring Boot típico
JAVA_TOOL_OPTIONS="-XX:MaxRAMPercentage=75 -XX:+ExitOnOutOfMemoryError"-XX:MaxRAMPercentage=75deja un 25 % para memoria no-heap. Con contenedores pequeños (512 MiB o menos) baja a 60–65 %, porque la parte no-heap no se reduce en proporción.-XX:+ExitOnOutOfMemoryErrorhace que la JVM termine en cuanto se queda sin heap, en lugar de seguir viva en un estado degradado. El orquestador la reiniciará limpia.- Usa porcentajes, no
-Xmx. Así la misma imagen funciona con 512 MiB en desarrollo y con 2 GiB en producción sin reconstruirla: solo cambia el límite del contenedor. JAVA_TOOL_OPTIONSla lee la JVM automáticamente, de modo que puedes sobrescribirla al desplegar con una variable de entorno sin tocar elENTRYPOINT.
Si usas Virtual Threads en Spring Boot, la presión de los stacks de hilos baja mucho, porque los hilos virtuales viven en el heap y son muy ligeros; los pools de hilos de plataforma de Tomcat, en cambio, reservan stack fuera del heap por cada hilo.
Configuración externa, perfiles y señales de parada
Una imagen bien construida es la misma en todos los entornos; lo que cambia es la configuración que recibe al arrancar. Es el principio de configuración en el entorno que vimos en los doce factores de una aplicación cloud-native, y Spring Boot lo resuelve con su relaxed binding: cualquier propiedad se puede pasar como variable de entorno en mayúsculas y con guiones bajos.
docker run --rm -p 8080:8080 --memory=1g \
  -e SPRING_PROFILES_ACTIVE=prod \
  -e SPRING_DATASOURCE_URL=jdbc:postgresql://db:5432/pedidos \
  -e SPRING_DATASOURCE_USERNAME=pedidos \
  -e SPRING_CONFIG_IMPORT=optional:configtree:/run/secrets/ \
  -v ./secrets:/run/secrets:ro \
  pedidos-service:1.0.0
Nunca metas secretos en la imagen con ENV ni copies un application-prod.yml con contraseñas: cualquiera con acceso al registro puede leerlos con docker history o inspeccionando las capas. Usa variables de entorno inyectadas por el orquestador, secretos montados como ficheros o un servidor de configuración. En el ejemplo, configtree: le dice a Spring Boot que cada fichero de /run/secrets/ es una propiedad: un fichero llamado spring.datasource.password con la contraseña dentro se convierte en esa propiedad, que es exactamente el formato en que Docker y Kubernetes montan los secretos.
Dos detalles del ENTRYPOINT que suelen pasarse por alto:
- Usa la forma exec (JSON),
ENTRYPOINT ["java", ...], no la forma shellENTRYPOINT java -jar .... Con la forma shell, el PID 1 es/bin/sh, que no reenvíaSIGTERMa la JVM: Docker o Kubernetes esperarán el tiempo de gracia y acabarán matando el proceso conSIGKILL. - Aprovecha el apagado ordenado. Spring Boot activa el graceful shutdown por defecto en Tomcat, Jetty y Reactor Netty: al recibir
SIGTERMdeja de aceptar peticiones nuevas y espera a que terminen las que están en curso, hastaspring.lifecycle.timeout-per-shutdown-phase(20 segundos por defecto). Asegúrate de que el tiempo de gracia del orquestador sea mayor que ese valor.
Health checks con Spring Boot Actuator
El contenedor necesita una forma de decir "estoy vivo y listo". Si ya tienes Spring Boot Actuator para monitoreo, los grupos de salud liveness y readiness encajan directamente:
# application.yml
management:
  endpoint:
    health:
      probes:
        enabled: true      # expone /actuator/health/liveness y /readiness
  endpoints:
    web:
      exposure:
        include: health,info,prometheus
En Kubernetes esos endpoints se configuran como livenessProbe y readinessProbe del pod y la instrucción HEALTHCHECK del Dockerfile se ignora. Para entornos solo Docker o Compose, puedes declararla, pero ten en cuenta que la imagen -jre no garantiza traer curl; o lo instalas explícitamente en la etapa final o defines el chequeo en el compose.yaml con una herramienta que sí exista en la imagen.
Docker Compose para desarrollo local
En local rara vez ejecutas el servicio solo: necesita su base de datos, quizás un broker. Un compose.yaml mínimo con PostgreSQL y una condición de arranque basada en salud:
# compose.yaml
services:
  db:
    image: postgres:17
    environment:
      POSTGRES_DB: pedidos
      POSTGRES_USER: pedidos
      POSTGRES_PASSWORD: pedidos
    healthcheck:
      test: ["CMD-SHELL", "pg_isready -U pedidos"]
      interval: 5s
      retries: 10

  app:
    build: .
    ports:
      - "8080:8080"
    environment:
      SPRING_DATASOURCE_URL: jdbc:postgresql://db:5432/pedidos
      SPRING_DATASOURCE_USERNAME: pedidos
      SPRING_DATASOURCE_PASSWORD: pedidos
    depends_on:
      db:
        condition: service_healthy   # espera a que Postgres responda
    deploy:
      resources:
        limits:
          memory: 1g                 # mismo límite que en producción
docker compose up --build
Si solo necesitas la infraestructura mientras ejecutas la aplicación desde el IDE, Spring Boot tiene además el módulo spring-boot-docker-compose, que detecta el compose.yaml, levanta los servicios al arrancar la aplicación y configura automáticamente las propiedades de conexión. Y para los tests de integración, el camino adecuado es Testcontainers con Spring Boot, que crea contenedores efímeros por suite de pruebas.
Errores frecuentes al dockerizar Spring Boot
- Copiar el proyecto entero antes de descargar dependencias, perdiendo la caché en cada build. Copia primero
pom.xml(obuild.gradle) y despuéssrc. - No tener
.dockerignore. Sin él,target/,.git/,.idea/ynode_modules/viajan al contexto de build, que se vuelve lento y puede filtrar ficheros que no deberían estar en la imagen. - Usar la etiqueta
latesten la imagen base y en la de la aplicación. Fija versiones (eclipse-temurin:25-jre,pedidos-service:1.0.0o el SHA del commit) para que un despliegue sea reproducible y un rollback signifique algo. - Ejecutar el build con tests dentro del Dockerfile cuando el pipeline ya los ejecutó. Duplica tiempo;
-DskipTestsen la imagen es correcto si el CI garantiza que los tests pasaron antes. - Imágenes Alpine sin pruebas. Alpine usa musl en lugar de glibc; las imágenes Temurin Alpine están soportadas, pero algunas librerías nativas (drivers, compresión, Netty con transporte nativo) se comportan distinto. Si no necesitas exprimir cada mega, una base Ubuntu o Debian "slim" evita sorpresas.
- No escanear la imagen. Herramientas como Trivy o Docker Scout detectan CVE en la imagen base y en las dependencias; intégralas en el pipeline y reconstruye periódicamente aunque el código no cambie.
Un .dockerignore mínimo para un proyecto Maven:
target/
.git/
.idea/
*.iml
.vscode/
*.log
compose.yaml
¿Cuándo no hace falta tanto?
No todo proyecto necesita la caché AOT ni capas personalizadas. Si es una herramienta interna con un despliegue al mes, el Dockerfile multietapa básico con usuario no root y MaxRAMPercentage ya cubre lo importante. Si tu organización tiene una plataforma con Buildpacks estandarizados, lo mejor es usarlos aunque pierdas algo de control. Y si lo que buscas es arranque en milisegundos y memoria mínima para funciones serverless, el camino es una imagen nativa con GraalVM, que tiene sus propios compromisos (tiempos de build largos, restricciones con reflexión) y merece un artículo aparte.
Preguntas frecuentes
¿Cómo crear una imagen Docker de una aplicación Spring Boot?
Hay dos caminos. El primero es un Dockerfile multietapa: una etapa con el JDK compila y extrae el jar en capas, y otra con solo el JRE copia esas capas y ejecuta la aplicación. El segundo, sin Dockerfile, es ejecutar ./mvnw spring-boot:build-image, que genera la imagen con Cloud Native Buildpacks.
¿Qué imagen base usar para Spring Boot en Docker?
Una imagen JRE de una distribución mantenida de OpenJDK, como eclipse-temurin:25-jre, Liberica o Amazon Corretto, con la misma versión de Java con la que compilas. Evita la imagen openjdk de Docker Hub, que está deprecada, y las imágenes con JDK completo en runtime.
¿Dockerfile o spring-boot:build-image?
Buildpacks es ideal para estandarizar muchos servicios sin mantener Dockerfiles, y ya aplica capas, usuario no root y cálculo de memoria. El Dockerfile es mejor cuando necesitas una imagen base corporativa, paquetes del sistema adicionales o control total de cada capa. Ambos son válidos en producción.
¿Cómo reducir el tamaño de la imagen Docker de Spring Boot?
Usa build multietapa para que el JDK y Maven no lleguen a la imagen final, parte de una imagen JRE en lugar de JDK y añade un .dockerignore. Más que el tamaño total, importa el tamaño de lo que cambia: extraer el jar en capas hace que cada nueva versión suba y descargue solo la capa application.
¿Por qué mi contenedor Spring Boot termina con OOMKilled?
Porque la memoria total de la JVM (heap más metaspace, caché de código, stacks de hilos y buffers directos) supera el límite del contenedor, normalmente por fijar -Xmx igual al límite. Usa -XX:MaxRAMPercentage entre 60 y 75 para dejar margen a la memoria no-heap y -XX:+ExitOnOutOfMemoryError para que la JVM termine de forma controlada.
¿Cómo paso variables de entorno o perfiles a Spring Boot en Docker?
Con -e en docker run o la sección environment de Compose. Spring Boot convierte automáticamente SPRING_PROFILES_ACTIVE en spring.profiles.active y SPRING_DATASOURCE_URL en spring.datasource.url, así que no hace falta reconstruir la imagen por entorno. Los secretos deben llegar por variables o ficheros montados, nunca escritos en la imagen.
Conclusión
Dockerizar Spring Boot bien no es mucho más difícil que hacerlo mal: es un Dockerfile de una treintena de líneas en lugar de cinco. A cambio, obtienes builds reproducibles que no dependen de la máquina de nadie, imágenes que solo llevan el JRE y tu aplicación, despliegues que suben y descargan unos pocos KB gracias a las capas, un proceso que corre sin privilegios y una JVM que usa la memoria del contenedor sin pasarse de la raya. Con Java 25 y la caché AOT, el mismo Dockerfile recorta además buena parte del tiempo de arranque, algo que se agradece cada vez que el autoescalado necesita una réplica nueva.
Si tienes pocos servicios y quieres control, quédate con el Dockerfile multietapa de este artículo; si tienes muchos y quieres homogeneidad, spring-boot:build-image te da casi lo mismo sin mantener ficheros. En ambos casos, el siguiente paso es llevar esa imagen a un orquestador con probes de salud, límites de recursos coherentes con MaxRAMPercentage y una estrategia de despliegue progresiva. La imagen es la unidad que viaja por todo el pipeline: merece el mismo cuidado que el código que contiene.