
Paginación en Spring Boot: Page, Slice y keyset (cursor) con Spring Data
Cualquier endpoint que devuelve una lista acaba necesitando paginación. Al principio la tabla tiene doscientas filas y findAll() funciona; un año después tiene veinte millones, la pantalla de pedidos tarda ocho segundos y el equipo de base de datos pregunta por qué hay un SELECT count(*) que se ejecuta trescientas veces por minuto. La paginación en Spring Boot parece resuelta con añadir un Pageable al repositorio, y para empezar lo está, pero las decisiones que tomas ahí (qué tipo devuelves, cómo ordenas, qué expones en la API) son las que deciden si el endpoint aguanta el crecimiento.
Casi todos los tutoriales se quedan en PageRequest.of(page, size) y el JSON de Page. Lo que no suelen contar es por qué la página 5.000 es mucho más lenta que la 1, cuánto cuesta el total que nadie mira, por qué Spring muestra un aviso al devolver un Page desde un controlador, qué pasa al paginar una entidad con JOIN FETCH, o que Spring Data trae desde la versión 3.1 un soporte nativo para keyset pagination (paginación por cursor) con Window y ScrollPosition. En esta guía recorremos todo eso con Spring Boot 4.1 y Spring Data JPA: offset con Page y Slice, keyset con Window, una API REST por cursor completa, índices, límites y pruebas.
¿Qué es la paginación en Spring Boot?
La paginación en Spring Boot es la técnica de devolver un conjunto grande de resultados en bloques de tamaño fijo, usando las abstracciones de Spring Data: Pageable para pedir un bloque, y Page, Slice o Window para recibirlo. Puede basarse en un desplazamiento (offset) o en la clave del último registro leído (keyset o cursor).
Ambas estrategias producen "páginas", pero la consulta que llega a la base de datos es muy distinta, y esa diferencia es la que importa cuando la tabla crece. Si ya trabajas con repositorios, el punto de partida es el mismo que vimos en Spring Data JPA: solo cambia lo que pides y lo que devuelves.
Paginación offset vs keyset: el problema de las páginas profundas
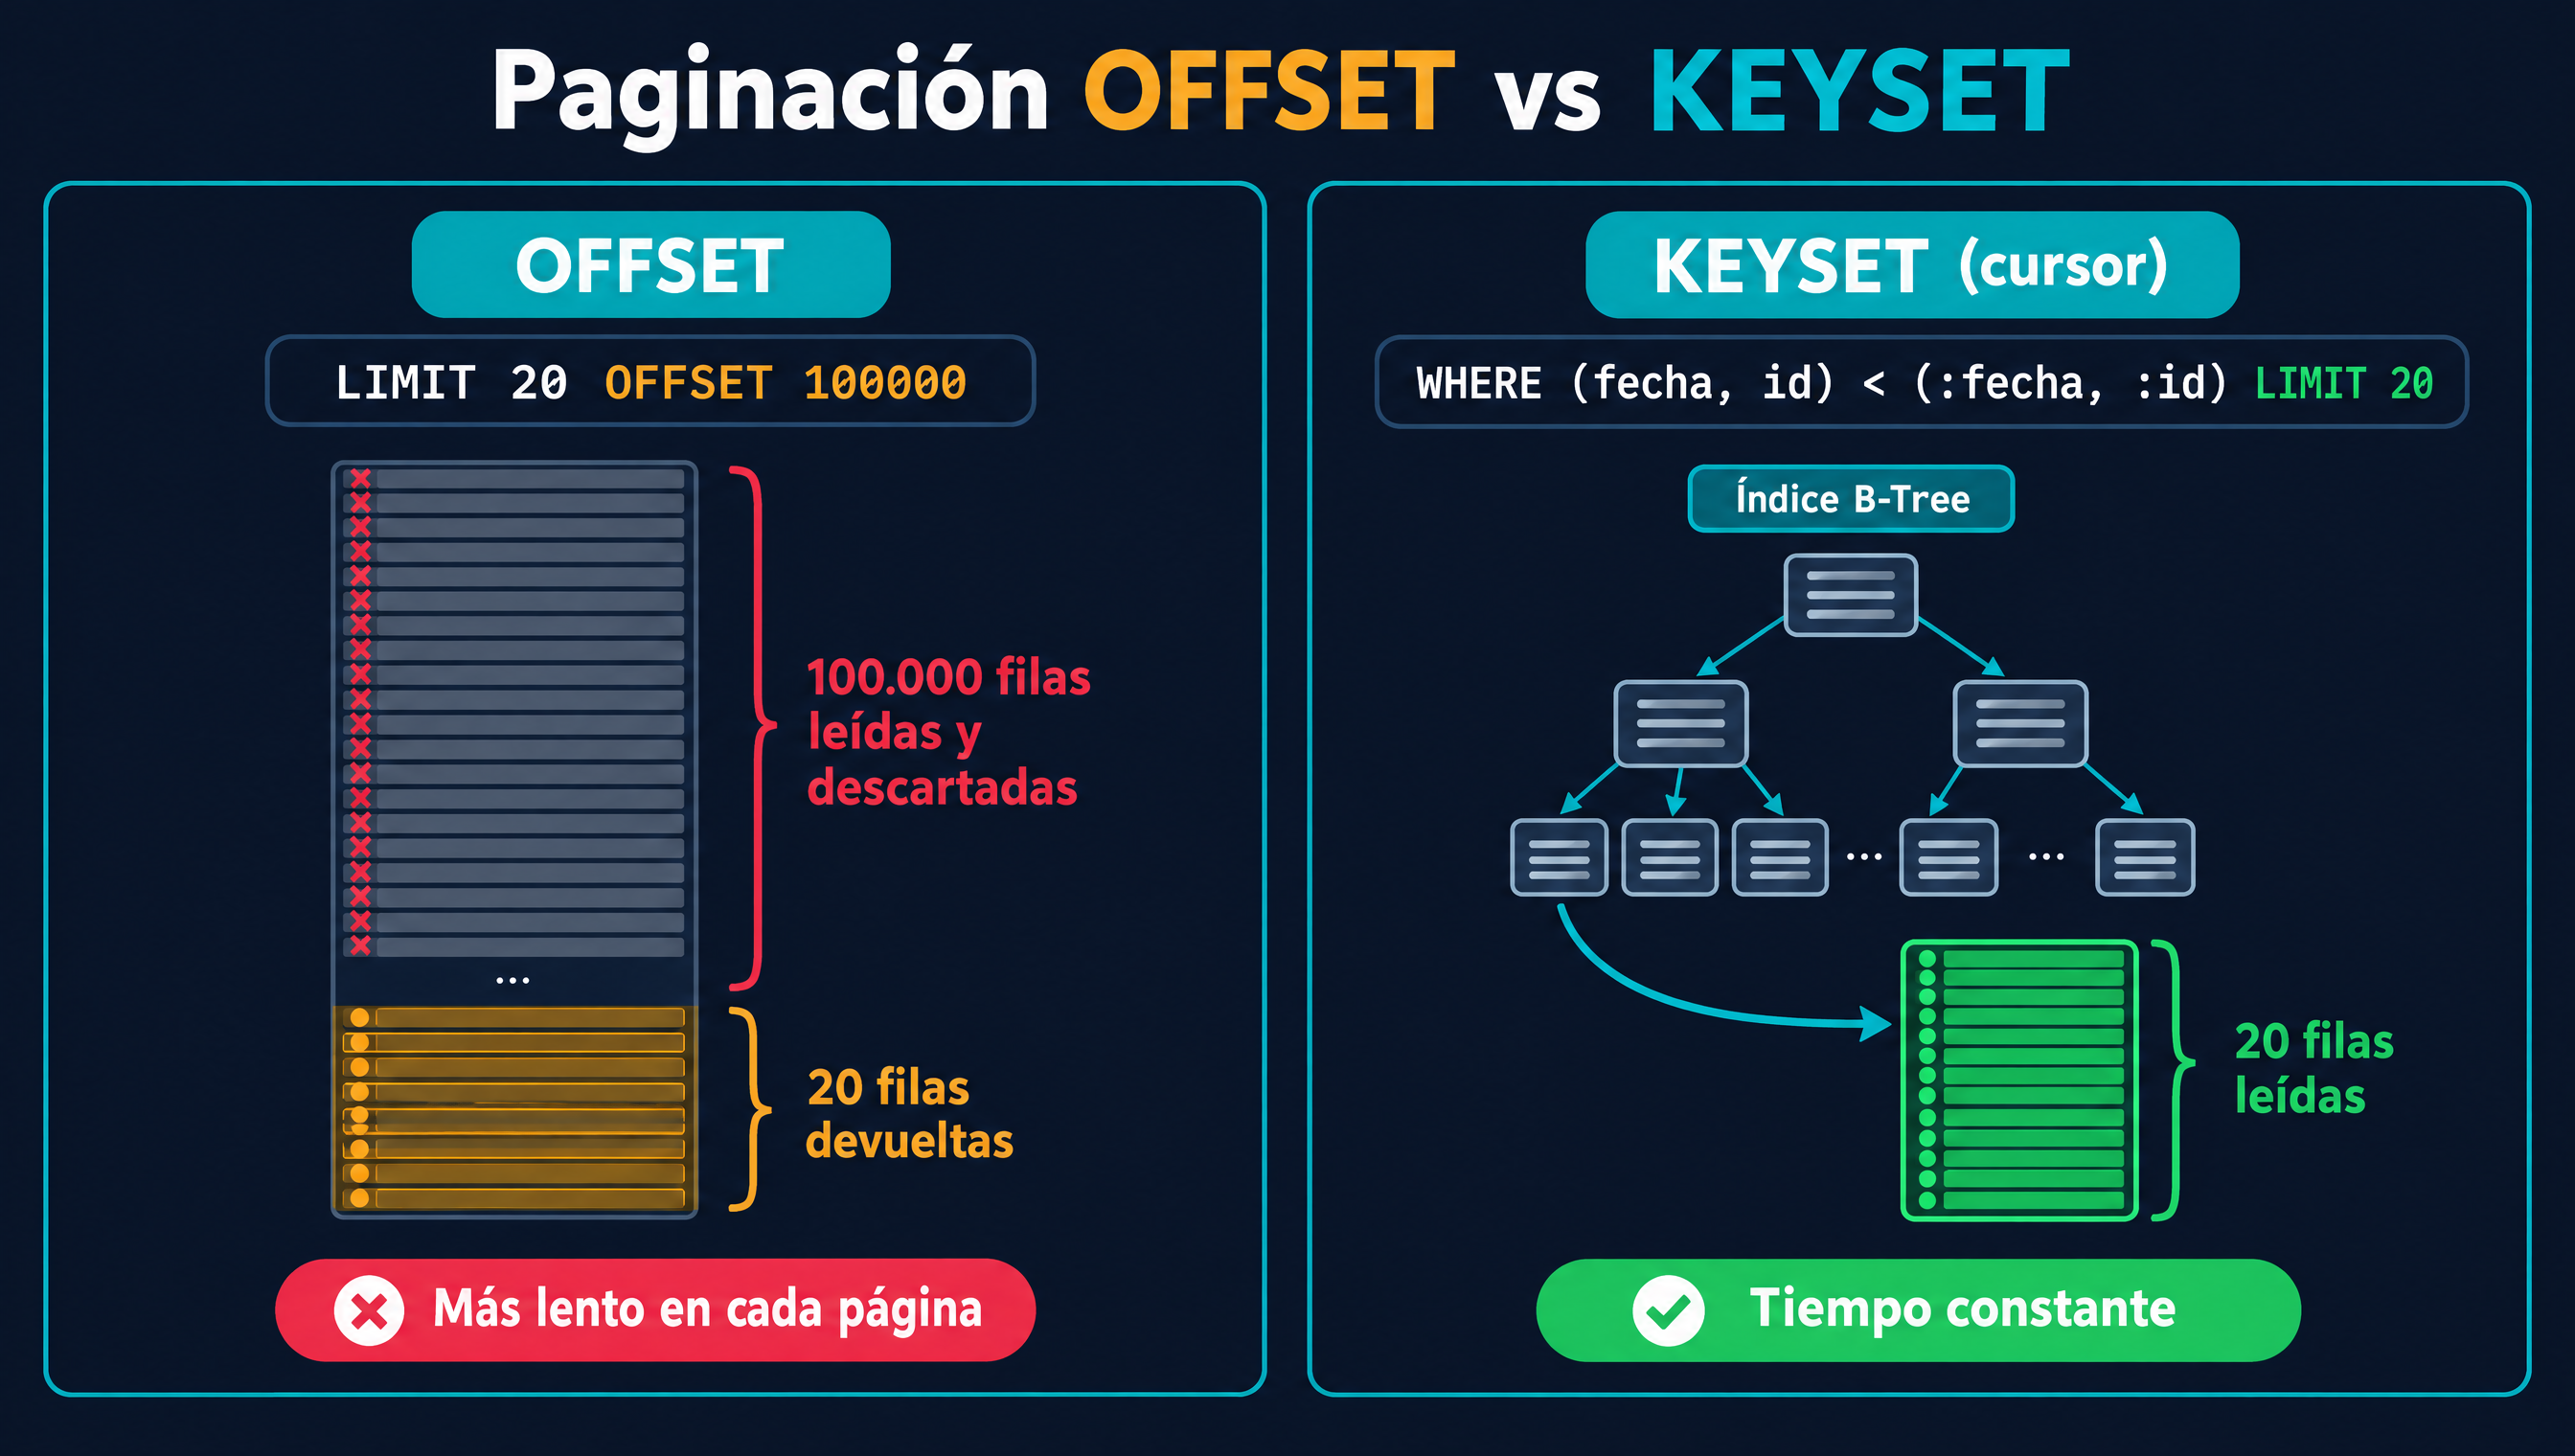
La paginación offset es la que genera Pageable: "dame 20 filas saltándote las primeras N".
SELECT * FROM pedidos
WHERE estado = 'PAGADO'
ORDER BY creado_en DESC, id DESC
LIMIT 20 OFFSET 100000;
El problema es que la base de datos no puede saltar 100.000 filas por arte de magia: tiene que recorrerlas en orden y descartarlas. La página 1 lee 20 filas; la página 5.001 lee 100.020. El coste crece linealmente con la profundidad, y además el resultado es inestable: si entra un pedido nuevo mientras el usuario pasa de página, todo se desplaza una posición y verá un registro repetido (o se saltará uno si se borró algo).
La paginación keyset (también llamada seek method o paginación por cursor) no usa posiciones, sino el valor del último registro devuelto: "dame los 20 siguientes a este".
SELECT * FROM pedidos
WHERE estado = 'PAGADO'
  AND (creado_en, id) < (:ultimoCreadoEn, :ultimoId)
ORDER BY creado_en DESC, id DESC
LIMIT 20;
Con un índice sobre (estado, creado_en, id), la base de datos baja por el árbol hasta ese punto y lee exactamente 20 filas, da igual que estés en la página 2 o en la 50.000. Y como el punto de partida es un valor y no una posición, las inserciones concurrentes no provocan duplicados ni saltos. Markus Winand lo explica con detalle en Use The Index, Luke: No Offset.
| Criterio | Offset (Page / Slice) | Keyset (Window / cursor) |
|---|---|---|
| Coste de la página N | Crece con N | Constante con un índice adecuado |
| Saltar a la página 37 | Sí | No (solo siguiente / anterior) |
| Total de resultados | Fácil (Page) | No incluido (requiere un count aparte) |
| Inserciones concurrentes | Duplicados o saltos | Estable |
| Ordenación | Cualquiera | Columnas no nulas, con desempate único |
| Caso típico | Backoffice, tablas con números de página | Scroll infinito, feeds, APIs públicas, exportaciones |
No es que una sea "la buena": offset es perfecta para un listado administrativo de pocas miles de filas donde el usuario quiere ir a la página 7. Keyset es la opción correcta cuando la tabla es grande, el usuario solo avanza o un proceso recorre todos los datos.
Paginación con Pageable: Page y Slice
Empecemos por lo clásico. La entidad de ejemplo es un pedido:
@Entity
@Table(name = "pedidos")
public class Pedido {

    @Id
    @GeneratedValue(strategy = GenerationType.IDENTITY)
    private Long id;

    @Column(nullable = false)
    private Long clienteId;

    @Enumerated(EnumType.STRING)
    @Column(nullable = false)
    private EstadoPedido estado;

    @Column(nullable = false, precision = 12, scale = 2)
    private BigDecimal total;

    @Column(name = "creado_en", nullable = false)
    private Instant creadoEn; // NOT NULL: importante para keyset

    // getters, constructor protegido para JPA...
}
El repositorio puede devolver un Page o un Slice con el mismo Pageable:
public interface PedidoRepository extends JpaRepository<Pedido, Long> {

    // Page: contenido + total de elementos y de páginas (ejecuta un COUNT)
    Page<Pedido> findByEstado(EstadoPedido estado, Pageable pageable);

    // Slice: contenido + "hay más" (sin COUNT; pide size + 1 filas)
    Slice<Pedido> findSliceByEstado(EstadoPedido estado, Pageable pageable);
}
En el servicio construyes el Pageable con un orden determinista: si solo ordenas por creadoEn y dos pedidos tienen el mismo instante, la base de datos puede devolverlos en cualquier orden y un mismo registro puede aparecer en dos páginas. Añade siempre la clave primaria como desempate.
@Service
@Transactional(readOnly = true)
public class PedidoQueryService {

    private static final Sort ORDEN = Sort.by(
            Sort.Order.desc("creadoEn"),
            Sort.Order.desc("id")); // desempate único: evita duplicados entre páginas

    private final PedidoRepository repositorio;

    public PedidoQueryService(PedidoRepository repositorio) {
        this.repositorio = repositorio;
    }

    public Page<Pedido> pagina(EstadoPedido estado, int pagina, int tamano) {
        return repositorio.findByEstado(estado, PageRequest.of(pagina, tamano, ORDEN));
    }
}
Page vs Slice: ¿cuál devolver?
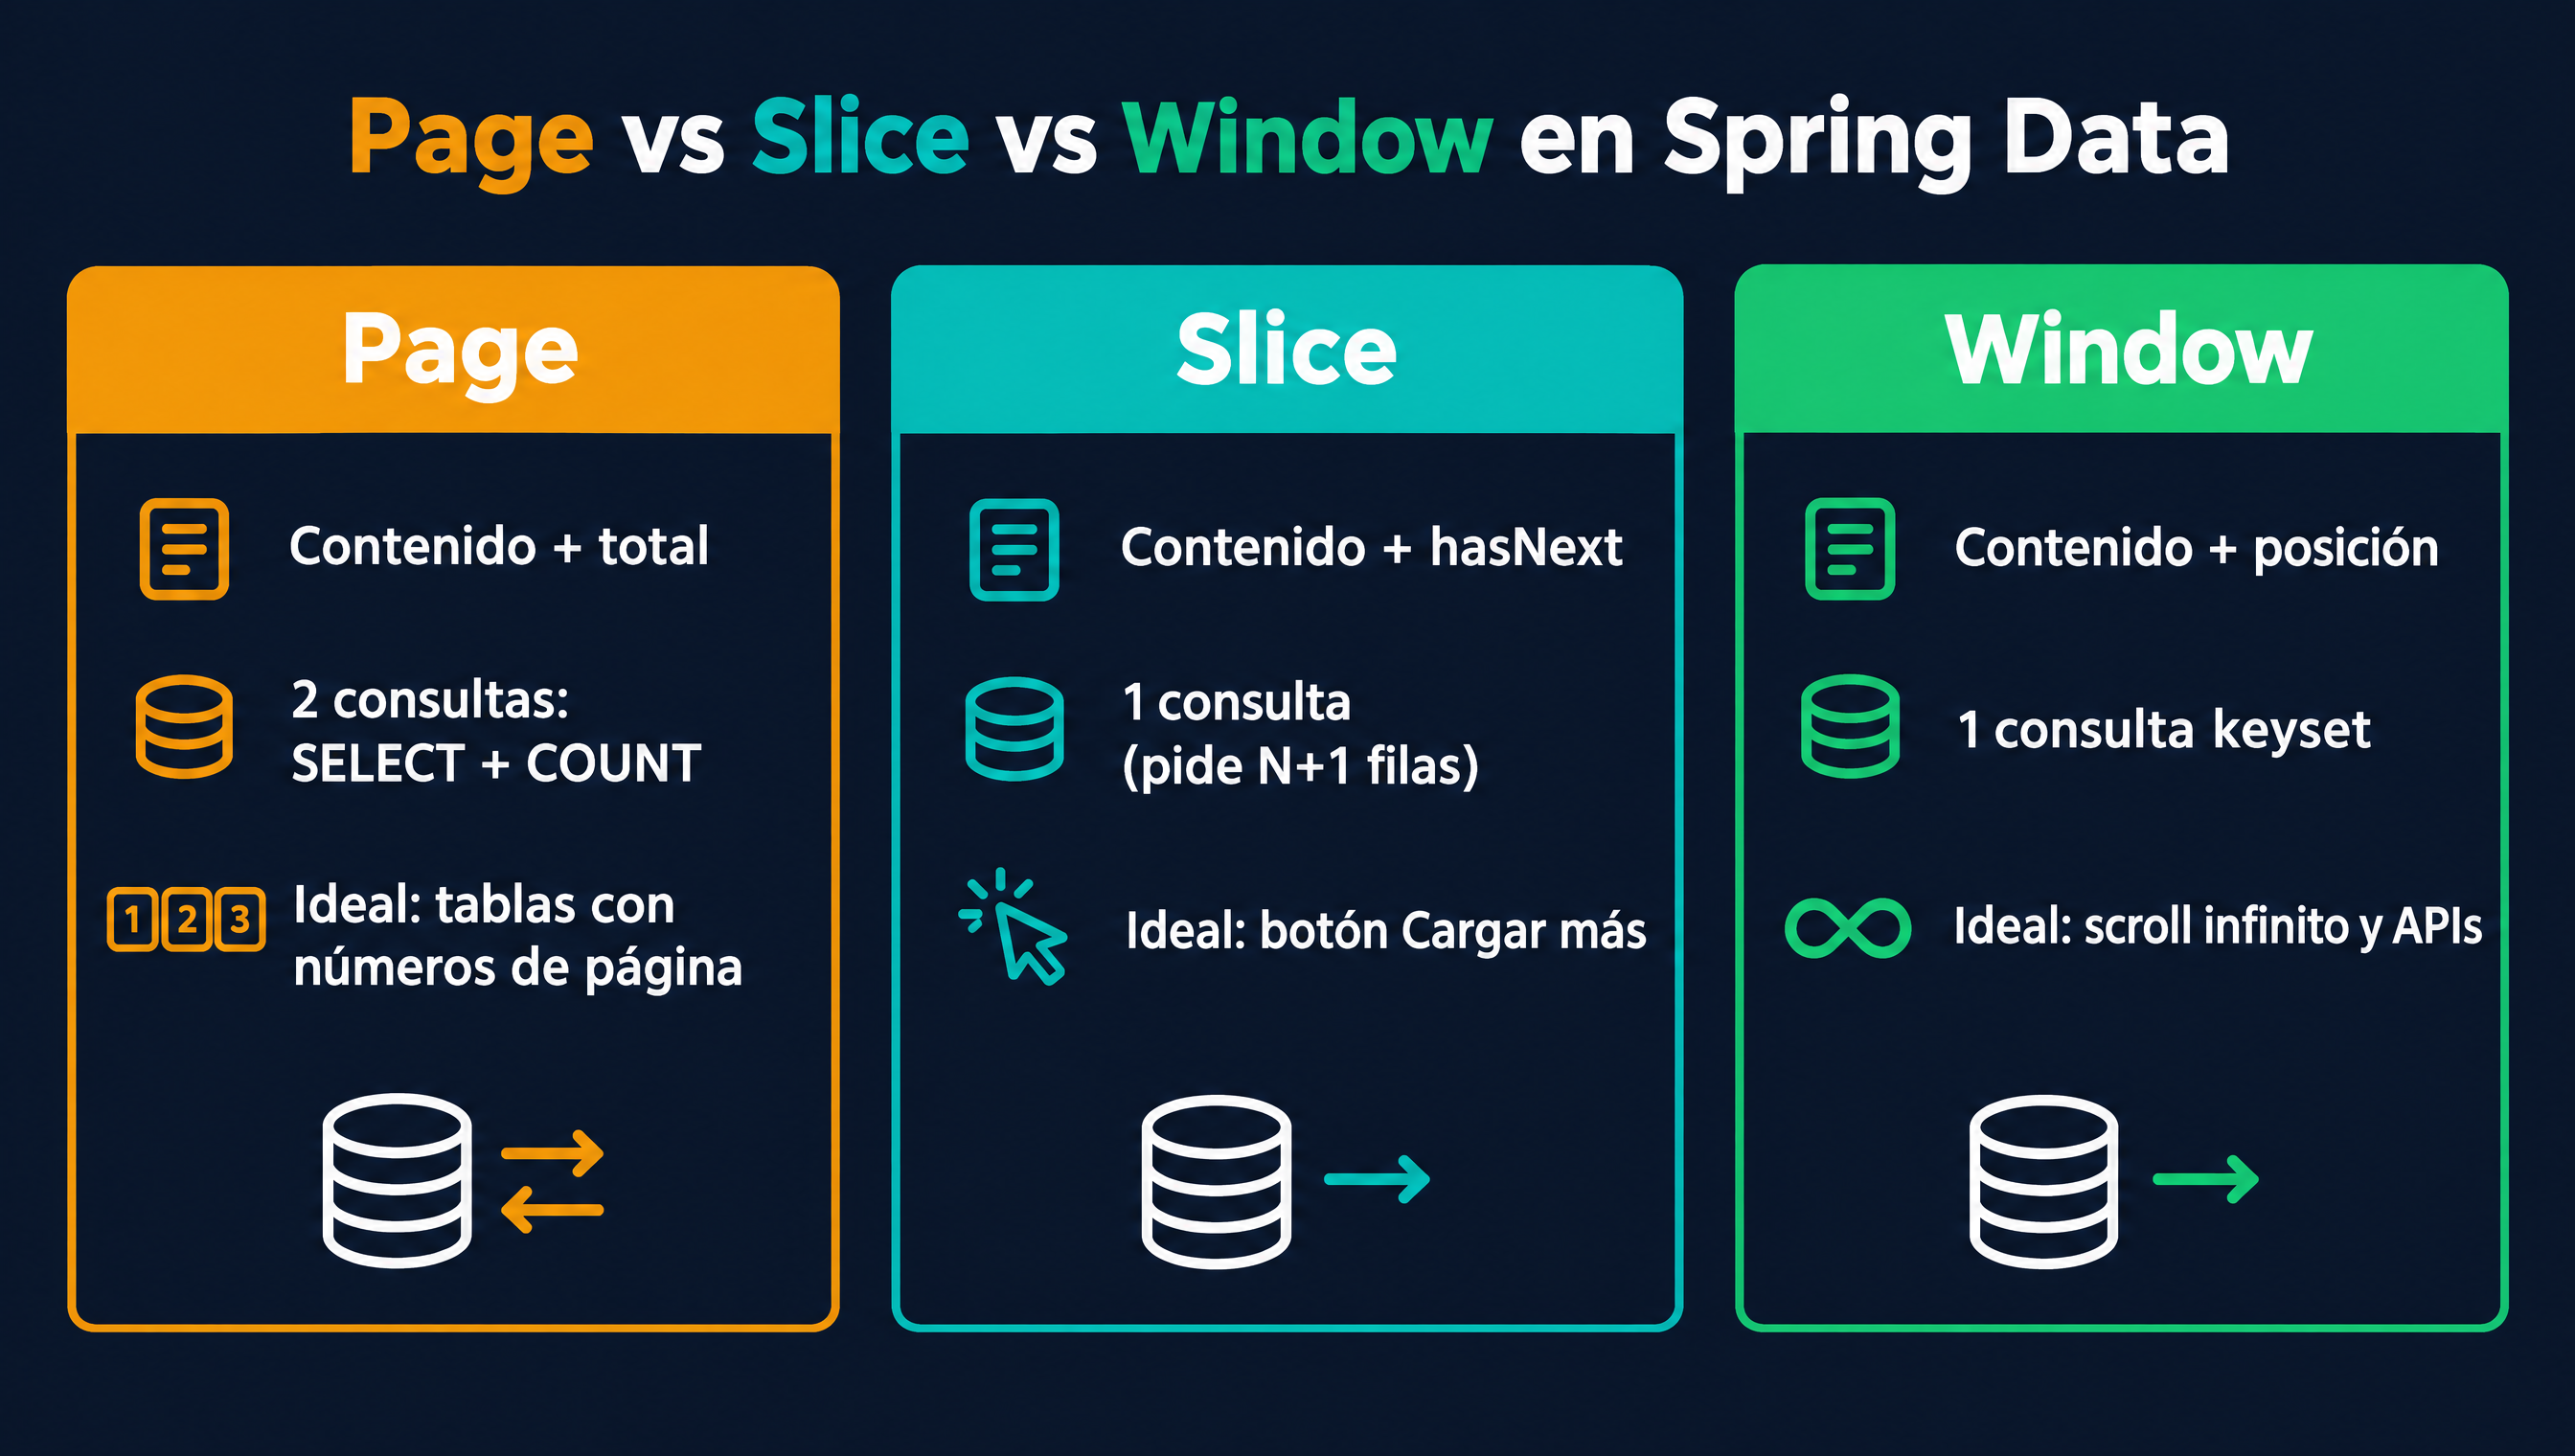
La diferencia está en la segunda consulta. Para rellenar getTotalElements() y getTotalPages(), Page ejecuta un SELECT count(*) con los mismos filtros en cada petición. En una tabla grande con filtros poco selectivos, ese conteo puede costar más que la consulta de datos. Spring Data es listo y se lo ahorra cuando la primera página ya trae menos filas que el tamaño pedido, pero en el caso habitual lo paga siempre.
Slice no cuenta nada: pide size + 1 filas y, si recibe la fila extra, sabe que hay una página siguiente (hasNext()). Es todo lo que necesita un botón "Cargar más" o un scroll infinito.
La regla práctica: devuelve Page solo si la interfaz muestra el total o los números de página. Si nadie mira el "1-20 de 48.312", estás pagando un count para nada.
Optimizar el COUNT de Page
Cuando sí necesitas Page y la consulta de datos tiene JOINs, Spring Data deriva el conteo de la misma consulta, con los mismos JOINs, aunque no afecten al número de filas. Escribe tú el conteo:
@Query(value = """
        select p from Pedido p
        join Cliente c on c.id = p.clienteId
        where p.estado = :estado and c.pais = :pais
        """,
       countQuery = """
        select count(p) from Pedido p
        join Cliente c on c.id = p.clienteId
        where p.estado = :estado and c.pais = :pais
        """)
Page<Pedido> buscarPorEstadoYPais(EstadoPedido estado, String pais, Pageable pageable);
Si el total exacto no es crítico (un listado con millones de filas), plantéate mostrar "más de 10.000", cachear el conteo unos minutos con las estrategias de caché que ya vimos, o usar la estimación del planificador de PostgreSQL (reltuples o el EXPLAIN) para un número aproximado.
Paginación en una API REST con Spring Boot
Spring Boot configura el soporte web de Spring Data automáticamente, así que un controlador puede recibir el Pageable directamente desde ?page=0&size=20&sort=creadoEn,desc:
@RestController
@RequestMapping("/api/pedidos")
public class PedidoController {

    private final PedidoRepository repositorio;

    public PedidoController(PedidoRepository repositorio) {
        this.repositorio = repositorio;
    }

    @GetMapping
    public PagedModel<PedidoResponse> listar(
            @RequestParam EstadoPedido estado,
            @PageableDefault(size = 20, sort = {"creadoEn", "id"}, direction = Sort.Direction.DESC)
            Pageable pageable) {

        Page<PedidoResponse> pagina = repositorio.findByEstado(estado, pageable)
                .map(PedidoResponse::desde); // nunca expongas la entidad JPA
        return new PagedModel<>(pagina);
    }
}
Fíjate en que devolvemos PagedModel y no Page. Serializar un PageImpl tal cual hace que Spring escriba en el log el aviso "Serializing PageImpl instances as-is is not supported": el JSON de PageImpl es un detalle interno que puede cambiar entre versiones, y tu contrato de API no debería depender de él. PagedModel produce una forma estable, documentada en la referencia de soporte web de Spring Data:
{
  "content": [ { "id": 981, "estado": "PAGADO", "total": 120.50 } ],
  "page": { "size": 20, "number": 0, "totalElements": 48312, "totalPages": 2416 }
}
Si prefieres seguir devolviendo Page en los controladores y que Spring lo traduzca por ti, activa la serialización vía DTO de forma global. Junto con eso, limita el tamaño máximo de página: el valor por defecto de Spring Data es 2.000, y nadie debería poder pedir ?size=2000 a un endpoint público.
spring:
  data:
    web:
      pageable:
        default-page-size: 20
        max-page-size: 100            # ?size=5000 se recorta a 100
        one-indexed-parameters: false # la primera página es 0
        serialization-mode: via-dto   # Page -> PagedModel automáticamente
Ordenación: no aceptes cualquier propiedad
El parámetro sort es más peligroso de lo que parece. Por defecto acepta cualquier propiedad de la entidad: un ?sort=total sobre una columna sin índice convierte la consulta en un ordenamiento completo de la tabla, y una propiedad inexistente lanza una PropertyReferenceException que, si no la capturas, acaba en un 500. Valida contra una lista blanca:
private static final Set<String> ORDENES_PERMITIDOS = Set.of("creadoEn", "total", "id");

private Pageable validar(Pageable pageable) {
    for (Sort.Order orden : pageable.getSort()) {
        if (!ORDENES_PERMITIDOS.contains(orden.getProperty())) {
            throw new ResponseStatusException(HttpStatus.BAD_REQUEST,
                    "No se puede ordenar por '" + orden.getProperty() + "'");
        }
    }
    return pageable;
}
Combínalo con un manejo de excepciones centralizado para que el cliente reciba un 400 con un mensaje claro, y asegúrate de que cada orden permitido tiene un índice que lo respalde.
Keyset pagination en Spring Boot con Window y ScrollPosition
Desde Spring Data 3.1 los repositorios entienden la API de scroll: en lugar de Pageable reciben una ScrollPosition y devuelven un Window<T>. Hay dos tipos de posición: OffsetScrollPosition (offset de toda la vida, con la misma API) y KeysetScrollPosition, que es la que nos interesa. Todo está descrito en la documentación oficial de scrolling.
public interface PedidoRepository extends JpaRepository<Pedido, Long> {

    // Límite fijo de 20 y orden estático: la forma más simple
    Window<Pedido> findFirst20ByEstadoOrderByCreadoEnDescIdDesc(
            EstadoPedido estado, KeysetScrollPosition posicion);

    // Límite dinámico (Limit está disponible desde Spring Data 3.2)
    Window<Pedido> findByEstadoOrderByCreadoEnDescIdDesc(
            EstadoPedido estado, KeysetScrollPosition posicion, Limit limite);
}
Para la primera página usas ScrollPosition.keyset(); para las siguientes, la posición del último elemento recibido:
Window<Pedido> ventana = repositorio.findByEstadoOrderByCreadoEnDescIdDesc(
        EstadoPedido.PAGADO, ScrollPosition.keyset(), Limit.of(20));

if (ventana.hasNext()) {
    // La posición es EXCLUSIVA: la siguiente ventana empieza después de este elemento
    ScrollPosition siguiente = ventana.positionAt(ventana.size() - 1);
    ventana = repositorio.findByEstadoOrderByCreadoEnDescIdDesc(
            EstadoPedido.PAGADO, (KeysetScrollPosition) siguiente, Limit.of(20));
}
Spring Data genera la condición de "a partir de este registro" con los valores de las columnas de ordenación, y además añade la clave primaria al orden si no la incluyes, para garantizar que el cursor es único. Lo que no hace por ti es cumplir las restricciones del modelo:
- Las propiedades de ordenación no pueden ser nulas. Las comparaciones con
NULLen SQL no devuelven ni verdadero ni falso, así que uncreadoEnnulo hace que se pierdan filas sin ningún error. - Deben estar en el resultado. Si usas proyecciones (interfaces o DTOs), incluye todas las propiedades del orden o la extracción del cursor falla.
- Orden estático y con índice. Un orden dinámico que cambia en cada petición multiplica los índices necesarios; elige uno o dos órdenes y crea su índice compuesto.
Recorrer toda la tabla con WindowIterator
Para procesos que necesitan leer millones de filas (una exportación, una migración de datos, un recálculo nocturno), WindowIterator encapsula el bucle y pide ventanas bajo demanda. Es una alternativa ligera a Spring Batch cuando no necesitas reinicios ni checkpoints:
public void exportarPagados(Consumer<Pedido> exportador) {
    WindowIterator<Pedido> pedidos = WindowIterator
            .of(posicion -> repositorio.findByEstadoOrderByCreadoEnDescIdDesc(
                    EstadoPedido.PAGADO, (KeysetScrollPosition) posicion, Limit.of(500)))
            .startingAt(ScrollPosition.keyset());

    while (pedidos.hasNext()) {
        exportador.accept(pedidos.next()); // cada ventana es una consulta corta e indexada
    }
}
Cada ventana es una consulta independiente, así que no mantienes una transacción ni un cursor de base de datos abiertos durante toda la exportación. Si el proceso corre dentro de una transacción larga, recuerda que el contexto de persistencia acumula todas las entidades leídas: llama a entityManager.clear() periódicamente o usa proyecciones de solo lectura.
Paginación por cursor en una API REST
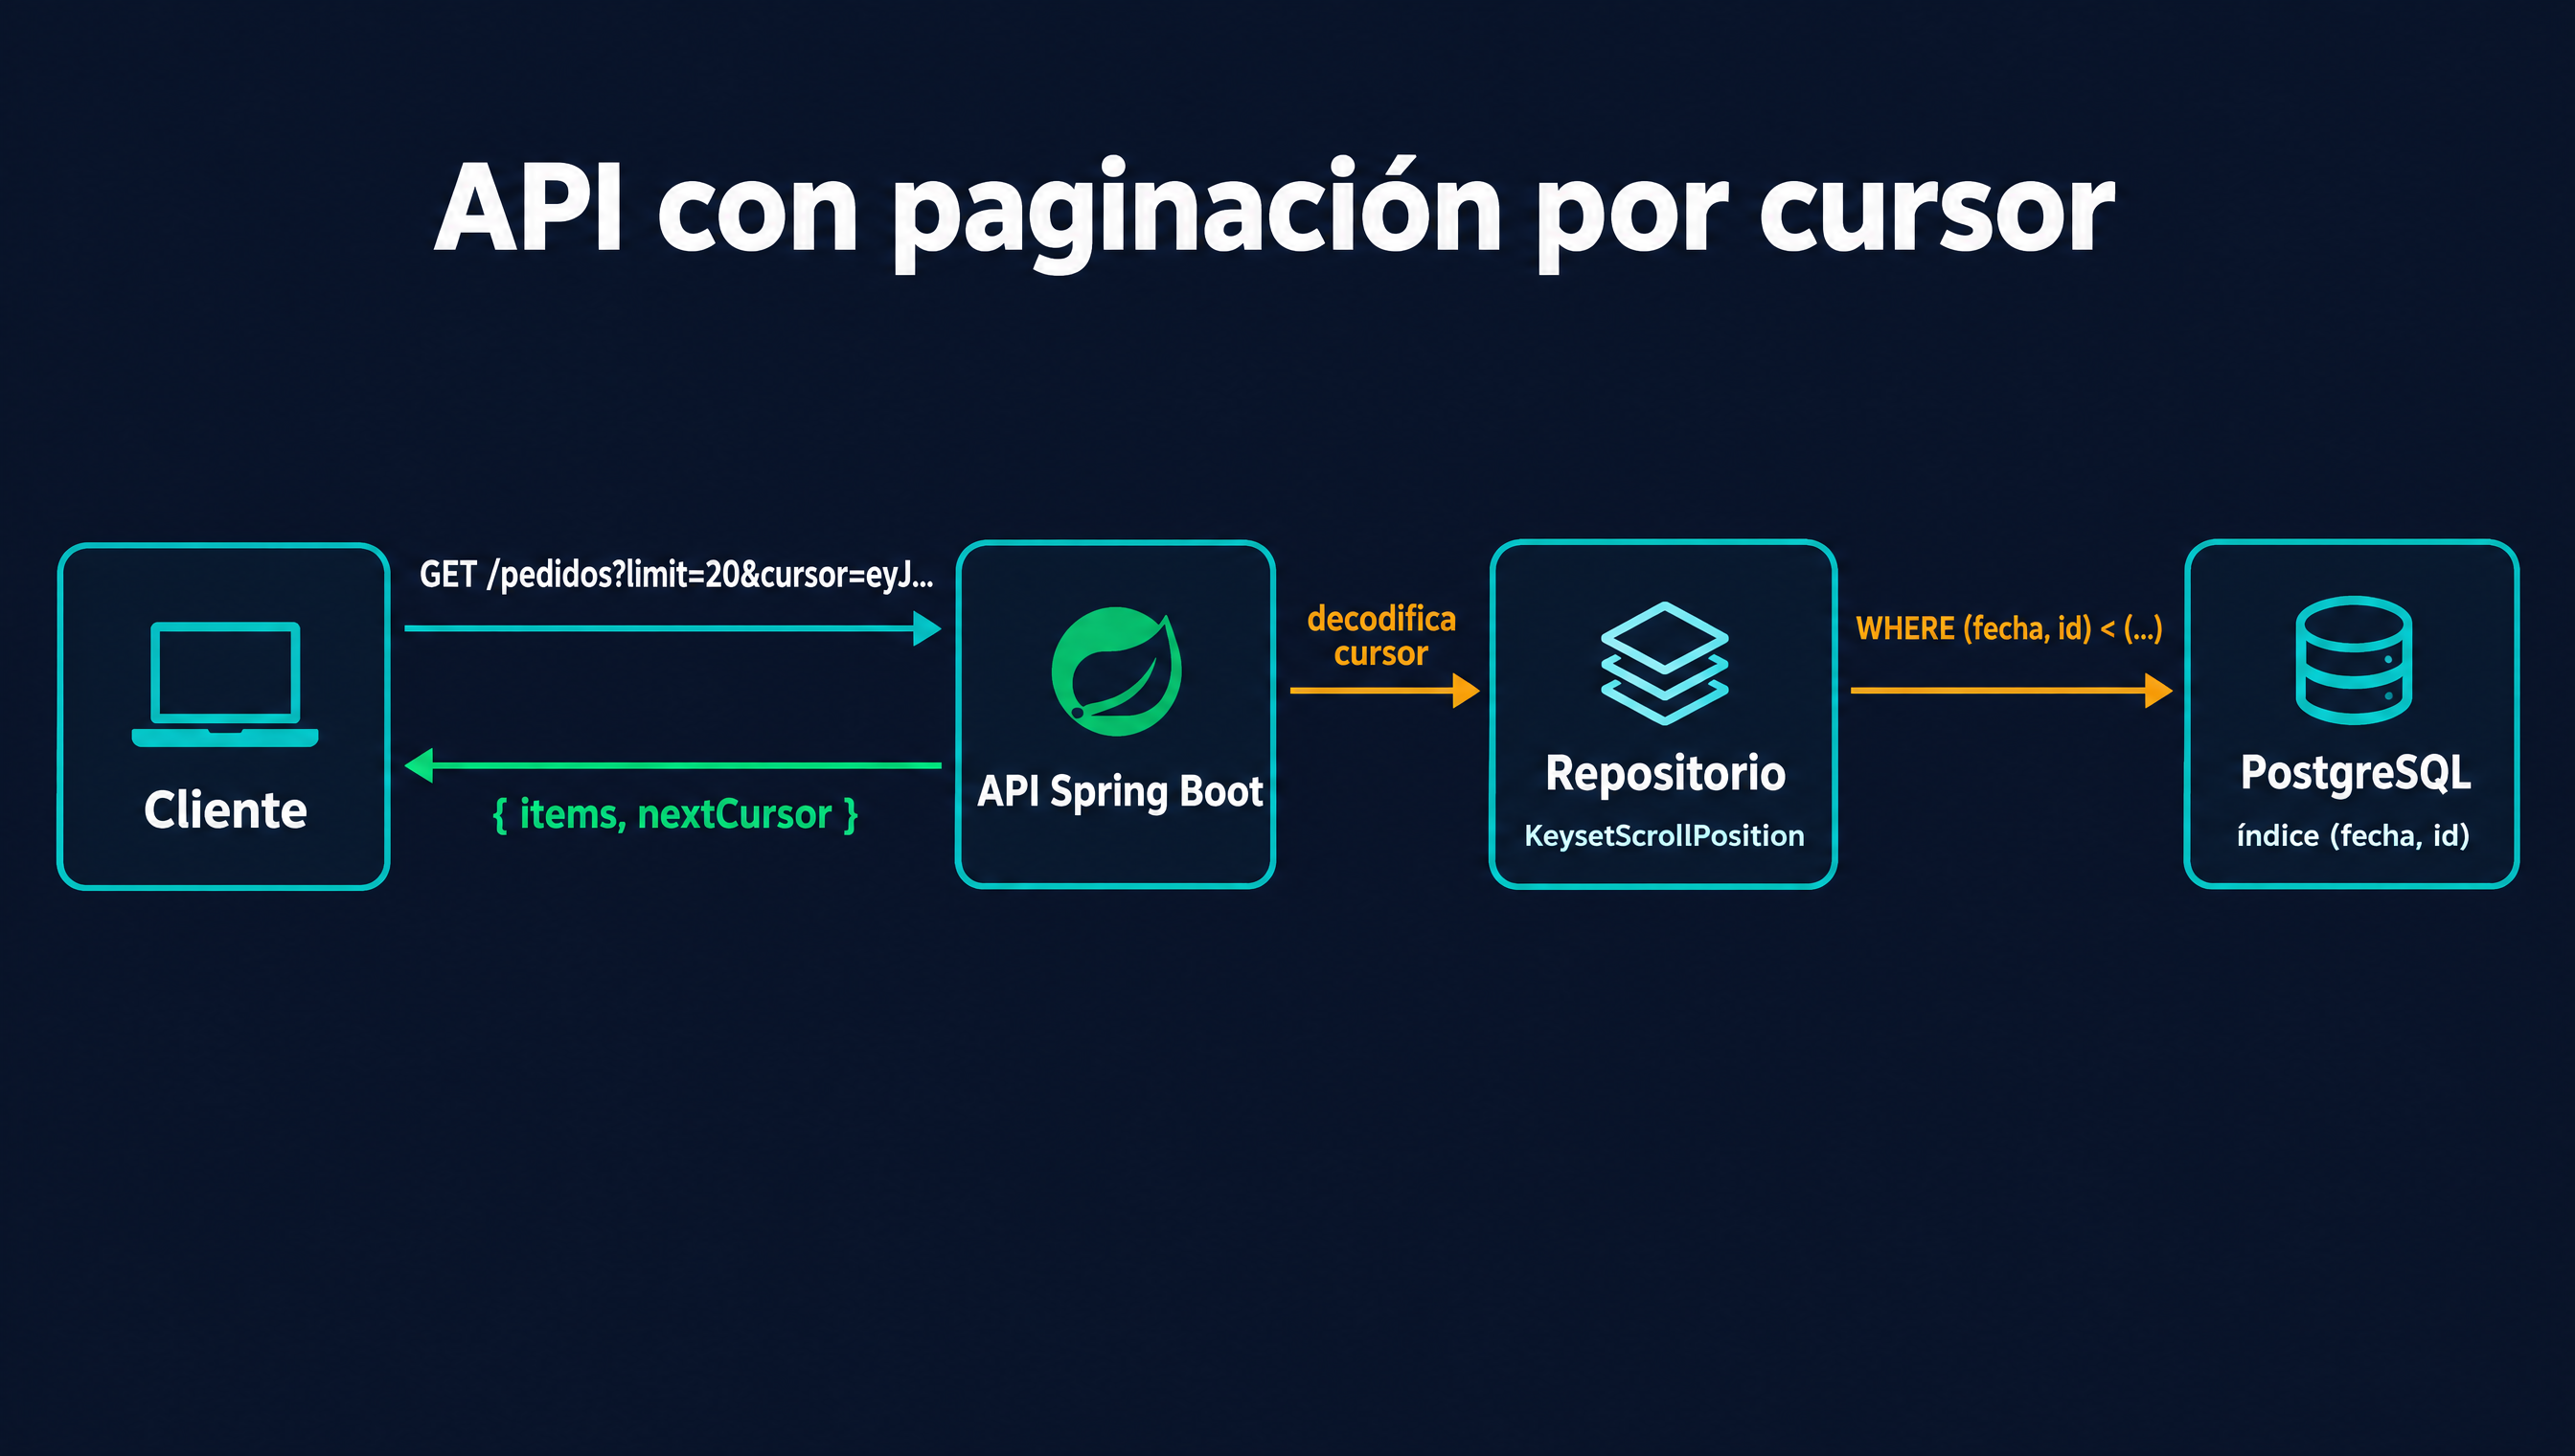 -->
Exponer keyset en una API significa devolver al cliente un cursor opaco que codifica la posición del último elemento, en lugar de un número de página. Es el modelo que usan las APIs de Stripe, Slack o GitHub, y el que siguen las connections de GraphQL que vimos en Spring GraphQL. Como ya comentamos en el artículo sobre diseño de APIs REST, el cliente no debe interpretar el cursor: solo lo reenvía.
Primero, el cursor. Podríamos serializar el Map de claves de KeysetScrollPosition, pero al ida y vuelta por JSON un Instant vuelve como String y la comparación falla. Es más robusto definir un cursor explícito y tipado:
public record CursorPedido(Instant creadoEn, long id) {

    private static final Base64.Encoder ENCODER = Base64.getUrlEncoder().withoutPadding();
    private static final Base64.Decoder DECODER = Base64.getUrlDecoder();

    public String codificar() {
        // Instant.toString() (ISO-8601) conserva la precisión completa, incluidos los microsegundos
        String crudo = creadoEn + "|" + id;
        return ENCODER.encodeToString(crudo.getBytes(StandardCharsets.UTF_8));
    }

    public static CursorPedido decodificar(String cursor) {
        try {
            String crudo = new String(DECODER.decode(cursor), StandardCharsets.UTF_8);
            int separador = crudo.lastIndexOf('|');
            return new CursorPedido(Instant.parse(crudo.substring(0, separador)),
                                    Long.parseLong(crudo.substring(separador + 1)));
        } catch (RuntimeException e) {
            // Un cursor manipulado o corrupto es un error del cliente, no un 500
            throw new ResponseStatusException(HttpStatus.BAD_REQUEST, "Cursor inválido");
        }
    }

    public KeysetScrollPosition aPosicion() {
        // Los nombres son los de las propiedades de la entidad usadas en el orden
        return ScrollPosition.forward(Map.of("creadoEn", creadoEn, "id", id));
    }

    public static CursorPedido desde(Pedido p) {
        return new CursorPedido(p.getCreadoEn(), p.getId());
    }
}
Cuidado con la precisión: PostgreSQL guarda
timestamptzcon microsegundos. Si el cursor truncaracreadoEna milisegundos (por ejemplo contoEpochMilli()), la comparación dejaría de coincidir con el valor real y podrías repetir o saltarte registros. Por eso el cursor usa el formato ISO-8601 completo deInstant.
La respuesta tiene la lista y el cursor siguiente (nulo si no hay más):
public record PaginaCursor<T>(List<T> items, String nextCursor, boolean hasNext) { }
Y el controlador queda así:
@GetMapping("/scroll")
public PaginaCursor<PedidoResponse> scroll(
        @RequestParam EstadoPedido estado,
        @RequestParam(required = false) String cursor,
        @RequestParam(defaultValue = "20") @Min(1) @Max(100) int limit) {

    KeysetScrollPosition posicion = (cursor == null)
            ? ScrollPosition.keyset()                       // primera página
            : CursorPedido.decodificar(cursor).aPosicion(); // páginas siguientes

    Window<Pedido> ventana = repositorio.findByEstadoOrderByCreadoEnDescIdDesc(
            estado, posicion, Limit.of(limit));

    String siguiente = ventana.hasNext() && !ventana.isEmpty()
            ? CursorPedido.desde(ventana.getContent().getLast()).codificar()
            : null;

    return new PaginaCursor<>(
            ventana.getContent().stream().map(PedidoResponse::desde).toList(),
            siguiente,
            ventana.hasNext());
}
El @Min y @Max sobre limit necesitan @Validated en el controlador, como vimos en validación en Spring Boot. Un detalle de diseño: el cursor solo tiene sentido con el mismo filtro y el mismo orden con los que se generó. Si el cliente cambia el estado de PAGADO a ENVIADO y reenvía el cursor, obtendrá resultados incoherentes. En APIs públicas es habitual incluir un hash de los filtros dentro del cursor (o firmarlo con HMAC) y rechazarlo si no coincide.
El índice que hace que funcione
Nada de lo anterior sirve sin el índice compuesto que coincide con el filtro y el orden. Añádelo con una migración de Flyway:
-- V12__indice_paginacion_pedidos.sql
CREATE INDEX idx_pedidos_estado_creado_id
    ON pedidos (estado, creado_en DESC, id DESC);
Comprueba con EXPLAIN (ANALYZE, BUFFERS) que el plan usa un Index Scan sin un nodo Sort encima y que el número de filas leídas es igual al limit. Si ves un Sort o un Seq Scan, el orden de las columnas del índice no coincide con el de la consulta.
Alternativa con SQL nativo y JdbcClient
Si tu consulta no encaja en un método derivado (agregaciones, varias tablas, filtros dinámicos complejos), puedes escribir el keyset a mano. En PostgreSQL y MySQL 8 la comparación de tuplas (a, b) < (x, y) es la forma más clara y aprovecha bien el índice:
public List<PedidoResumen> siguientes(EstadoPedido estado, CursorPedido cursor, int limit) {
    // Sin cursor no hay condición de keyset: es la primera página
    String condicionKeyset = (cursor == null) ? "" : "AND (creado_en, id) < (:creadoEn, :id)";

    var consulta = jdbcClient.sql("""
            SELECT id, cliente_id, total, creado_en
            FROM pedidos
            WHERE estado = :estado
            %s
            ORDER BY creado_en DESC, id DESC
            LIMIT :limit
            """.formatted(condicionKeyset))   // solo se interpola un fragmento fijo, nunca datos del cliente
        .param("estado", estado.name())
        .param("limit", limit);

    if (cursor != null) {
        consulta = consulta
            .param("creadoEn", Timestamp.from(cursor.creadoEn()))
            .param("id", cursor.id());
    }
    return consulta.query(PedidoResumen.class).list();
}
Para saber si hay más resultados sin un count, aplica el mismo truco que Slice: pide limit + 1 filas y, si llegan, descarta la última y marca hasNext = true.
Paginación con JOIN FETCH: el error que carga la tabla en memoria
Un caso clásico: quieres paginar pedidos y traer sus líneas en la misma consulta para evitar el N+1.
@Query("select p from Pedido p join fetch p.lineas where p.estado = :estado")
Page<Pedido> conLineas(EstadoPedido estado, Pageable pageable); // ¡cuidado!
SQL no puede aplicar LIMIT 20 a "20 pedidos" cuando cada pedido ocupa varias filas por sus líneas, así que Hibernate trae todos los resultados y pagina en memoria, dejando en el log el aviso HHH90003004: firstResult/maxResults specified with collection fetch; applying in memory. Con una tabla pequeña no se nota; con una grande es un OutOfMemoryError esperando turno. Haz que falle en lugar de avisar:
spring:
  jpa:
    properties:
      hibernate.query.fail_on_pagination_over_collection_fetch: true
La solución es paginar en dos pasos: primero los identificadores (paginación barata, sin colecciones) y después las entidades completas para esos identificadores.
@Query("select p.id from Pedido p where p.estado = :estado")
Slice<Long> idsPorEstado(EstadoPedido estado, Pageable pageable);

@Query("select distinct p from Pedido p join fetch p.lineas where p.id in :ids")
List<Pedido> conLineasPorIds(Collection<Long> ids);
Recuerda reordenar la segunda lista en memoria según el orden de los IDs, porque el IN no lo garantiza. Vlad Mihalcea lo explica en profundidad en la mejor forma de usar JOIN FETCH con paginación.
Probar la paginación con Testcontainers
La paginación se rompe en los bordes: la última página, los empates en el orden, las inserciones mientras se recorre. Pruébalo contra la base de datos real con Testcontainers, no contra H2, porque el comportamiento de NULL, de las tuplas y del orden de los empates depende del motor:
@DataJpaTest
@Testcontainers
@AutoConfigureTestDatabase(replace = AutoConfigureTestDatabase.Replace.NONE)
class PedidoPaginacionTest {

    @Container
    @ServiceConnection
    static PostgreSQLContainer<?> postgres = new PostgreSQLContainer<>("postgres:17-alpine");

    @Autowired PedidoRepository repositorio;

    @Test
    void recorreTodosLosPedidosSinDuplicadosAunqueCompartanFecha() {
        Instant mismoInstante = Instant.parse("2026-11-16T10:00:00Z");
        for (int i = 0; i < 95; i++) {
            // Todos con la misma fecha: solo el desempate por id evita duplicados
            repositorio.save(new Pedido(1L, EstadoPedido.PAGADO, BigDecimal.TEN, mismoInstante));
        }

        Set<Long> vistos = new HashSet<>();
        WindowIterator<Pedido> it = WindowIterator
                .of(pos -> repositorio.findByEstadoOrderByCreadoEnDescIdDesc(
                        EstadoPedido.PAGADO, (KeysetScrollPosition) pos, Limit.of(10)))
                .startingAt(ScrollPosition.keyset());

        while (it.hasNext()) {
            assertThat(vistos.add(it.next().getId())).isTrue(); // ningún repetido
        }
        assertThat(vistos).hasSize(95); // ninguno perdido, incluida la última ventana parcial
    }
}
Añade un segundo test que inserte registros entre dos llamadas: con keyset, los nuevos (más recientes que el cursor) no deben aparecer en las páginas siguientes ni desplazar las existentes.
Riesgos y trade-offs de cada estrategia
- Offset profundo como vector de abuso. Un
?page=500000es una consulta cara que cualquiera puede lanzar en bucle. Limita el número de página máximo o protege el endpoint con rate limiting. - El
countinvisible.Pageduplica las consultas y el conteo suele ser la más lenta. Mide antes de asumir que es gratis. - Keyset no permite saltar. No hay "ir a la página 37". Si el negocio lo pide, combina: keyset para navegar y un buscador o filtros para acotar.
- Orden rígido. Cada orden que ofreces con keyset necesita su índice compuesto y columnas no nulas. Diez ordenaciones posibles son diez índices que mantener en cada escritura.
- Cursores con estado implícito. Un cursor viejo, de otro filtro o manipulado debe rechazarse con un
400, no producir un500ni resultados incoherentes. - Contrato de API. Pasar de
page/sizeacursor/limites un cambio incompatible. Si ya tienes clientes, aplícalo como una nueva versión del endpoint, tal y como vimos en versionado de APIs.
¿Cuándo usar cada tipo de paginación en Spring Boot?
Usa Page en backoffices y tablas administrativas donde el usuario necesita ver el total y saltar a una página concreta, y la tabla filtrada tiene un tamaño razonable (miles o pocas decenas de miles de filas).
Usa Slice cuando solo hay "anterior / siguiente" o "cargar más", la profundidad es baja y quieres seguir usando Pageable sin pagar el conteo. Es el cambio más barato si hoy devuelves Page y nadie mira el total.
Usa keyset con Window para scroll infinito, feeds, timelines, APIs públicas o de alto tráfico, sincronizaciones entre sistemas y cualquier proceso que recorra la tabla entera. Y no pagines listas que son pequeñas por naturaleza (los estados de un pedido, los países): un límite fijo y una sola respuesta son más simples para todos.
Buenas prácticas
- Ordena siempre de forma determinista, con la clave primaria como último criterio de desempate.
- Devuelve
SliceoWindowpor defecto yPagesolo cuando la interfaz muestra el total. - Configura
max-page-sizey validalimiten endpoints de cursor; 100 es un buen techo para APIs. - No serialices
PageImpl: usaPagedModel,serialization-mode: via-dtoo tu propio DTO de respuesta. - Lista blanca de campos de ordenación, cada uno respaldado por un índice.
- Crea el índice compuesto que coincide con filtro + orden y verifica el plan con
EXPLAIN ANALYZE. - Columnas de keyset
NOT NULLy presentes en cualquier proyección. - Cursores opacos, tipados y validados, idealmente firmados y ligados a los filtros con los que se generaron.
- Nunca pagines sobre un
JOIN FETCHde colecciones: activafail_on_pagination_over_collection_fetchy pagina en dos pasos. - Prueba los bordes con la base de datos real: empates, última página parcial, inserciones concurrentes y cursores inválidos.
Preguntas frecuentes
¿Cómo se hace la paginación en Spring Boot?
Añade un parámetro Pageable al método del repositorio y devuelve Page, Slice o List. En el controlador, Spring Boot resuelve el Pageable automáticamente desde los parámetros page, size y sort de la URL. Para tablas grandes o scroll infinito, usa la API de scroll de Spring Data con ScrollPosition.keyset() y un Window como resultado.
¿Qué diferencia hay entre Page y Slice en Spring Data?
Page incluye el total de elementos y de páginas, por lo que ejecuta una consulta count adicional en cada petición. Slice solo sabe si existe una página siguiente: pide una fila de más y no cuenta nada, lo que lo hace más barato. Usa Page si la interfaz muestra el total o números de página, y Slice para "cargar más" o navegación anterior/siguiente.
¿Qué es la keyset pagination o paginación por cursor?
Es una técnica que pide "los N registros siguientes a este" usando los valores de las columnas de ordenación del último registro leído, en lugar de saltar N posiciones con OFFSET. Con un índice adecuado, el coste es constante en cualquier página y los resultados no se desplazan si se insertan registros. A cambio, no permite saltar a una página arbitraria.
¿Por qué la paginación con OFFSET es lenta en páginas altas?
Porque la base de datos tiene que leer y descartar todas las filas anteriores al offset antes de devolver las que pediste: OFFSET 100000 recorre más de cien mil filas para devolver veinte. El coste crece con la profundidad de la página. La paginación keyset evita ese recorrido usando el índice para empezar justo después del último registro.
¿Cómo evitar el aviso "Serializing PageImpl instances as-is is not supported"?
Devuelve un PagedModel (new PagedModel<>(page)) o tu propio DTO de respuesta en lugar del Page directamente. También puedes activar la conversión global con spring.data.web.pageable.serialization-mode=via-dto o con @EnableSpringDataWebSupport(pageSerializationMode = VIA_DTO), y Spring traducirá cada Page a una estructura JSON estable.
¿Se puede usar paginación con JOIN FETCH en Spring Data JPA?
No directamente con colecciones: Hibernate no puede aplicar el LIMIT en SQL y pagina en memoria tras cargar todos los resultados, con el aviso HHH90003004. La solución es paginar primero los identificadores y, en una segunda consulta, cargar las entidades con JOIN FETCH para esos IDs. Activa hibernate.query.fail_on_pagination_over_collection_fetch para detectar el problema en desarrollo.
Conclusión
La paginación en Spring Boot empieza con un Pageable y una línea de código, y por eso es fácil no volver a pensar en ella hasta que el endpoint se convierte en el más lento del sistema. Las decisiones importantes son pocas: qué devuelves (Page solo si alguien mira el total, Slice o Window en el resto de casos), con qué orden (determinista y con índice) y qué contrato expones (page/size para tablas administrativas, cursor opaco para APIs y scroll infinito).
Si te quedas con lo esencial: ordena siempre con la clave primaria como desempate, limita el tamaño de página, no serialices PageImpl, desconfía del count y de los JOIN FETCH paginados, y cuando la tabla crezca pasa a keyset con Window y ScrollPosition, que Spring Data ya trae de serie. Con un índice compuesto que encaje con el filtro y el orden, la página 50.000 responde igual de rápido que la primera, y la base de datos deja de pagar por filas que nadie va a ver.


