
Jev de TypeSafe AI: qué es el modelo que decide sin escribir y cómo usarlo desde Java
Buena parte de lo que hoy hacemos con un LLM en producción no es "escribir". Es decidir: ¿este ticket va a facturación o a soporte técnico?, ¿este comentario es tóxico?, ¿esta transacción necesita revisión humana?, ¿este agente está a punto de ejecutar un comando peligroso? Para responder un "sí" o un "billing", pagamos a un modelo que genera texto token a token, esperamos segundos, parseamos un JSON que a veces llega mal formado y rezamos para que no invente una categoría que no existe. Jev de TypeSafe AI nace exactamente contra ese desperdicio: es un modelo que no puede generar ni una palabra y que, a cambio, devuelve decisiones tipadas con probabilidades en milisegundos.
Desde su lanzamiento el 15 de septiembre de 2026, Jev ha pasado de curiosidad en X a tema de conversación en toda la industria: una ronda de 870 millones de dólares a menos de un mes de existir, integraciones en Vercel AI SDK y Cloudflare, y también las primeras críticas serias de seguridad. En este artículo explico qué es Jev, cómo funcionan sus tres primitivas, cuánto cuesta, qué dicen sus críticos y —lo que no vas a encontrar en las coberturas en español— cómo integrarlo en un servicio Spring Boot con umbrales de confianza y un fallback a un LLM.
¿Qué es Jev de TypeSafe AI?
Jev es el primer "System One Model" de TypeSafe AI: un modelo de IA que recibe un estado no estructurado (texto) y un conjunto de preguntas cerradas, y devuelve en una sola pasada decisiones tipadas —una opción, una puntuación o una probabilidad de sí/no— con su nivel de confianza. No genera texto, por lo que su salida siempre es parseable.
La propia empresa lo resume como "a frontier-intelligence function call": estado desestructurado de entrada, decisiones probabilísticas tipadas de salida. La analogía es útil para un desarrollador backend. Igual que llamas a isFraud(transaction) y esperas un boolean, con Jev llamas a una "función" cuya implementación es un modelo entrenado, y su firma está garantizada por la arquitectura, no por un prompt que pide "responde solo con JSON".
TypeSafe AI salió de dos años en modo stealth con 40 millones de dólares de ronda semilla. Su fundador y CEO, Diogo Almeida, trabajó en OpenAI en los métodos de seguimiento de instrucciones (RLHF) que acabaron siendo la base de ChatGPT. El 9 de octubre, la compañía cerró una ronda de 870 millones de dólares con una valoración de 7.500 millones, liderada por Andreessen Horowitz con Sequoia y DCVC, y aseguró que alrededor de un tercio de las Fortune 500 ya lo estaba probando.
¿Por qué se llama "System One"?
El nombre viene de Pensar rápido, pensar despacio, de Daniel Kahneman. El Sistema 1 es el pensamiento rápido e intuitivo; el Sistema 2, el lento y deliberado. Los LLM con razonamiento serían el Sistema 2: piensan en voz alta, generan cadenas largas y tardan segundos o minutos. Jev quiere ser el Sistema 1 de una aplicación: la intuición experta que decide en 100 milisegundos sin explicar por qué. Y el nombre "Jev" es un guiño a la paradoja de Jevons: si una decisión inteligente cuesta casi nada, el número total de decisiones automatizadas se dispara.
Jev vs LLM: decidir en una pasada en lugar de generar token a token
Un LLM es autoregresivo: produce el token 1, lo usa para producir el 2, y así sucesivamente. Aunque la respuesta sea "billing", el modelo está muestreando sobre un vocabulario de decenas de miles de tokens, y nada le impide producir "Billing department", "facturación" o una explicación de tres párrafos. Por eso existen los structured outputs, el function calling y los reintentos de parseo.
Jev invierte el planteamiento. Lee el estado una vez y responde todas las preguntas en paralelo, cada una restringida a su espacio de salida. Si preguntas por una categoría entre tres, la salida es una distribución de probabilidad sobre esas tres. No hay vocabulario libre, así que no hay forma de que aparezca una cuarta.
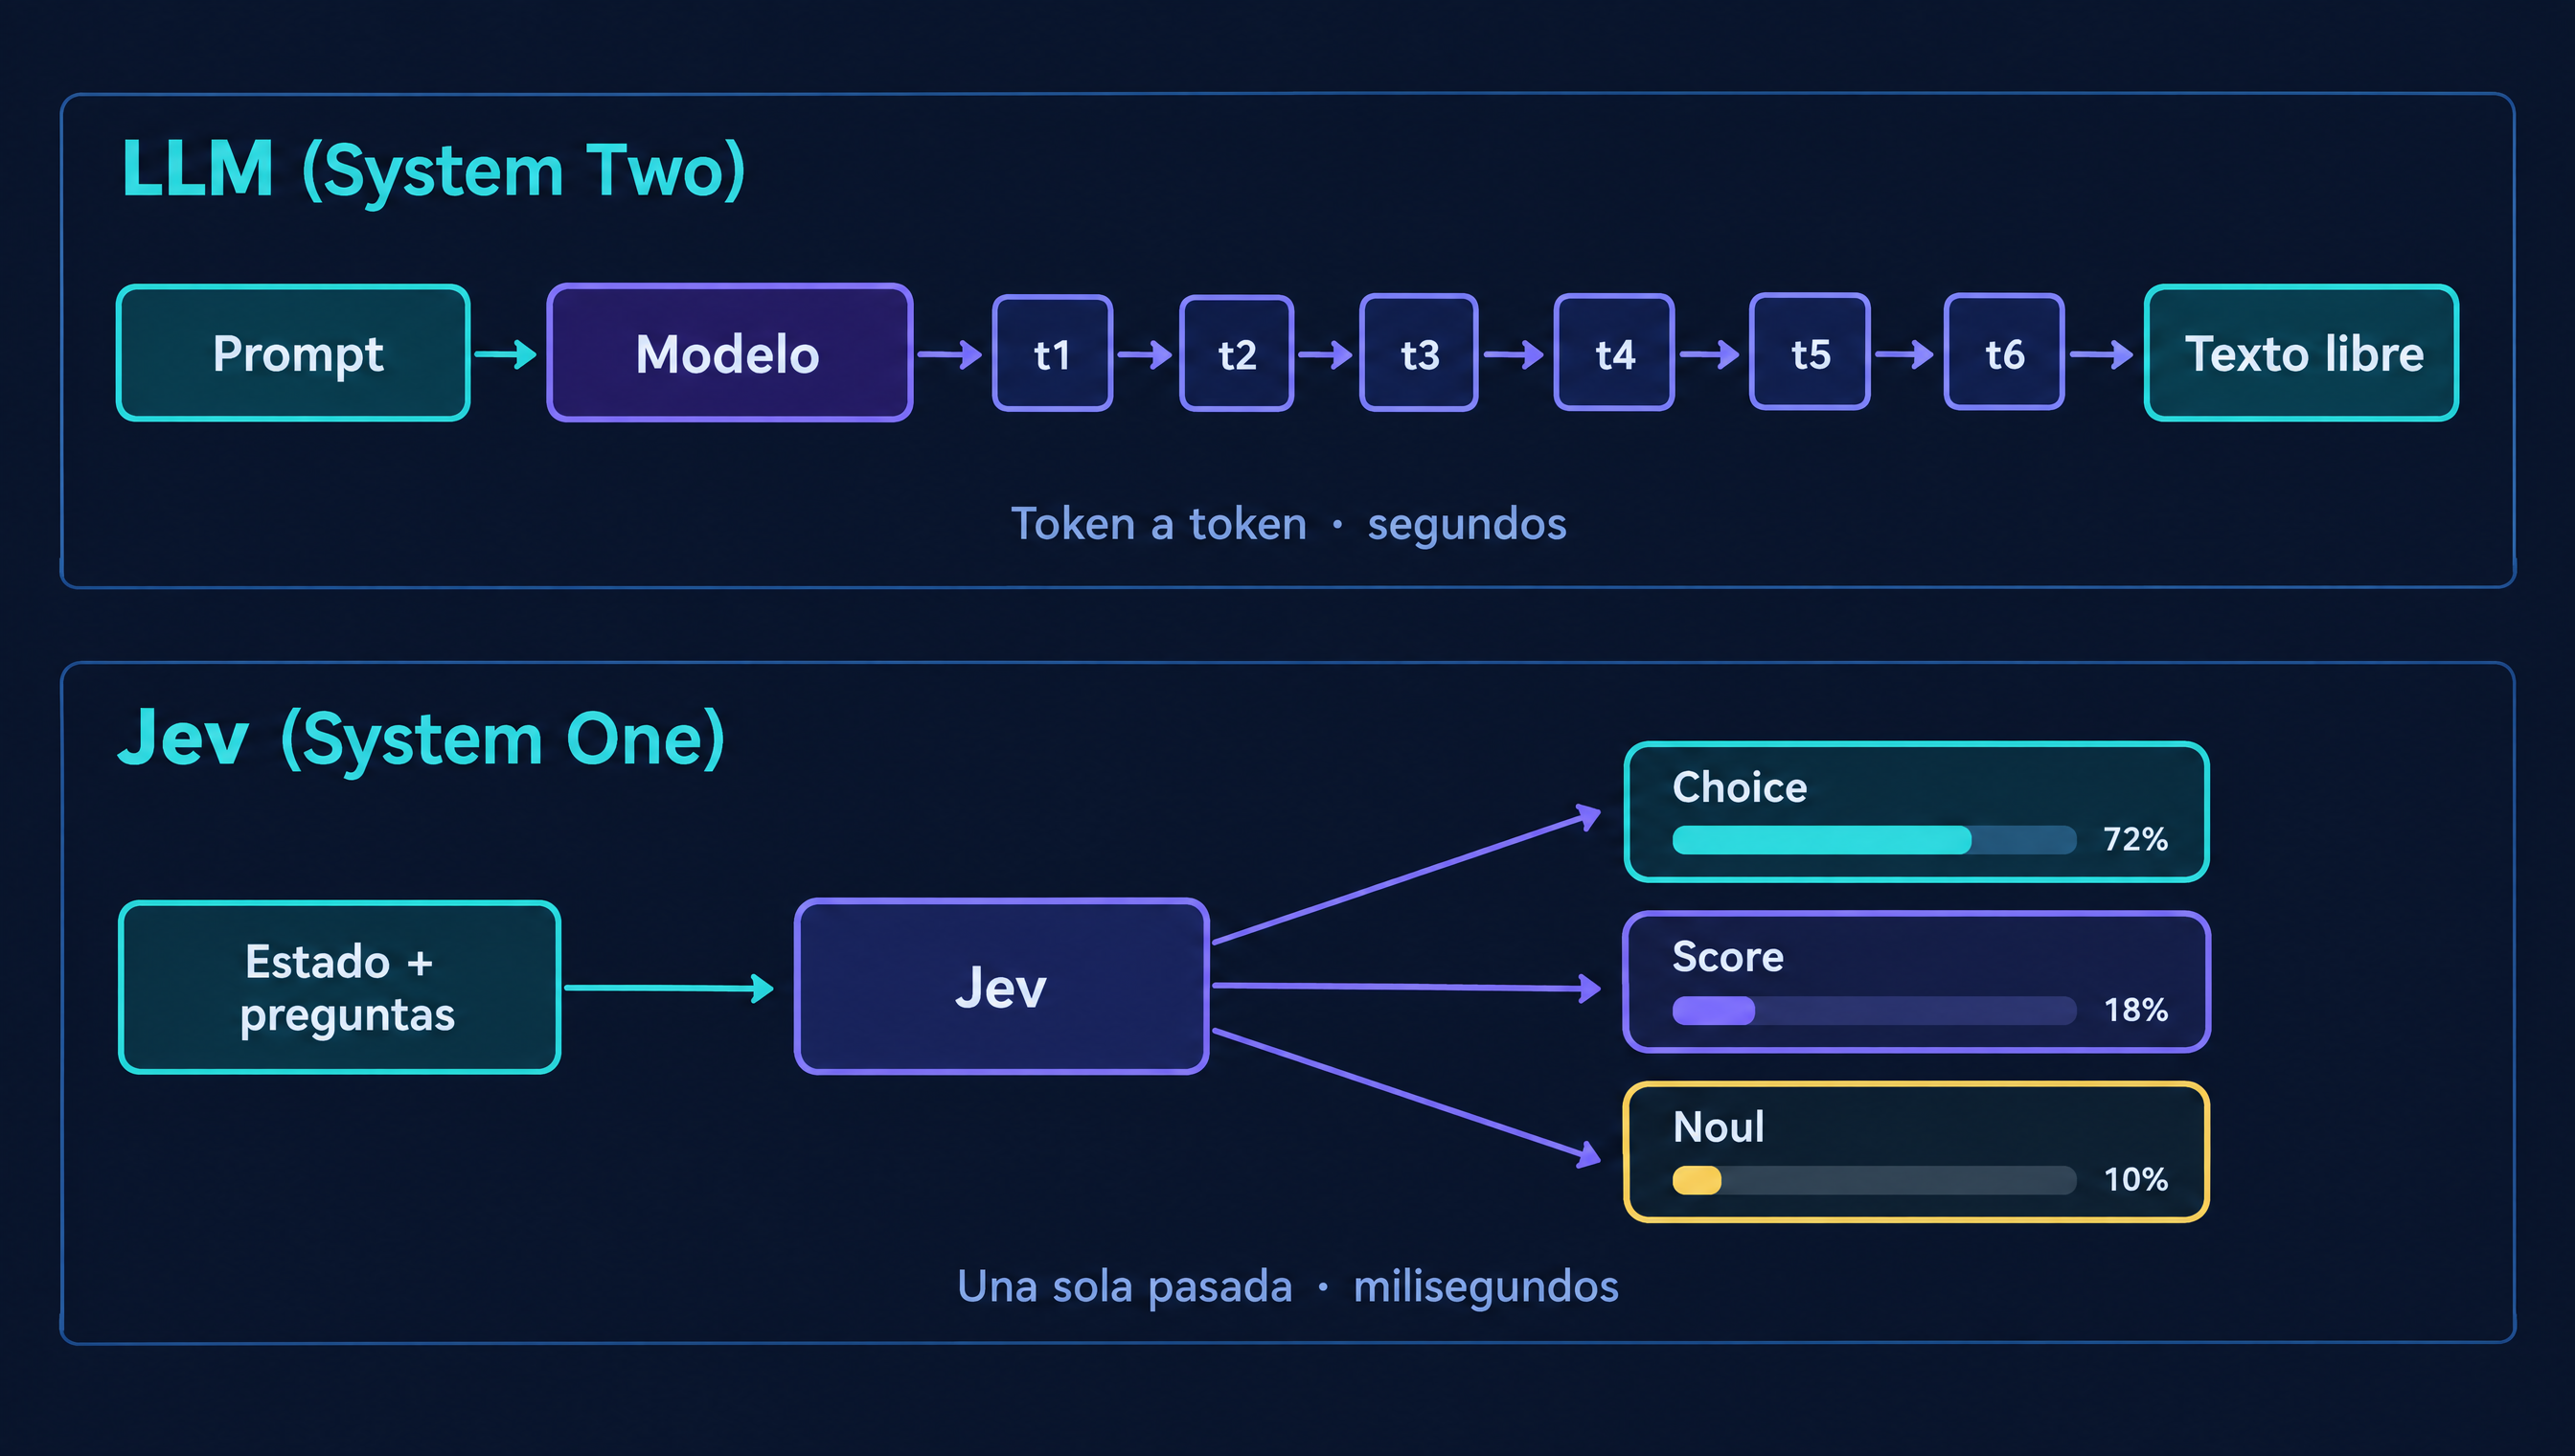
Las consecuencias prácticas son tres:
- Latencia: TypeSafe reporta respuestas de extremo a extremo de 70 a 500 ms, frente a los segundos (o minutos, con razonamiento) de un modelo frontera. Añadir preguntas a la misma petición apenas cambia el tiempo.
- Coste: 0,042 dólares por millón de tokens de entrada y salida gratuita, porque no hay salida generada. La empresa calcula que un bot que toma diez decisiones por segundo cuesta unos 7 dólares por hora.
- Forma garantizada: nunca recibirás un JSON roto ni una categoría inventada. Eso no significa que la respuesta sea correcta; volveremos sobre esto, porque es la distinción más importante del artículo.
El entrenamiento también cambia. Los LLM se ajustan con RLHF (preferencias humanas) o RLVR (recompensas verificables). TypeSafe presenta un tercer método, RLCD (Reinforcement Learning for Calibrated Decisions), que optimiza la calibración: si Jev dice 0,8, debería acertar aproximadamente el 80 % de las veces. Esa es la promesa central, más que la velocidad: una probabilidad en la que puedas basar un if.
Choice, Score y Noul: las tres primitivas de Jev
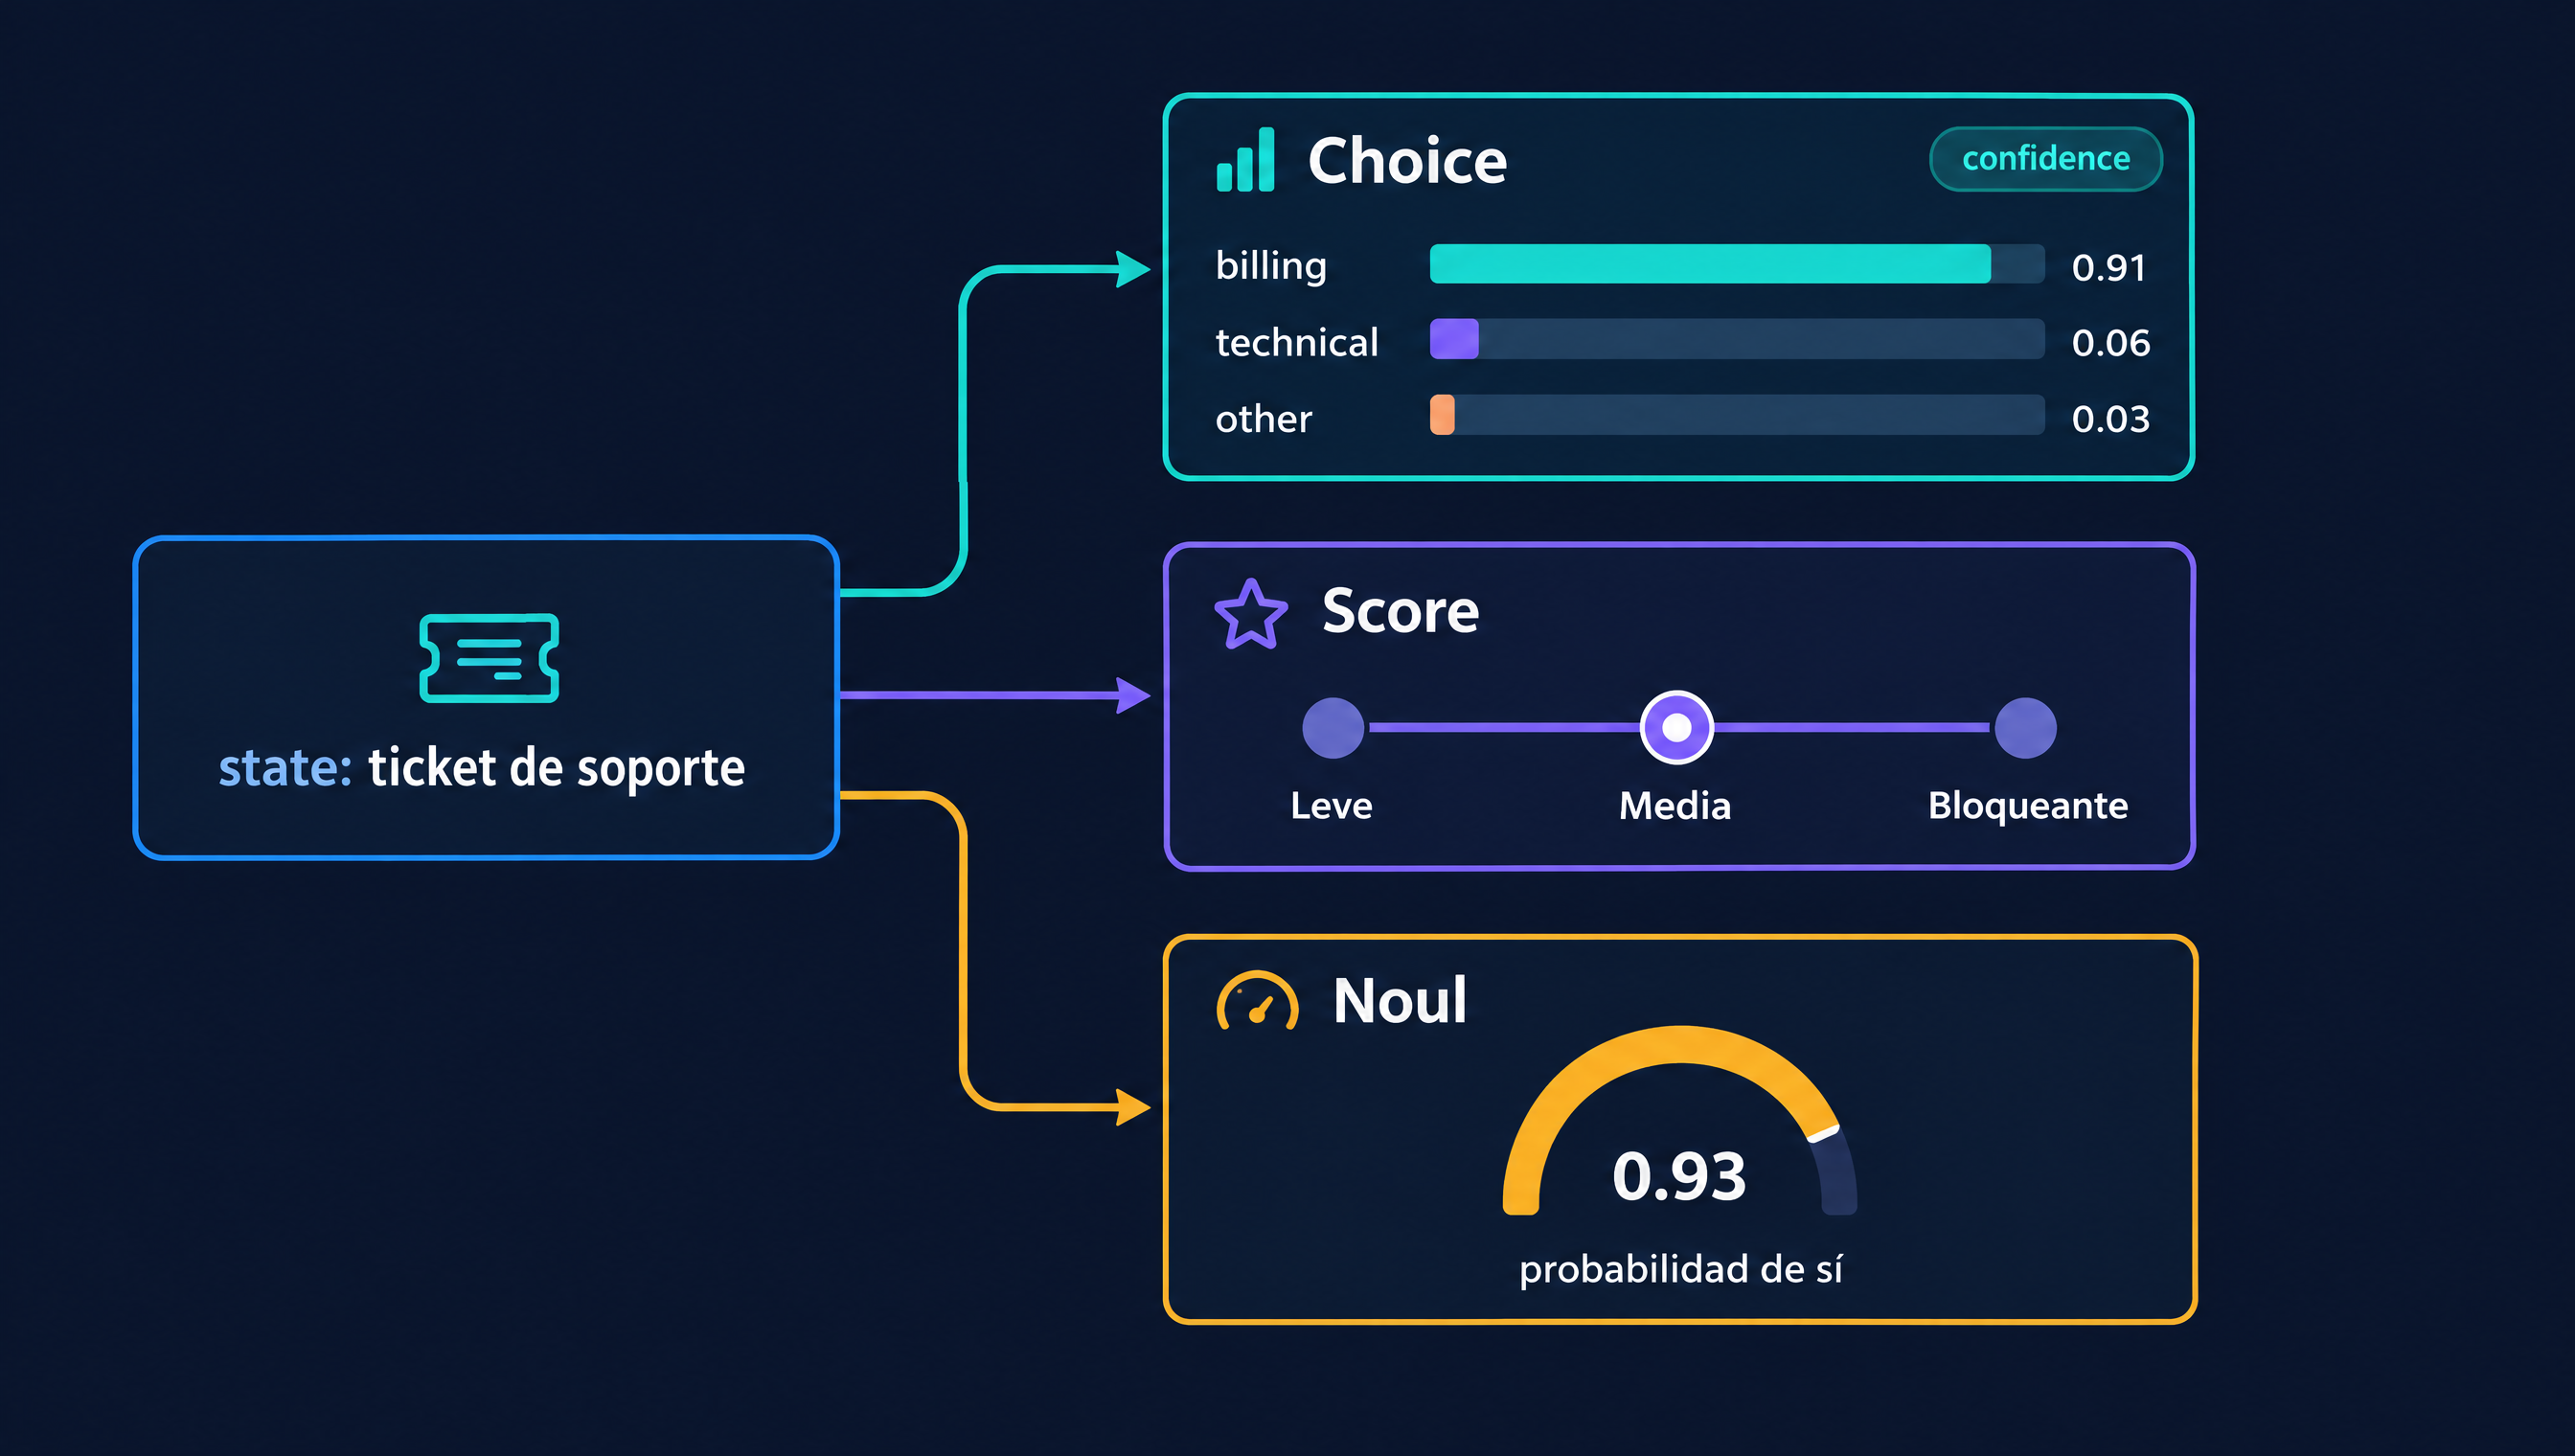
Toda petición a Jev tiene la misma forma: un state (el contexto, texto o un objeto) y un mapa de questions. Cada pregunta es de uno de estos tipos:
- Choice: elige una opción entre un conjunto definido (hasta 255 opciones). Devuelve la opción elegida, la probabilidad de cada una y un valor de
confidence. - Score: valora el estado contra una escala de niveles ordenados que tú describes ("cosmético", "degradado con workaround", "bloqueante"). Devuelve la media ponderada de los niveles, las probabilidades de cada uno y la confianza.
- Noul: una pregunta de sí/no que devuelve la probabilidad de "sí", entre 0 y 1. En Vercel AI SDK se llama
boolean.
Así se ve una petición HTTP mínima contra la API:
curl -s https://api.typesafe.ai/v1/systemone \
  -H "Authorization: Bearer $TYPESAFE_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "jev-latest",
    "state": "Me cobraron dos veces la suscripción mensual. Quiero que me devuelvan el cargo duplicado.",
    "questions": {
      "department": {
        "type": "choice",
        "instructions": "¿Qué equipo debe atender este mensaje?",
        "criteria": {
          "billing": "Cobros, facturas, reembolsos",
          "technical": "Errores o fallos del producto",
          "other": null
        }
      },
      "refund_requested": {
        "type": "noul",
        "instructions": "¿El cliente pide explícitamente que le devuelvan dinero?"
      }
    }
  }'
Y la respuesta, simplificada:
{
  "model": "jev-1.13.0",
  "answers": {
    "department": {
      "type": "choice",
      "choice": "billing",
      "probabilities": { "billing": 0.97, "technical": 0.02, "other": 0.01 },
      "confidence": 0.95
    },
    "refund_requested": { "type": "noul", "noul": 0.99 }
  },
  "usage": { "input_tokens": 142, "output_tokens": 0 }
}
Fíjate en tres detalles. El campo model devuelve la versión concreta que respondió (jev-1.13.0), aunque pidieras el alias jev-latest. Los identificadores de pregunta (department, refund_requested) son solo para tu código: el modelo no los ve, así que toda la condición debe estar en instructions. Y la opción other con valor null es una "salida de emergencia" recomendada para que Jev no fuerce una categoría cuando ninguna encaja.
Precio, límites y dónde está disponible Jev
Estos son los datos públicos a principios de noviembre de 2026 para Jev 1.13.0:
| Concepto | Valor |
|---|---|
| Entrada | 0,042 USD por millón de tokens |
| Salida | Gratis (no genera texto) |
| Contexto | 64k tokens por petición; estado + pregunta más larga ≤ 32k |
| Opciones por Choice | Hasta 255 |
| Latencia típica | 70–500 ms |
| Límites de uso | 100.000 tokens/s y 80 peticiones/s (ajustables; HTTP 429 al superarlos) |
| Endpoint | POST https://api.typesafe.ai/v1/systemone |
| Acceso | Lista de espera eliminada el 27 de septiembre; clave en la consola de TypeSafe |
Además de los SDK oficiales para Python (typesafe-sdk) y JavaScript (@typesafe-ai/sdk), Jev aparece como proveedor en el Vercel AI SDK (@ai-sdk/typesafe-ai, API experimental), en el AI Gateway de Vercel, en Cloudflare Workers AI y en Pydantic AI. No hay SDK oficial para Java, pero como verás más abajo no hace falta: es una API REST sencilla.
Sobre los datos de rendimiento conviene ser prudente. TypeSafe afirma ser entre 20 y 200 veces más rápido y entre 40 y 400 veces más barato que los LLM en tareas de decisión. En sus propias evaluaciones, recogidas por DevelopersDigest, Jev logra un 76 % de acierto en su mejor flujo frente a cifras cercanas al 78–79 % de los modelos frontera de OpenAI y Anthropic, pero con un coste por llamada miles de veces menor y 0,4 segundos de latencia frente a decenas. Esos flujos los diseñó TypeSafe y las respuestas de referencia se construyeron con GPT-6 Astra y Fable 5.1, como la propia empresa reconoce. Es decir: Jev no pretende ser más listo, sino casi igual de bueno a una fracción del coste en un tipo concreto de tarea.
Las críticas: ¿Jev de verdad "no puede alucinar"?
El anuncio de TypeSafe afirma que Jev "no puede alucinar" y que los errores de tipo son "matemáticamente imposibles". La segunda frase es cierta por diseño; la primera depende de qué llames alucinar. Jev nunca devolverá una opción que no existe, pero sí puede elegir con seguridad la opción equivocada. Restringir el formato de una decisión no restringe su corrección ni sus consecuencias.
Las críticas más relevantes de estas semanas:
- Robustez ante ataques. El 15 de octubre, la firma de seguridad HiddenLayer publicó pruebas en las que Jev resultaba vulnerable de serie a TokenBreak (insertar caracteres delante de palabras clave para engañar a clasificadores), una técnica que los LLM grandes suelen resistir. En un checkout simulado, un anuncio controlado por el atacante consiguió que un agente de navegador hiciera clic fuera de la compra del usuario. Analistas de IDC y Gartner consideraron sólida la metodología, aunque recordaron que el modelo es nuevo y que un proveedor de seguridad que concluye "esto es inseguro" tiene cierto interés comercial.
- Inyección en el estado. Forbes Argentina recogió una prueba de VentureBeat en la que añadir un mensaje falso de "autorización" al estado bajó la probabilidad de bloquear un comando destructivo de 0,76 a 0,48. Si usas Jev como guardrail, el estado es una superficie de ataque.
- "Es solo un clasificador bien empaquetado". Es la objeción más repetida en X y Hacker News. La respuesta de TypeSafe es la calibración: un clasificador tradicional necesita datos etiquetados y reentrenamiento por cada tarea; Jev se adapta con instrucciones y criterios en la propia petición, y no admite fine-tuning (todos los clientes usan los mismos pesos).
- Fallos documentados. La propia TypeSafe publica nueve modos de fallo de Jev 1.13: lectura demasiado literal de instrucciones, conteo y aritmética poco fiables, comparación de fechas, pérdida de precisión con estados grandes e irrelevantes (context rot), susceptibilidad a contenido adversario, instrucciones contradictorias, sesgo hacia la primera opción de un Choice y, obviamente, ninguna generación de texto.
Un apunte para no propagar ruido: a finales de octubre circuló la noticia de una supuesta filtración que habría expuesto todas las salidas de los clientes de Jev. El medio que la amplificó, AIToolsRecap, se retractó el 31 de octubre tras no poder confirmarla, y TypeSafe negó que hubiera incidente. A día de hoy no hay evidencia independiente de esa filtración.
Cómo integrar Jev en Spring Boot con RestClient
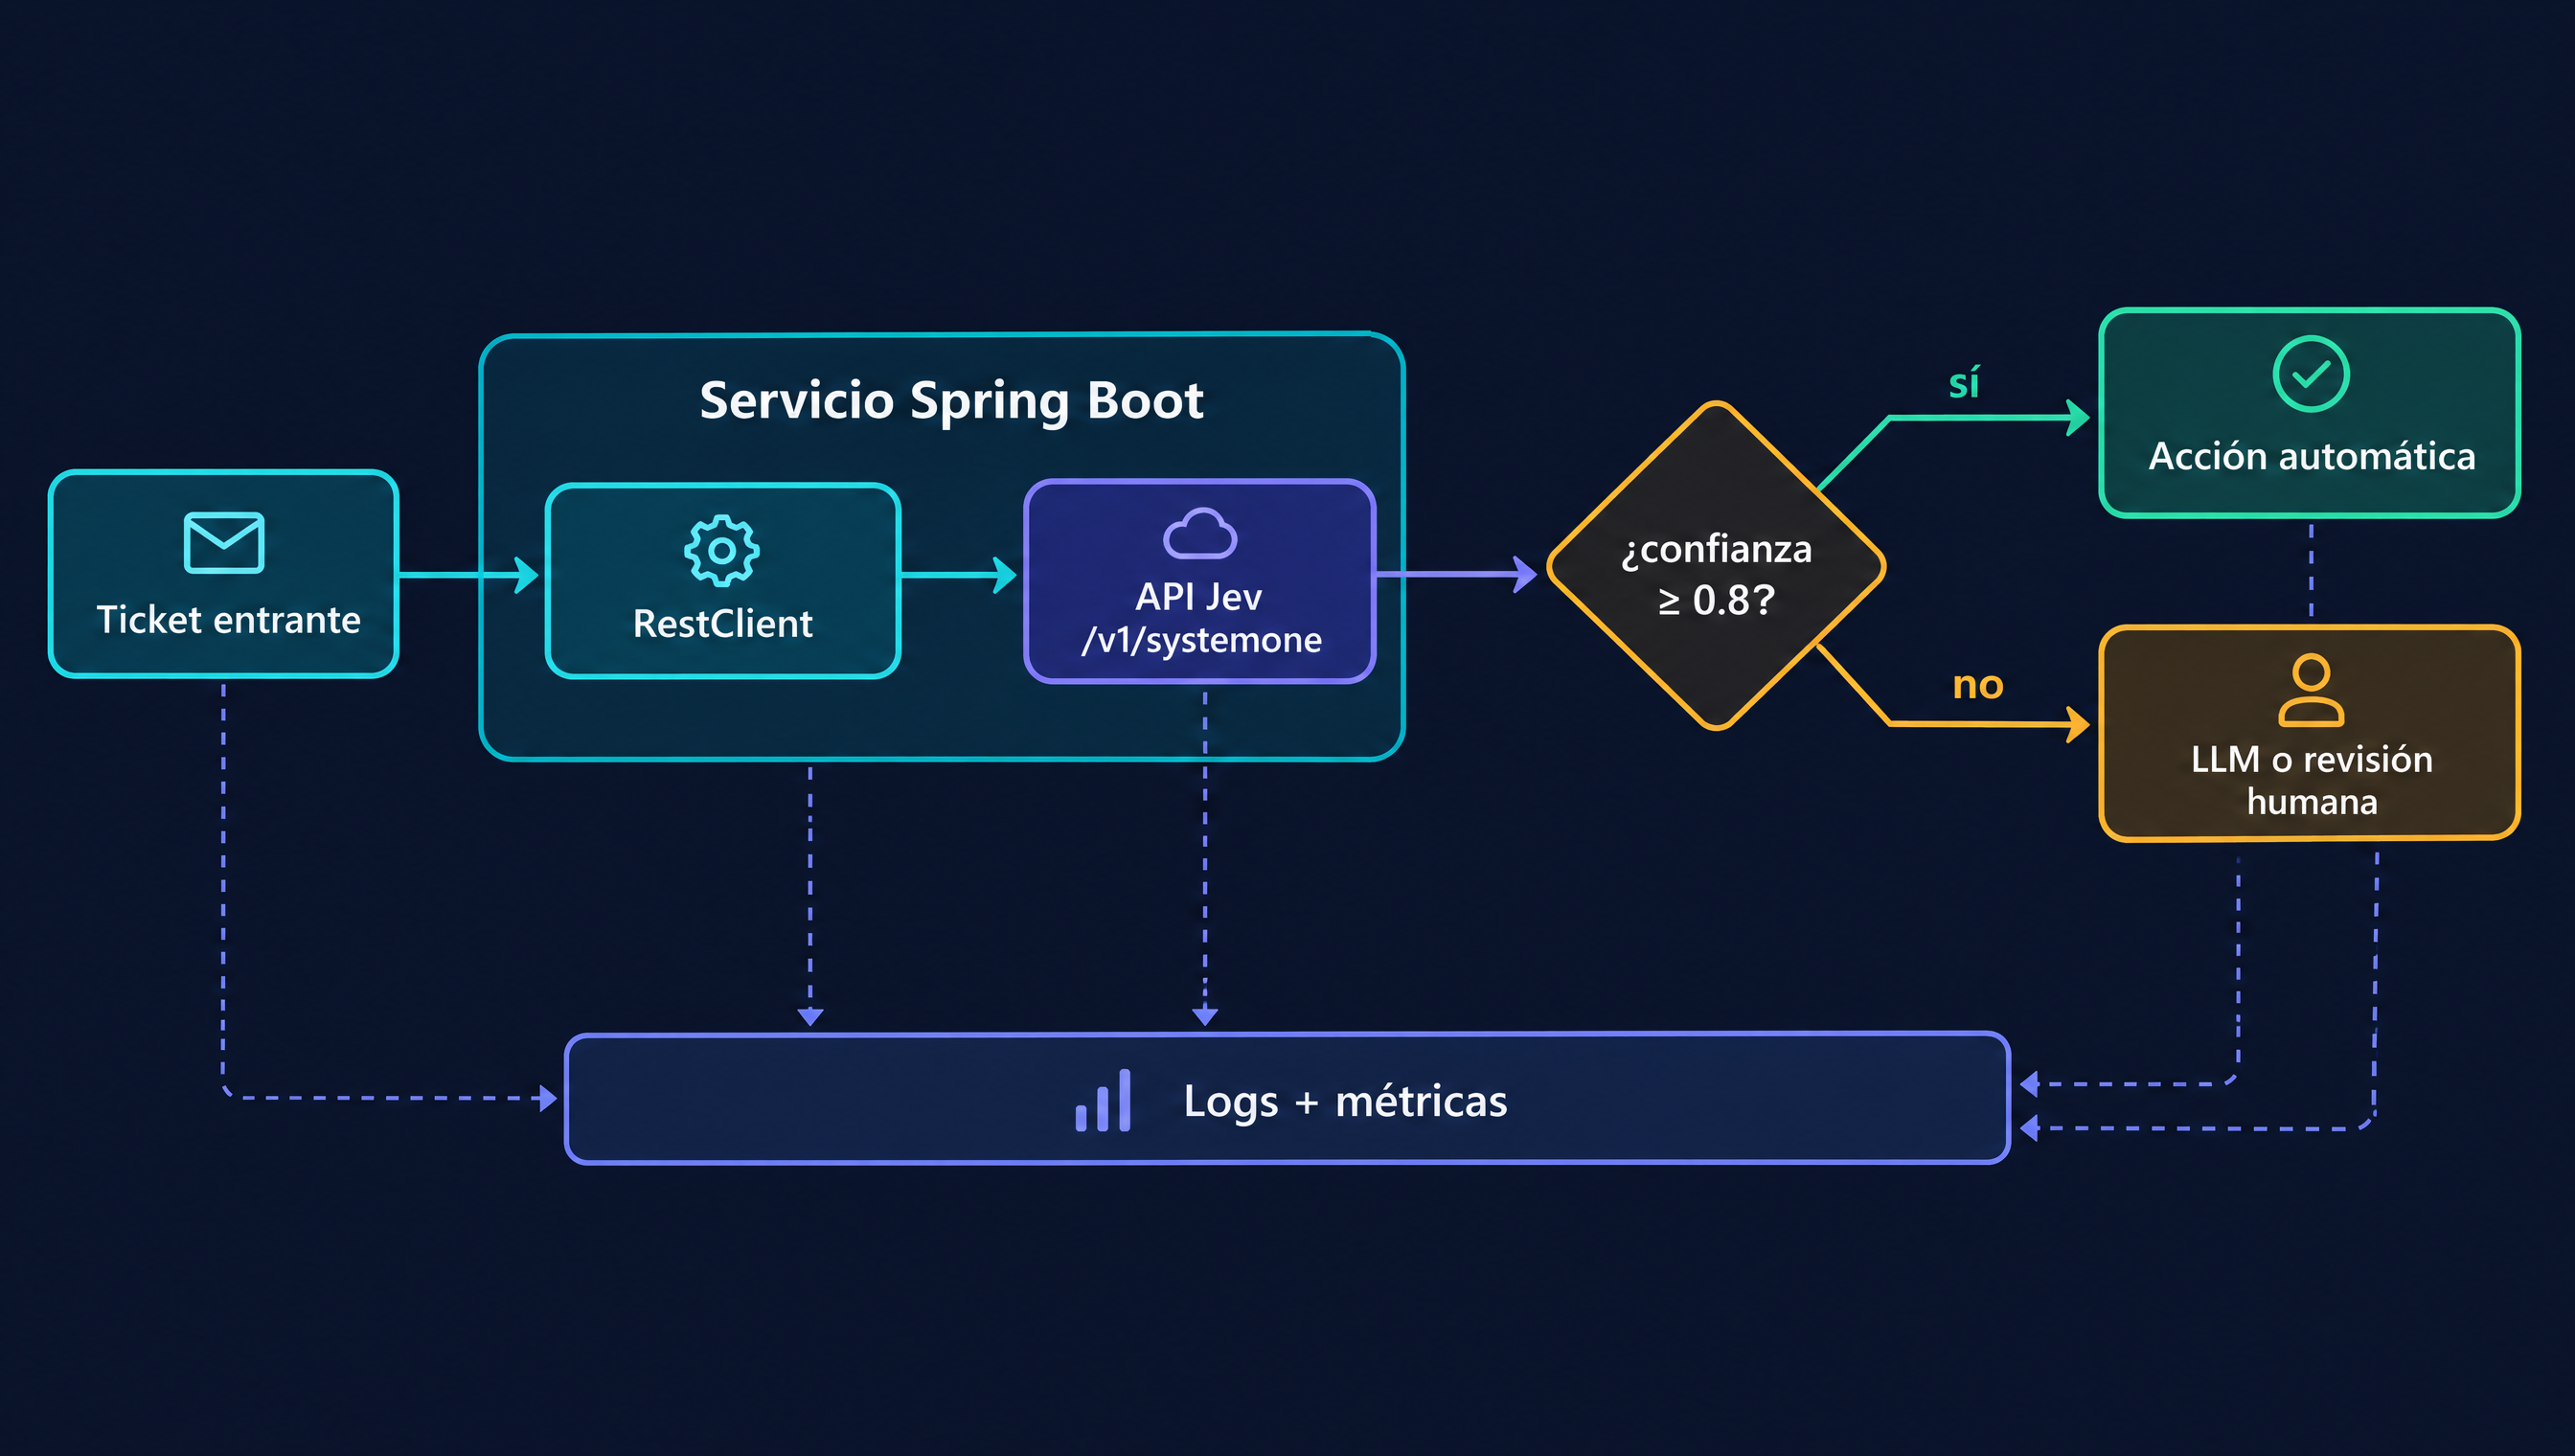
Ninguno de los artículos en español que encontré sobre Jev incluye código, y ninguno en inglés lo hace en Java. Vamos a construir un clasificador de tickets en Spring Boot que llama a Jev, actúa solo cuando la confianza supera un umbral y, si no, deriva el caso a un LLM o a revisión humana. Es el patrón que recomienda la propia TypeSafe y el que hace que Jev tenga sentido en producción.
Primero, la configuración. La clave nunca va en el código ni en el navegador (el SDK oficial de JavaScript bloquea su uso en cliente por defecto):
# application.yml
typesafe:
  base-url: https://api.typesafe.ai
  api-key: ${TYPESAFE_API_KEY}
  # Fija la versión en producción: los umbrales se calibran contra un modelo concreto
  model: jev-1.13.0
  auto-threshold: 0.80
Un RestClient dedicado, con timeouts agresivos: si Jev tarda más de un segundo, algo va mal y preferimos el fallback. Si quieres repasar las opciones de clientes HTTP en Spring, lo detallé en la guía de clientes REST en Spring: RestClient, WebClient y OpenFeign.
@Configuration
@EnableConfigurationProperties(TypeSafeProperties.class)
class JevClientConfig {

    @Bean
    RestClient jevRestClient(TypeSafeProperties props) {
        var factory = new SimpleClientHttpRequestFactory();
        factory.setConnectTimeout(Duration.ofMillis(500));
        factory.setReadTimeout(Duration.ofSeconds(1)); // Jev responde en 70–500 ms

        return RestClient.builder()
                .baseUrl(props.baseUrl())
                .requestFactory(factory)
                .defaultHeader(HttpHeaders.AUTHORIZATION, "Bearer " + props.apiKey())
                .build();
    }
}

@ConfigurationProperties(prefix = "typesafe")
record TypeSafeProperties(String baseUrl, String apiKey, String model, double autoThreshold) {}
Ahora el contrato. Modelamos la petición con records y leemos la respuesta como JsonNode, porque cada tipo de pregunta trae campos distintos (choice, score, noul):
// Petición: state + mapa de preguntas. Los IDs de pregunta son solo para nuestro código.
record JevRequest(String model, String state, Map<String, Question> questions) {}

@JsonInclude(JsonInclude.Include.NON_NULL)
record Question(String type, String instructions, Object criteria) {

    static Question choice(String instructions, Map<String, String> options) {
        return new Question("choice", instructions, options);
    }

    static Question score(String instructions, List<String> levels) {
        return new Question("score", instructions, levels);
    }

    static Question noul(String instructions) {
        return new Question("noul", instructions, null);
    }
}

// Resultado de dominio: lo que nuestro servicio necesita, no el JSON crudo.
record TicketTriage(String department, double departmentConfidence,
                    double severity, double refundProbability, String modelVersion) {}
El servicio hace una sola llamada con todas las preguntas (el estado se factura una vez) y traduce la respuesta a nuestro dominio:
@Service
class JevTriageService {

    private static final Logger log = LoggerFactory.getLogger(JevTriageService.class);

    private final RestClient jev;
    private final TypeSafeProperties props;

    JevTriageService(RestClient jevRestClient, TypeSafeProperties props) {
        this.jev = jevRestClient;
        this.props = props;
    }

    TicketTriage triage(String ticketText) {
        // Mapa ordenado: Jev 1.13 tiene sesgo hacia la primera opción,
        // así que evitamos poner siempre primero la categoría "más probable".
        var departments = new LinkedHashMap<String, String>();
        departments.put("technical", "Errores, caídas o comportamiento inesperado del producto");
        departments.put("billing", "Cobros, facturas, reembolsos o cambios de plan");
        departments.put("account", "Acceso, contraseñas, datos de la cuenta");
        departments.put("other", null); // salida de emergencia

        var request = new JevRequest(props.model(), ticketText, Map.of(
                "department", Question.choice(
                        "¿Qué equipo debe atender este ticket?", departments),
                "severity", Question.score(
                        "¿Qué tan grave es el problema descrito en el ticket?", List.of(
                                "Cosmético: no impide usar el producto",
                                "Degradado: hay una alternativa para seguir trabajando",
                                "Bloqueante: el cliente no puede trabajar y no hay alternativa")),
                "refund_requested", Question.noul(
                        "¿El cliente pide explícitamente que le devuelvan dinero?")));

        JsonNode body = jev.post()
                .uri("/v1/systemone")
                .contentType(MediaType.APPLICATION_JSON)
                .body(request)
                .retrieve()
                .body(JsonNode.class);

        JsonNode answers = body.path("answers");
        var triage = new TicketTriage(
                answers.path("department").path("choice").asText("other"),
                answers.path("department").path("confidence").asDouble(0),
                answers.path("severity").path("score").asDouble(0),
                answers.path("refund_requested").path("noul").asDouble(0),
                body.path("model").asText());

        // Registra siempre la versión que respondió: si cambia, hay que recalibrar umbrales.
        log.info("Jev triage model={} dept={} conf={} severity={} refund={}",
                triage.modelVersion(), triage.department(), triage.departmentConfidence(),
                triage.severity(), triage.refundProbability());
        return triage;
    }
}
Por último, la pieza que convierte una probabilidad en una decisión de negocio. Si la confianza es alta, enrutamos automáticamente; si no, el caso va a un LLM (por ejemplo con Spring AI) o a una persona. Y si Jev no responde, un circuit breaker evita que la caída de un proveedor externo tumbe el flujo, como expliqué en la guía de Circuit Breaker con Resilience4j:
@Service
class TicketRouter {

    private final JevTriageService jev;
    private final LlmTriageService llmFallback; // tu integración con un LLM generativo
    private final HumanReviewQueue humanReview;
    private final double threshold;

    TicketRouter(JevTriageService jev, LlmTriageService llmFallback,
                 HumanReviewQueue humanReview, TypeSafeProperties props) {
        this.jev = jev;
        this.llmFallback = llmFallback;
        this.humanReview = humanReview;
        this.threshold = props.autoThreshold();
    }

    @CircuitBreaker(name = "jev", fallbackMethod = "routeWithLlm")
    RoutingDecision route(Ticket ticket) {
        TicketTriage t = jev.triage(ticket.text());

        if ("other".equals(t.department()) || t.departmentConfidence() < threshold) {
            // Jev duda: no actuamos a ciegas, escalamos a un modelo más caro.
            return routeWithLlm(ticket, null);
        }
        if (t.refundProbability() > 0.9 && t.severity() >= 1.5) {
            // Acción con impacto económico: exigimos revisión humana aunque Jev esté seguro.
            return humanReview.enqueue(ticket, t);
        }
        return RoutingDecision.auto(t.department(), t.severity());
    }

    RoutingDecision routeWithLlm(Ticket ticket, Throwable cause) {
        return llmFallback.triage(ticket);
    }
}
Tres decisiones de diseño merecen comentario. Primero, el umbral no es universal: 0,8 es un punto de partida; lo correcto es medir con un conjunto de tickets etiquetados qué porcentaje de aciertos tienes por encima de cada valor y ajustarlo. Segundo, las acciones con riesgo económico o de seguridad exigen una confianza mayor o una persona, independientemente de lo que diga el modelo. Tercero, fija la versión (jev-1.13.0) en lugar de jev-latest: si TypeSafe publica un modelo nuevo, tus umbrales calibrados dejan de ser válidos.
¿Cuándo usar Jev y cuándo no?
Jev encaja bien cuando la tarea es una decisión cerrada que hoy resuelves con un LLM y un switch sobre su respuesta:
- Enrutamiento y triaje: tickets de soporte, correos entrantes, alertas de seguridad, facturas.
- Puntuación masiva: lead scoring, priorización de incidencias, re-ranking de resultados de búsqueda (TypeSafe reporta que añadir un paso de Jev sobre una búsqueda por palabras clave más que triplicó la precisión top-1 en consultas legales).
- Map-reduce sobre grandes volúmenes: evaluar millones de registros con varias preguntas por registro, donde el coste por token de un LLM lo haría inviable.
- Supervisión de agentes: decidir si una acción propuesta por un agente necesita confirmación, si un resultado es válido antes de seguir o cuándo escalar a un modelo mayor. Browserbase lo integró en Stagehand para elegir el elemento sobre el que actuar y bajó la latencia mediana de
actde 1,97 s a 0,46 s. - Tiempo real: decisiones a 10 por segundo, como su demo jugando a Doom a partir del estado del juego en texto.
Y no encaja cuando:
- Necesitas generar texto, código o explicaciones. Jev no puede; combínalo con un LLM.
- La decisión depende de aritmética, conteos o fechas. Calcúlalos en código y pásale el resultado.
- Es una decisión de alto impacto sin red de seguridad: dar acceso, mover dinero, borrar datos. Ahí Jev puede ser un filtro previo, nunca el único control.
- Tus datos de entrada contienen contenido no confiable (páginas web, correos de terceros) y no tienes defensas adicionales contra inyección.
- Necesitas fine-tuning con tus datos o zero data retention sin contrato enterprise.
Buenas prácticas para trabajar con Jev
Combinando la documentación de TypeSafe, la guía de Flavio Copes y las pruebas de HiddenLayer, estas son las reglas que aplicaría en un proyecto real:
- Una pregunta, un juicio. Si escribes "¿es urgente y de facturación?", divídelo en dos preguntas.
- Criterios concretos, no grados. "Bloqueante: el cliente no puede trabajar y no hay alternativa" funciona mejor que "muy grave".
- Incluye siempre
otheren los Choice para que el modelo tenga una salida honesta. - Agrupa preguntas en una sola llamada: el estado se paga una vez y la latencia apenas crece.
- Filtra el estado antes de enviarlo. Mandar todo el historial degrada la precisión (context rot) y amplía la superficie de ataque.
- Decide con
confidence, no con la etiqueta: umbrales por tipo de acción y derivación a humano o LLM por debajo. - Fija la versión del modelo y regístrala en cada log, como harías con la versión de un esquema o de una API externa. Si quieres que esos logs sirvan de algo, conéctalos a tu stack de trazas como en la guía de OpenTelemetry con Spring Boot.
- Haz red teaming en tu propio flujo: prueba variaciones adversarias del texto de entrada (TokenBreak, autorizaciones falsas) antes de confiar en Jev como guardrail.
Preguntas frecuentes
¿Qué es Jev en inteligencia artificial?
Jev es un modelo de TypeSafe AI que no genera texto: recibe un contexto y preguntas cerradas y devuelve decisiones tipadas (una opción, una puntuación o una probabilidad de sí/no) con su confianza. Está pensado para clasificar, enrutar y puntuar dentro del software, no para conversar.
¿Quién creó Jev?
Lo creó TypeSafe AI, una startup fundada por Diogo Almeida, exinvestigador de OpenAI que trabajó en las técnicas de RLHF detrás de ChatGPT. La empresa presentó Jev el 15 de septiembre de 2026 y en octubre levantó 870 millones de dólares con una valoración de 7.500 millones.
¿Cuánto cuesta usar Jev?
Jev 1.13.0 cuesta 0,042 dólares por millón de tokens de entrada, y los tokens de salida son gratuitos porque no genera texto. La propia TypeSafe advierte de que el precio podría estar subsidiado y que su sostenibilidad a largo plazo no está demostrada.
¿Jev reemplaza a ChatGPT o a Claude?
No. Jev no puede escribir respuestas, resumir ni generar código. Su papel es sustituir al LLM solo en las decisiones cerradas de un flujo, que es donde un modelo generativo resulta caro y lento. Lo habitual es combinarlo con un LLM para el resto del trabajo.
¿Es cierto que Jev no alucina?
Jev no puede devolver una opción que no existe ni un JSON mal formado, porque su salida está restringida por diseño. Pero sí puede elegir la opción equivocada con alta confianza, y pruebas de HiddenLayer mostraron que es vulnerable a ataques como TokenBreak. Por eso conviene validar sus decisiones con umbrales y controles independientes.
¿Se puede usar Jev desde Java o Spring Boot?
Sí. No hay SDK oficial para Java, pero la API es un único endpoint REST (POST /v1/systemone) con autenticación Bearer, así que basta con RestClient de Spring y unos records para la petición. Los SDK oficiales existen para Python y JavaScript, y hay integraciones con Vercel AI SDK y Cloudflare Workers AI.
Conclusión
Jev de TypeSafe AI no es más inteligente que los modelos frontera, y no intenta serlo. Su apuesta es otra: que buena parte del valor de la IA en el software está en millones de decisiones pequeñas y repetitivas, y que para ellas un modelo generativo es caro, lento e innecesariamente impredecible. Restringir la salida a tipos cerrados y entrenar para la calibración convierte una llamada a IA en algo parecido a una función con firma conocida, y eso encaja con cómo diseñamos los sistemas backend: contratos, umbrales, fallbacks y observabilidad.
La prudencia sigue siendo obligatoria. Casi todas las cifras de rendimiento vienen de la propia TypeSafe, las primeras pruebas de seguridad muestran que un formato garantizado no es una decisión garantizada y el modelo tiene apenas siete semanas. Si lo pruebas, hazlo como cualquier dependencia externa crítica: con la versión fijada, un conjunto de evaluación propio, umbrales medidos, un circuit breaker y una persona o un LLM detrás para los casos dudosos. Si los números se sostienen fuera de los benchmarks del fabricante, el "Sistema 1" puede convertirse en una pieza estándar de la arquitectura de cualquier aplicación con IA.
Fuentes
- Introducing System One Models & Jev — TypeSafe AI
- Jev creator TypeSafe closes $870M round at $7.5B valuation — SiliconANGLE
- What is Jev? — Browserbase
- How to build typed decisions with Jev — Flavio Copes
- TypeSafe Jev Pricing, Rate Limits and Benchmarks — DevelopersDigest
- Jev Explained: The AI Model That Never Generates a Word of Text — Analytics Vidhya
- TypeSafe's Jev even more susceptible to attack than LLMs, says security vendor — CSO Online
- Uno de los creadores de ChatGPT ha creado una IA 400 veces más barata que el resto — Xataka
- Qué es Jev, la nueva IA que no chatea — Forbes Argentina
- Corrección sobre la supuesta filtración de Jev — AIToolsRecap


