
Scion de Anthropic: por qué dejó Git y cómo funciona su source control para agentes de IA
En mayo de 2026, Anthropic fusionaba unos 2.500 cambios de código al día en su monorepo. En septiembre pasaba de 30.000. El salto no lo explican más ingenieros, sino más Claude: agentes que escriben, prueban y proponen cambios sin parar. Con ese ritmo, la pieza que se rompió no fue el modelo ni la CI, sino algo que casi todo el mundo da por resuelto desde hace veinte años: Git. El 13 de octubre, la empresa publicó en su blog de ingeniería cómo lo sustituyó por Scion de Anthropic, un sistema de control de versiones propio diseñado para clientes que nunca se desconectan: los agentes.
La noticia corrió rápido con titulares del tipo "Anthropic abandona Git", y conviene matizarla. Anthropic no propone que nadie más deje Git; de hecho, dice explícitamente que Scion no es un reemplazo de uso general y que no lo va a publicar. Lo interesante es por qué un equipo de siete personas decidió reescribir el source control de una empresa en cinco meses, qué decisiones de diseño tomó y qué ideas sí son trasladables a un equipo normal que empieza a trabajar con agentes de IA. En este artículo repaso los datos que publicó Anthropic, explico cómo funciona Scion por dentro, lo comparo con Git y separo lo que es titular de lo que es lección útil.
¿Qué es Scion de Anthropic?
Scion es el sistema de control de versiones interno de Anthropic, que reemplazó a Git en su monorepo en 2026. Es centralizado: los commits, merges, rebases, el historial y el blame se resuelven en el servidor, y los clientes —sobre todo agentes y jobs de CI siempre conectados— solo descargan bajo demanda los archivos que necesitan.
Scion no llegó solo. En los mismos cinco meses, el equipo construyó también Antique, una nueva herramienta de revisión de código; un buscador de código; un sistema de permisos (IAM) para el repositorio y nuevas formas de integrar grandes volúmenes de cambios revisados. El post, firmado por Nick G. y el equipo de source control, se publicó el 13 de octubre y se actualizó el 15 para dar más crédito a los proyectos que inspiraron sus técnicas: Piper de Google y Sapling de Meta, en particular su servidor Mononoke.
La gráfica que acompaña el anuncio cuenta la transición en el día a día: los change requests de Antique aparecen a finales de mayo, superan a los pull requests a mediados de junio y casi los reemplazan por completo a mediados de julio. El pico fue el 9 de septiembre, con 30.401 merges en un solo día.
¿Por qué Anthropic dejó Git? Los números del monorepo
Git es un sistema distribuido: cada clon es un repositorio completo, con todo el historial, capaz de hacer commits, ramas y merges sin conexión. Es justo lo que lo hizo triunfar entre personas que trabajan en sus portátiles. El problema es lo que pasa cuando el repositorio es enorme y casi todos los clientes son máquinas. Los datos que dio Anthropic:
| Métrica | Valor publicado |
|---|---|
| Merges al día (mayo de 2026) | ~2.500 |
| Merges al día (septiembre de 2026) | más de 30.000 |
| Historial de la rama principal | casi 100 GB |
| Copia de trabajo comprimida | más de 25 GB |
| Checkouts diarios solo para CI | ~25 millones |
| Tráfico de Git si cada checkout se hiciera "a lo bruto" | más de 600 PB al día |
Ninguna empresa clona 600 petabytes al día, claro: antes de Scion, Anthropic aplicó todo el repertorio de trucos de Git para repositorios gigantes. Clones superficiales (shallow), sparse checkouts, promisor remotes (la base de los clones parciales), semillas del repositorio guardadas en blob storage y espejos internos; en el peor momento llegaron a operar varios cientos de mirrors de Git. Cada parche tenía su coste: las semillas se quedaban atrás respecto a la punta de main entre actualizaciones, y las operaciones que dependen del historial (blame, ancestros, bisect) se volvían cada vez más difíciles de mantener sobre clones parciales a medida que crecía el ritmo de merges.
La observación que cambió el enfoque es casi filosófica. En la práctica, Anthropic ya usaba Git como un sistema centralizado: había una única copia autoritativa y todos se sincronizaban con ella. Y prácticamente todos sus clientes eran agentes y jobs que siempre están en línea. La gran virtud de Git —trabajar offline con una copia completa— no le aportaba nada y le costaba mucho. La pregunta pasó a ser: ¿cómo sería el source control si se diseñara desde cero para agentes siempre conectados?
Para poner el crecimiento en contexto: a finales de septiembre ya conté en el cierre de septiembre en IA que Claude lideraba alrededor del 26 % de la I+D interna de Anthropic. Scion es la consecuencia operativa de ese dato: cuando los agentes producen código a esa escala, el cuello de botella se desplaza de escribir código a integrarlo.
Los seis principios de diseño de Scion
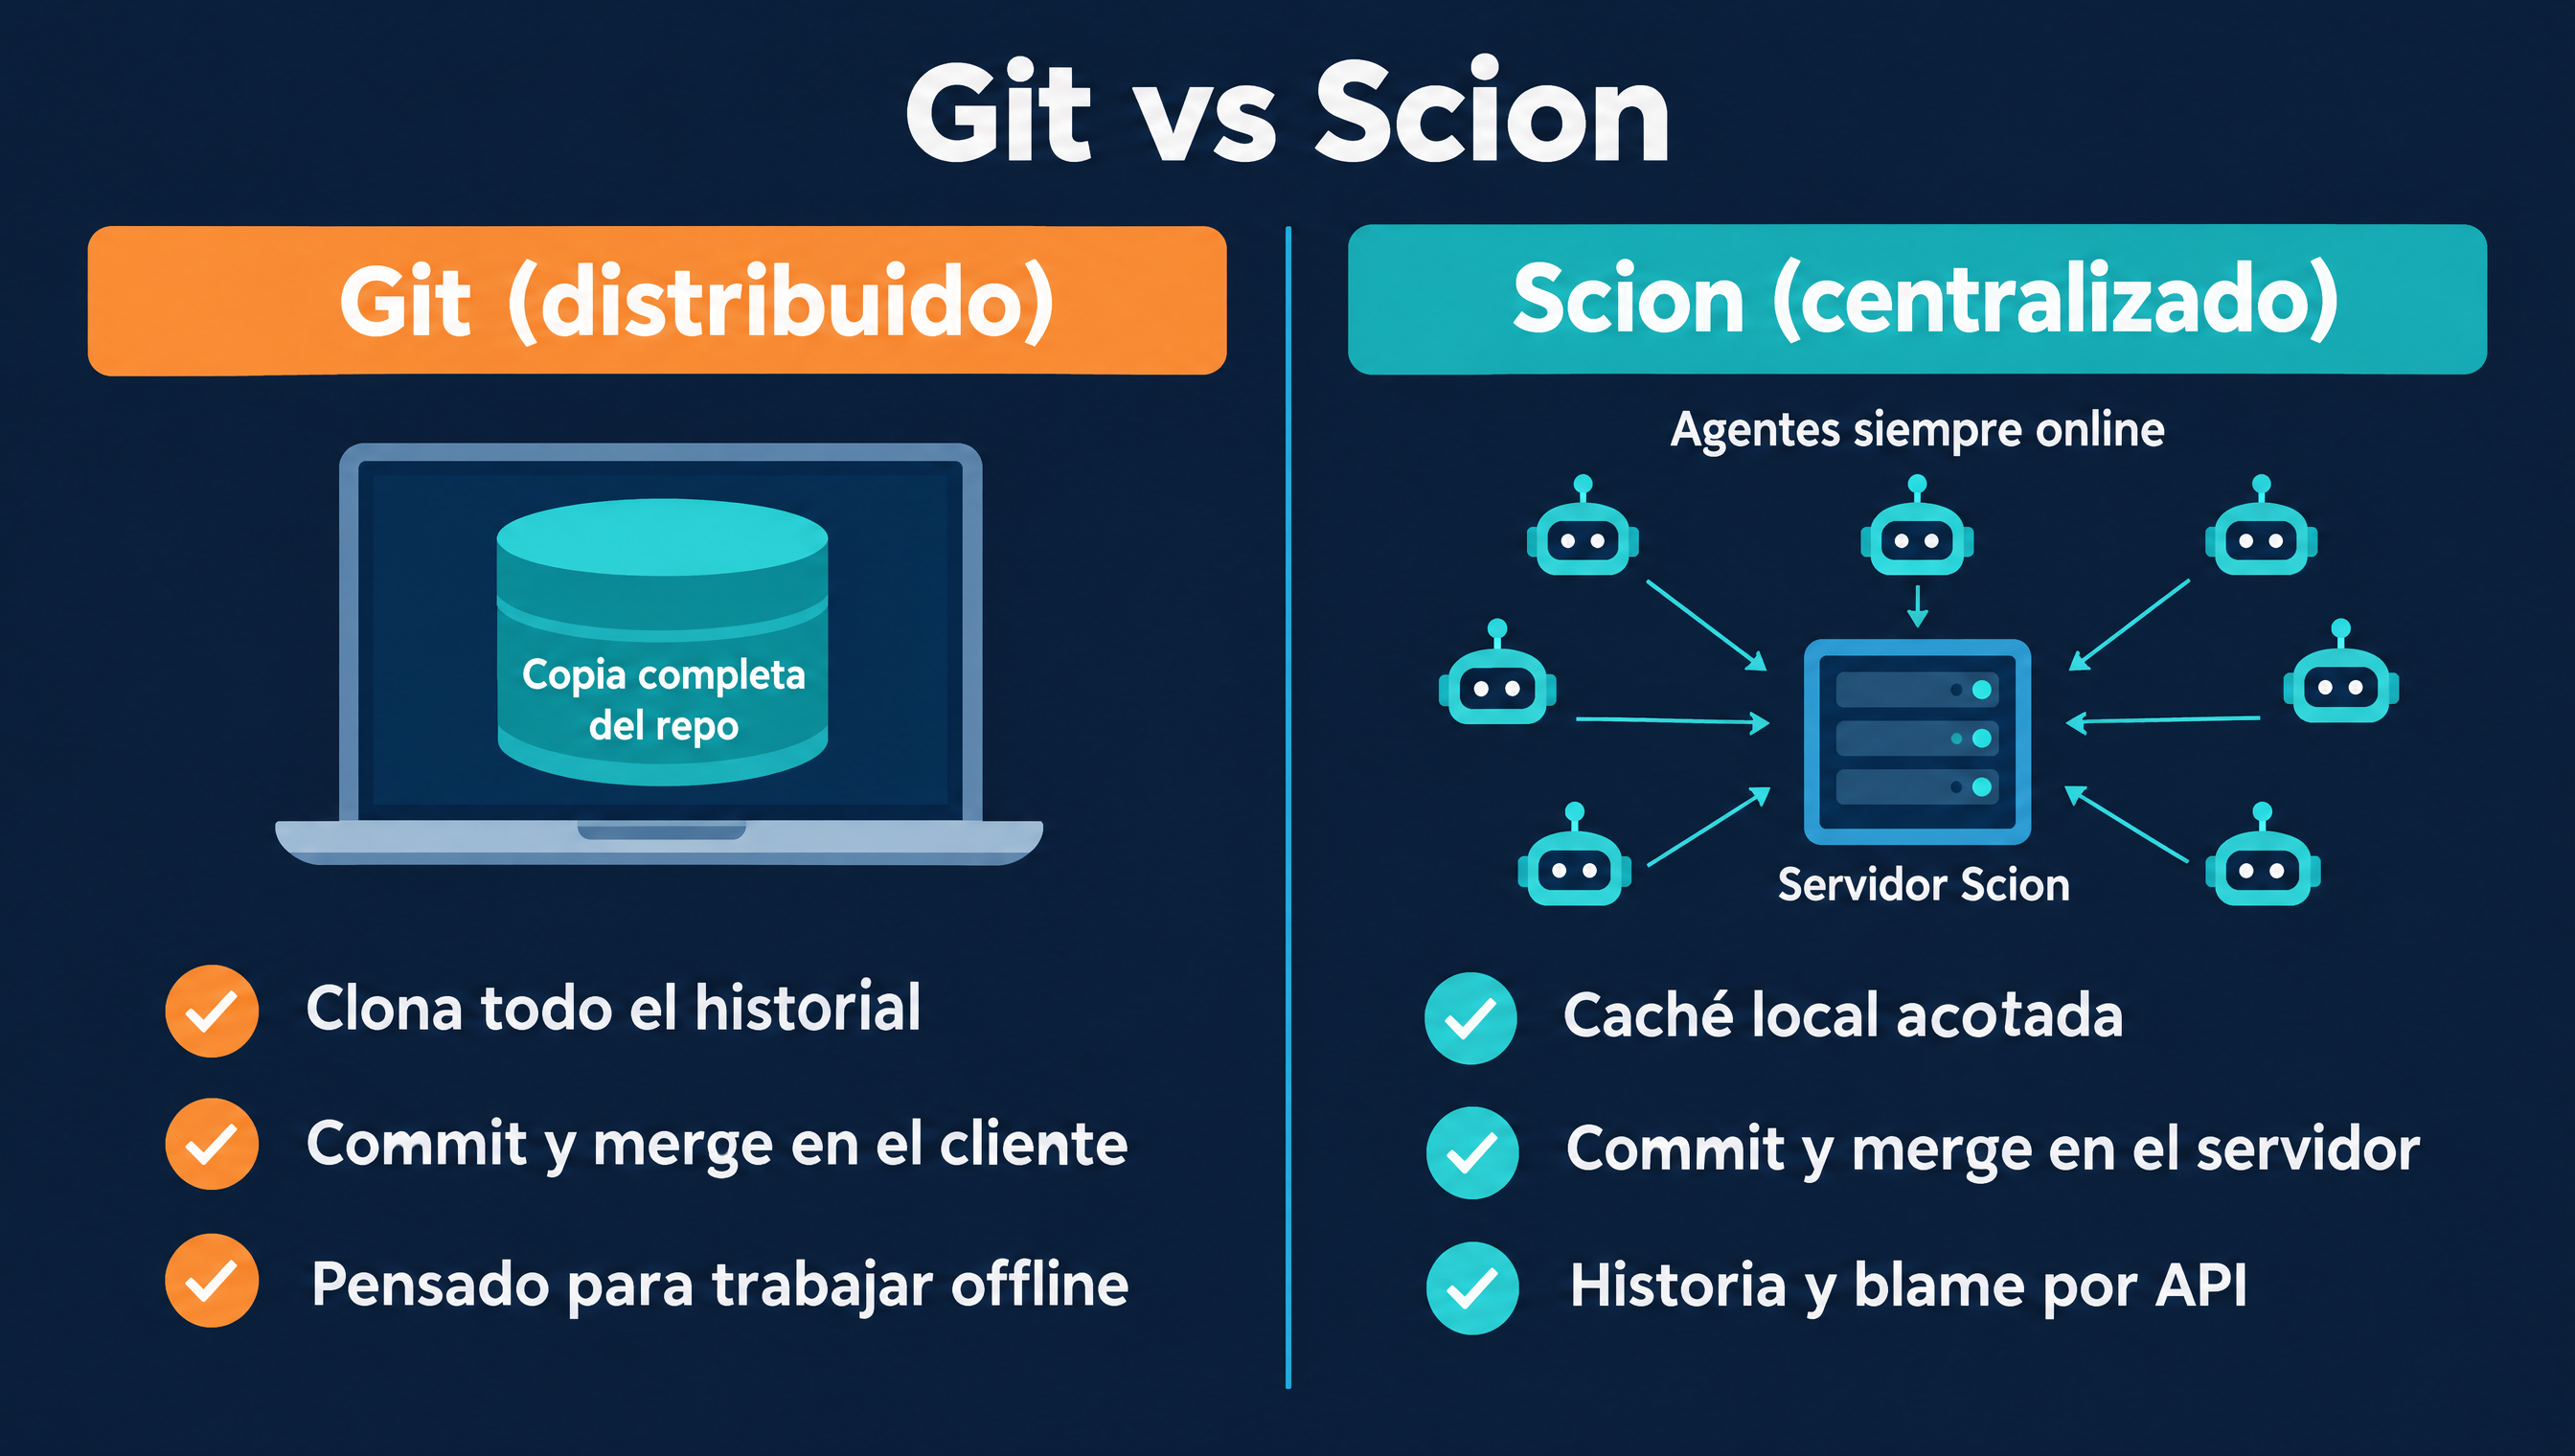
El post resume el diseño en seis principios. Vale la pena leerlos como un contraste directo con las suposiciones de Git:
- Los clientes siempre están conectados. En lugar de una copia completa offline, el cliente pide los datos bajo demanda. En palabras de Anthropic: "Git asume que los clientes trabajan offline y necesitan una copia completa del repositorio". Scion asume lo contrario.
- Asimetría cliente-servidor. El servidor calcula historial, blame, commits, merges y rebases. El cliente mantiene una caché local de objetos de tamaño acotado, coloca los archivos de trabajo en disco, vigila el sistema de archivos y ofrece la interfaz. Calcula poco y necesita muchos menos datos.
- Source control como servicio. Todas las consultas están expuestas por API. Muchos jobs de CI y herramientas internas —como los pipelines automáticos de bisect y revert— no necesitan ningún repositorio local: preguntan al servidor.
- Escalado horizontal. Los datos están distribuidos y cada componente escala por separado. No existe una copia completa del repositorio en ningún sitio, ni siquiera en el servidor. Tampoco hay packfiles, así que desaparece el mantenimiento del repositorio (
git gc, repacks y compañía). - Commits baratos, incrementales y sin bloqueos. Commits, rebases y merges ocurren en el servidor, así que no hay nada que hacer
push. El coste es proporcional al tamaño del cambio, no al del repositorio. Las ramas y etiquetas se desaconsejan salvomainy las ramas de release, porque todo estado global en el que todos los servidores deben ponerse de acuerdo es un problema de escalado. - Copias de trabajo opcionales y parciales. La CI puede pedir diffs y escribir cambios por API sin hacer checkout. Cuando sí hace falta, el checkout es sparse (solo los directorios pedidos) o virtualizado (los archivos se materializan cuando alguien los lee).
Si estos principios te recuerdan a Subversion o a Perforce, no eres el único: es la comparación que más se repitió en Hacker News y Slashdot. La diferencia es de escala y de cliente: Scion es centralizado como SVN, pero construido con las técnicas de los monorepos de Google y Meta y pensado para enjambres de agentes, no para personas.
Cómo funciona Scion por dentro
Changesets en lugar de árboles
En Git, un commit apunta a un árbol que describe el estado completo del repositorio en ese momento. En Scion, la unidad de trabajo es el changeset: una entrada en un write-ahead log que lista solo los archivos que cambiaron respecto a su primer padre, con punteros direccionados por contenido a blobs comprimidos.
Esto tiene varias consecuencias. Un changeset se crea en el servidor y queda disponible en todas partes al instante: no hay packfiles que generar, ni locks, ni coordinación entre servidores, ni referencias que mover al aceptarlo. Las referencias existen, pero mover una es una operación compare-and-swap sobre una única fila de Spanner, separada de la creación del changeset. Y elegir el primer padre como referencia es deliberado: en un flujo trunk-based, lo que la gente consulta casi siempre es el historial y el blame de la línea principal.
Datos derivados: blame e historial sin recorrer todo
Con solo changesets no puedes responder rápido a "¿quién tocó por última vez esta línea?". Scion calcula datos derivados a partir de ellos: blame por archivo, historial por ruta y skip lists sobre el grafo de commits para saltar rápido entre ancestros. Todos se calculan con un único mecanismo genérico y recursivo: el valor de un dato derivado para un changeset se obtiene a partir del valor de sus padres.
La ventaja es la extensibilidad. Añadir un tipo nuevo de dato derivado es sencillo, cada uno puede calcularse de forma anticipada o perezosa, y los internos pueden cambiar sin afectar a los clientes. Con el tiempo añadieron, por ejemplo, detección de copias e índices de búsqueda de archivos por ruta. Es una idea heredada de Mononoke, el servidor de Sapling, como reconoce la propia Anthropic.
Tres niveles de caché y una negociación al revés
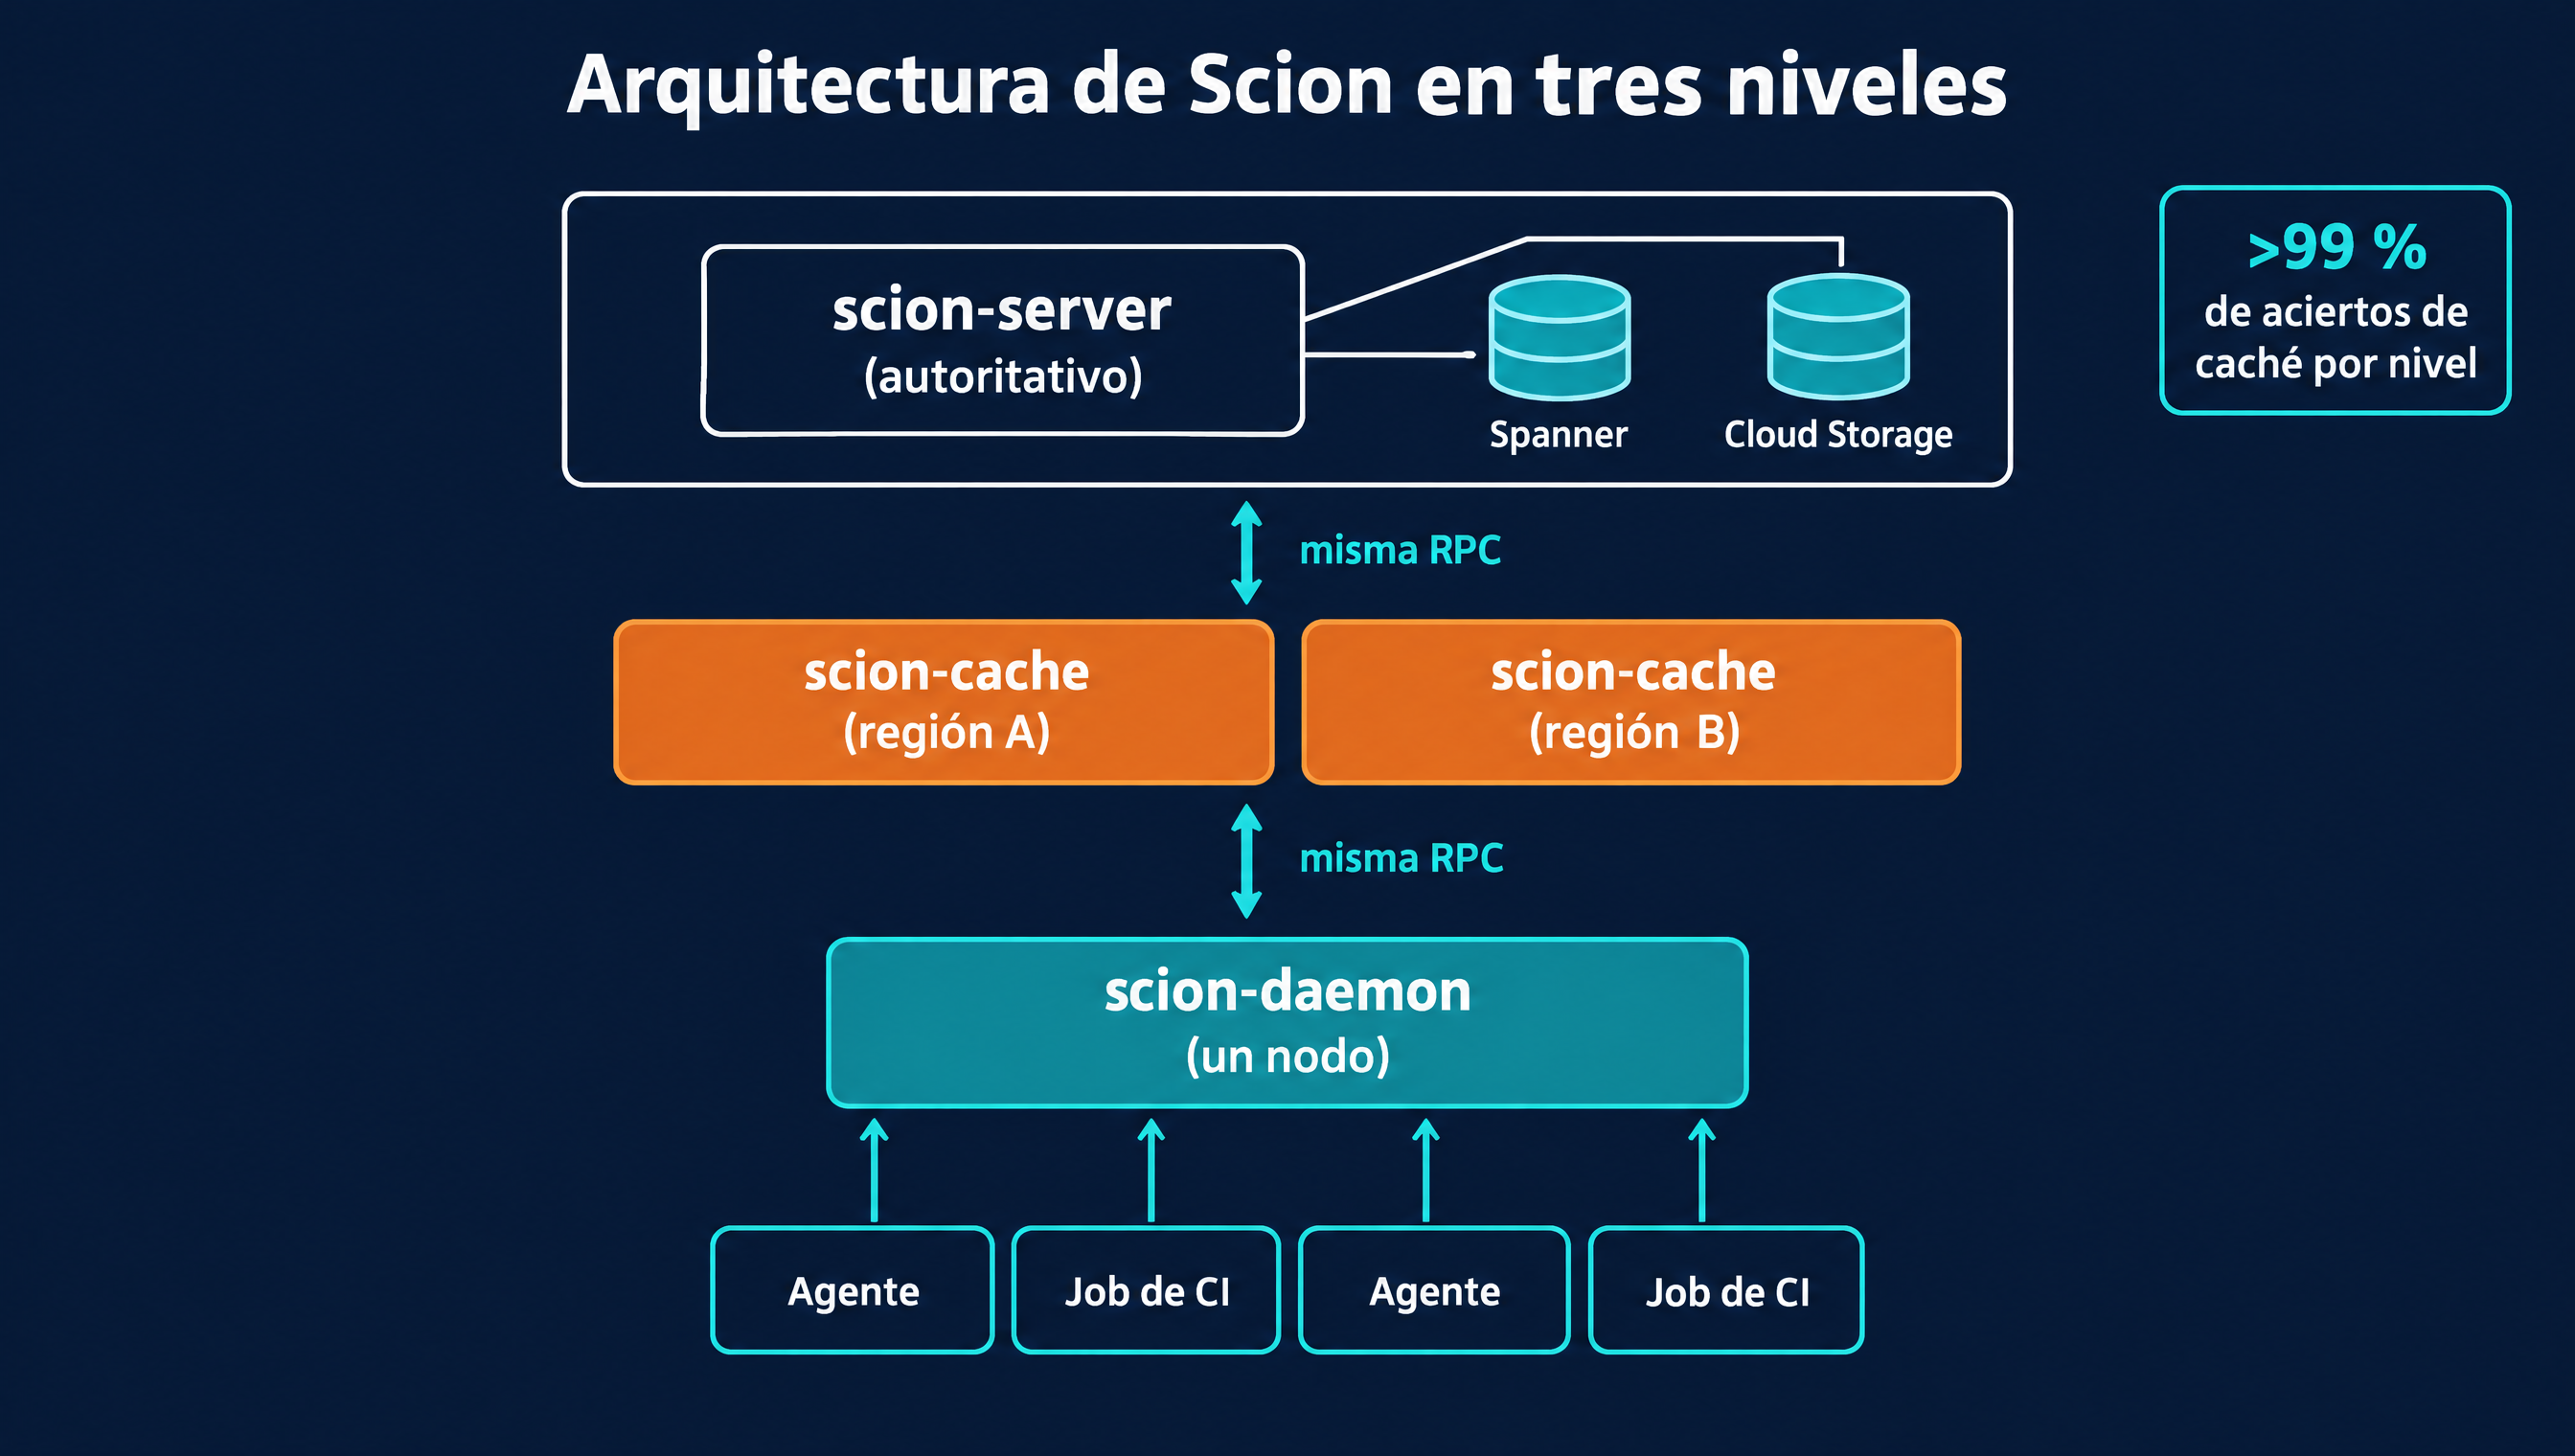
La flota se organiza en tres niveles que responden exactamente a las mismas RPC, así que el cliente no necesita conocer la topología:
- scion-daemon: uno por nodo; guarda los objetos que necesitan todos los jobs de esa máquina.
- scion-cache: regional; sirve objetos desde memoria.
- scion-server: el nivel autoritativo, que lee de Spanner o de almacenamiento en la nube.
Los niveles están estrictamente separados para aislar fallos: si una caché regional cae, no debe tumbar a los servidores de arriba con una avalancha de peticiones. Y como todo objeto es inmutable y está direccionado por contenido, cualquier caché puede responder sin coordinarse con nadie.
El detalle más elegante está en la negociación. En Git, el cliente le dice al servidor qué tiene y el servidor calcula qué falta y lo empaqueta en un packfile, potencialmente de varios gigas. En Scion es al revés: el cliente parte del árbol raíz, pide recursivamente los árboles que le faltan y después los blobs que le faltan. No hay un paquete gigante, las transferencias se pueden reanudar y los checkouts parciales o virtualizados no requieren ningún soporte especial: basta con no pedir los árboles que no interesan.
Los resultados que reporta Anthropic
- Más del 99 % de aciertos de caché en cada nivel, sin estado de larga duración.
- Una huella unas 200 veces menor en CPU y memoria que la antigua flota de mirrors de Git.
- Checkouts de CI e investigación que pasan de minutos a segundos (dos órdenes de magnitud).
- Una ganancia del 25 % de capacidad de CPU solo en CI.
- Cero mantenimiento del repositorio en clientes y cachés.
Son cifras autorreportadas que nadie puede verificar desde fuera, y así lo señalaron varios análisis. Aun así, el orden de magnitud tiene sentido: si dejas de copiar 25 GB a cada job y empiezas a servir solo los archivos que se leen desde una caché en el mismo nodo, el ahorro es enorme.
Claude construyendo su propio source control
La parte más llamativa del post no es técnica sino organizativa: siete personas construyeron Scion, Antique y media docena de sistemas relacionados, y migraron el monorepo en cinco meses mientras el volumen de merges se multiplicaba por diez. Anthropic reconoce que una migración así habría llevado años y muchos más ingenieros.
Algunos detalles concretos:
- La migración fue incremental. Al principio Scion solo respondía consultas de metadatos (ancestros, blame), para que la CI y las herramientas dejaran de mantener repositorios locales. El contenido de archivos y los checkouts llegaron después.
- Mythos reescribió la ingesta. Una instantánea interna temprana de Claude Mythos Preview —el modelo del que salió Claude Fable 5— reescribió el prototipo escrito a mano que importaba Git a Scion, sin más instrucciones. El resultado usaba 20 veces menos memoria y era 4 veces más rápido, respetando los invariantes implícitos de orden y estructuras de datos.
- Optimizaciones de experto. Claude encontró mejoras como un cambio algorítmico en una consulta de ancestros que no estaba usando un índice; según el equipo, a un experto le habría costado días o semanas.
- Todos los ingenieros del proyecto valoraron a Claude como mejor programador que ellos. Su papel pasó a ser el diseño del sistema, los trade-offs y, a menudo, decir "no" cuando un agente violaba una restricción central. Un ejemplo: sistemas que intentaban averiguar cuándo se fusionó un cambio recorriendo linealmente el log de commits, en lugar de preguntarle a la herramienta de revisión.
Cómo verificaron algo tan crítico
Un source control que pierde datos es una catástrofe, así que la verificación merece atención. El equipo combinó simulaciones herméticas de cada interacción no trivial con la infraestructura que habían visto, fuzzing, limitación de tasa sofisticada y revisión adversarial: un Claude intentando encontrar fallos en el trabajo de otro. Su conclusión es matizada: la revisión adversarial es muy eficaz, pero puede ser miope y empujar a sobreingeniería frente a riesgos hipotéticos, como validar en exceso las respuestas de un servicio interno de confianza.
En operación añadieron, además de las alertas tradicionales, instancias de Claude a las que llaman "superfans": una por componente (scion-daemon, scion-cache, la cola de merge de Antique…), con acceso a telemetría y logs, buscando anomalías sutiles que las alertas no capturan. El equipo afirma que Scion acabó siendo una de las bases de código mejor probadas con las que ha trabajado.
Revisión de código y merges a escala de agentes
Con 30.000 cambios al día, dos prácticas que damos por sentadas dejan de funcionar.
La primera es la cola de merge con bloqueo global: serializar cada cambio y probarlo contra la punta de main antes de fusionarlo. A ese ritmo, decenas de cambios aterrizan mientras los tests del primero todavía corren. Anthropic decidió no replicar ese bloqueo e invertir en pruebas automáticas después del merge y antes del despliegue. Los conflictos entre cambios concurrentes existen, pero Claude suele arreglarlos más rápido de lo que una persona tardaría en detectarlos. Es la misma lógica que hay detrás de las estrategias de despliegue como canary o blue-green y de los feature flags: aceptar que algo puede fallar después de integrarse y tener redes de seguridad entre main y producción.
La segunda es la revisión línea a línea. Antique puede expresar restricciones de aprobación semánticas: distinguir un cambio que solo toca comentarios de uno que modifica lógica sensible, para que las personas concentren la atención donde importa. En los cambios del propio Scion, el equipo revisa la intención de cada cambio más que cada línea. Scion también soporta control de acceso rico y permisos por directorio, para proteger código sensible sin renunciar a las ventajas del monorepo.
Aquí está la crítica más repetida en los foros: si nadie lee cada línea, ¿quién garantiza la calidad? La respuesta de Anthropic es que la calidad la sostienen los tests, las simulaciones y la revisión adversarial, no los ojos humanos sobre cada diff. Es una apuesta razonable para un equipo con esa cobertura de pruebas; para uno sin ella, copiar solo la parte de "revisar la intención" sería una receta para el desastre.
Scion vs Git: ¿deberías dejar Git?
No. Y lo dice la propia Anthropic: Scion no es un sustituto de Git para uso general. Sus ideas solo tienen sentido para monorepos enormes, con decenas de miles de ingenieros o grandes enjambres de agentes, y el presupuesto de tokens que Anthropic gasta internamente supera con creces lo que la mayoría de empresas invertiría. Además, Scion diverge tanto de Git que exige su propia revisión de código, su propio buscador y su propia CI, todo muy a medida. Por eso no lo va a publicar.
| Aspecto | Git | Scion |
|---|---|---|
| Modelo | Distribuido | Centralizado |
| Copia local | Repositorio completo (o parcial con trucos) | Caché acotada, checkout opcional |
| Dónde ocurre un commit o merge | En el cliente, luego push | En el servidor |
| Unidad de almacenamiento | Commit → árbol completo | Changeset con los archivos cambiados |
| Historial y blame | Calculados en local | Datos derivados servidos por API |
| Ramas | Baratas y omnipresentes | Desaconsejadas salvo main y releases |
| Trabajo offline | Sí | No |
| Mantenimiento | gc, repacks, packfiles | Ninguno en clientes y cachés |
| Disponibilidad | Cualquiera, open source | Solo interno en Anthropic |
Lo que Anthropic sí propone es llevar las mejores ideas a Git sin abandonar su modelo: arquitecturas de servidor que no imiten al cliente, APIs de servidor completas (idealmente estandarizadas entre forjas), nuevos protocolos de negociación y funciones sparse y shallow que se combinen bien. Dice que trabajará con GitHub, GitLab y la comunidad open source en esa dirección, y prevé que más equipos que usan herramientas de IA para programar choquen con límites parecidos en los próximos meses.
Qué puede aplicar hoy un equipo normal
Que no necesites Scion no significa que no haya lecciones útiles. Si tus agentes o tu CI pasan minutos clonando, Git ya trae herramientas que van en la misma dirección:
# Clon parcial: descarga commits y árboles, pero los blobs (contenido de archivos)
# solo cuando se necesitan. Es la versión "Git" del principio de Scion
# "pide los datos bajo demanda".
git clone --filter=blob:none --sparse https://github.com/mi-org/monorepo.git
cd monorepo

# Sparse checkout en modo cono: materializa solo los directorios que este
# agente o job va a tocar, como los checkouts parciales de Scion.
git sparse-checkout set servicios/pedidos libs/comunes

# Un worktree por agente: varios agentes trabajan en paralelo sobre el mismo
# repositorio sin pisarse y sin clonar N veces.
git worktree add ../agente-1 -b agente-1/refactor-pedidos
Tanto los clones parciales como git sparse-checkout están documentados en la referencia oficial de Git. Ten en cuenta el trade-off que también sufrió Anthropic: con clones parciales, las operaciones que recorren mucho historial, como un blame de un archivo movido varias veces, pueden volverse lentas porque tienen que pedir objetos al servidor sobre la marcha.
Más allá de los comandos, las ideas transferibles son estas:
- "Pregunta al servidor" antes que "clona todo". Muchas tareas de CI (¿qué archivos cambió este PR?, ¿quién es el dueño de este directorio?) se resuelven con la API de tu forja sin hacer checkout.
- Mide antes de optimizar. Si tus checkouts ya tardan segundos, este problema no es tuyo todavía.
- Refuerza las pruebas antes de relajar la revisión. El modelo de Anthropic funciona porque hay tests post-merge, simulaciones y despliegues progresivos. Las pruebas de contrato entre microservicios o los tests de integración con Testcontainers son el tipo de red que permite revisar intenciones en lugar de líneas.
- Clasifica los cambios por riesgo. La idea de Antique de aprobar distinto un cambio de comentarios que uno de lógica sensible se puede aproximar hoy con
CODEOWNERS, reglas de protección por ruta y etiquetas automáticas. - Pon a los agentes a vigilar, no solo a programar. Los "superfans" de Anthropic son una idea fácil de probar: un agente con acceso de solo lectura a métricas y logs de un componente, buscando anomalías.
Preguntas frecuentes
¿Anthropic dejó de usar Git?
En su monorepo principal, sí: entre mayo y octubre de 2026 lo migró a Scion, su sistema de control de versiones interno. Eso no significa que Anthropic considere Git obsoleto; la empresa dice que Git sigue siendo adecuado para la gran mayoría de repositorios y que Scion solo tiene sentido a una escala muy concreta.
¿Scion es open source o se puede usar fuera de Anthropic?
No. Anthropic no tiene previsto publicarlo, porque depende de herramientas internas propias (revisión de código con Antique, búsqueda y CI a medida) y no sería útil para la mayoría de organizaciones. En su lugar, quiere compartir las ideas con GitHub, GitLab y la comunidad de Git.
¿En qué se diferencia Scion de Git?
Git es distribuido: cada clon tiene el repositorio completo y los commits y merges se hacen en local. Scion es centralizado: el servidor calcula commits, merges, historial y blame, guarda cambios como changesets con solo los archivos modificados, y los clientes descargan bajo demanda lo que necesitan. A cambio, Scion no permite trabajar offline.
¿Qué es Antique de Anthropic?
Es la herramienta de revisión de código que Anthropic construyó junto a Scion y que reemplazó a los pull requests en su monorepo hacia julio de 2026. Permite definir reglas de aprobación semánticas, por ejemplo tratar distinto un cambio que solo toca comentarios de uno que modifica lógica sensible.
¿Por qué Anthropic hace 30.000 merges al día?
Porque gran parte del código lo escriben agentes basados en Claude que trabajan en paralelo. El volumen pasó de unos 2.500 merges diarios en mayo de 2026 a más de 30.000 en septiembre, con un pico de 30.401 el 9 de septiembre. Muchos críticos cuestionan si ese volumen es deseable; Anthropic lo presenta como la realidad que su infraestructura debía soportar.
¿Mi equipo necesita algo como Scion?
Casi con seguridad no. Si tus clones o checkouts de CI tardan minutos, empieza por clones parciales, sparse checkout, worktrees por agente y consultas a la API de tu forja. Scion responde a un problema de monorepos de decenas de gigas con decenas de millones de checkouts diarios.
Conclusión
Scion de Anthropic es, ante todo, un síntoma. Cuando los agentes de IA multiplican por diez el número de cambios en pocos meses, el cuello de botella deja de estar en escribir código y pasa a estar en integrarlo: control de versiones, revisión, CI y despliegue. Anthropic respondió volviendo, en cierto modo, al modelo centralizado que Git dejó atrás, pero con las técnicas de Piper y Sapling y con un cliente nuevo en mente: un agente que nunca se desconecta y que solo necesita unos pocos archivos de un repositorio de 100 GB.
Para la mayoría de equipos, la noticia no es "hay que dejar Git", sino un adelanto de las preguntas que llegarán a medida que los agentes escriban más código: ¿cuánto descarga cada job?, ¿qué revisan realmente las personas?, ¿qué red de pruebas permite confiar en cambios que nadie leyó línea a línea? Las respuestas de Anthropic son extremas porque su escala lo es, pero la dirección —más servidor, menos copia local, más pruebas automáticas y revisión centrada en la intención— es la que probablemente seguirán GitHub, GitLab y el propio Git en los próximos años.
Fuentes
- Redesigning source control at Anthropic — Anthropic Engineering
- Redesigning source control at Anthropic — Simon Willison
- Anthropic Builds Its Own Source Control After AI Agents Outgrow Git — DevOps.com
- Anthropic ditched Git for its own version control system because Claude is writing too much code — TechSpot
- Anthropic Reinvents Source Control As Claude Floods the World With Code — Slashdot
- Anthropic Scion: Why Anthropic Replaced Git for Agent-Scale Merges — Developers Digest
- Partial clone — documentación de Git
- git-sparse-checkout — documentación de Git


