
Service Mesh: gestionando la comunicación entre microservicios con Istio
Una organización con veinte microservicios en Java, Go y Node.js descubre pronto un problema que no está en ningún diagrama de arquitectura: cada equipo ha implementado sus propios reintentos, sus propios timeouts, su propia lógica de circuit breaking y su propia forma de generar trazas distribuidas. Un servicio en Java usa Resilience4j, otro en Go tiene su propio paquete interno, y un tercero en Node.js simplemente no reintenta nada. Cuando algo falla en producción, nadie puede responder con certeza a la pregunta más básica: ¿qué servicios se están comunicando con cuáles, con qué latencia y con qué tasa de error?
Este es el problema que resuelve un service mesh: sacar toda la lógica de comunicación entre servicios —reintentos, timeouts, circuit breaking, mTLS, métricas, trazas— del código de la aplicación y moverla a una capa de infraestructura común, uniforme para los veinte servicios sin importar en qué lenguaje estén escritos.
El problema de las llamadas este-oeste
En cualquier arquitectura de microservicios hay dos tipos de tráfico. El tráfico norte-sur es el que entra desde fuera del clúster: un cliente llamando a la API pública. Ese tráfico ya tiene una solución bien establecida — el API Gateway, del que hablamos en el artículo sobre Strangler Fig Pattern y que Spring Cloud Gateway implementa muy bien.
El tráfico este-oeste es distinto: son las llamadas entre microservicios dentro del clúster. El servicio de pedidos llama al de inventario, que llama al de precios, que llama al de descuentos. Este tráfico interno crece de forma cuadrática con el número de servicios, y es aquí donde las preguntas operativas se vuelven difíciles:
- Si el servicio de precios empieza a responder lento, ¿todos los que lo llaman tienen timeouts configurados? ¿Son consistentes entre sí?
- ¿El tráfico entre servicios va cifrado? ¿Cualquier pod dentro del clúster puede leer las peticiones en texto plano?
- Si quiero desplegar una nueva versión del servicio de descuentos y dirigirle solo el 5 % del tráfico, ¿cada equipo tiene que implementar esa lógica de canary a mano?
- Cuando una petición atraviesa seis servicios y falla en el quinto, ¿existe una traza que permita reconstruir ese camino completo?
Resolver esto a nivel de librería de aplicación —como hacen Resilience4j o Spring Cloud— funciona, pero obliga a cada servicio, en cada lenguaje, a implementar y mantener la misma lógica. Un service mesh mueve esa responsabilidad fuera del proceso de la aplicación.
El patrón sidecar
La idea central de un service mesh es el patrón sidecar: junto a cada instancia de un servicio se despliega un segundo contenedor —un proxy— que intercepta todo el tráfico de red entrante y saliente de ese servicio. La aplicación ya no habla directamente por la red con otros servicios; habla con su proxy local, y es el proxy quien se encarga de encontrar el destino, cifrar la conexión, aplicar reintentos y reportar métricas.
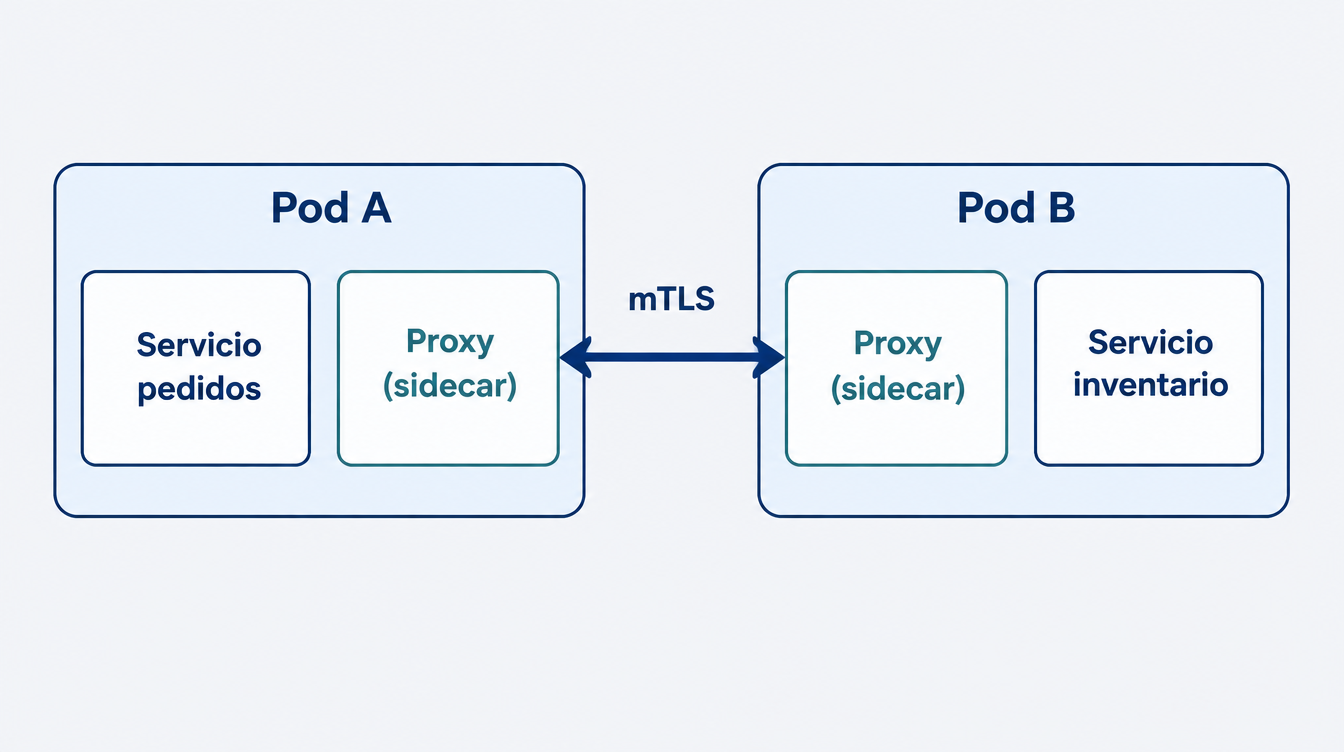
El servicio de pedidos ni siquiera sabe que existe cifrado, retries o circuit breaking: simplemente hace una petición HTTP a localhost o al nombre del servicio de inventario, y el sidecar se encarga de todo lo demás. Esto es lo que permite que el mesh funcione igual con un servicio en Java, uno en Python y uno en Rust: no requiere ninguna librería específica del lenguaje, solo intercepta tráfico de red.
En el ecosistema de Kubernetes, el proxy más usado como sidecar es Envoy, un proxy de alto rendimiento escrito en C++ originado en Lyft. Istio, Linkerd (con su propio proxy en Rust) y Consul Connect son las implementaciones de service mesh más extendidas; este artículo usa Istio como referencia porque es la más completa y la más adoptada.
Data plane y control plane
Un service mesh se divide conceptualmente en dos capas:
El data plane son todos los proxies sidecar desplegados junto a cada servicio. Son los que realmente mueven el tráfico, aplican las políticas de reintentos y cifran las conexiones. Es la capa que procesa cada petición real.
El control plane es el cerebro del mesh: el componente centralizado (istiod en Istio) que configura a todos los proxies, distribuye los certificados para mTLS, y agrega la telemetría que cada proxy reporta. El control plane no toca el tráfico de datos directamente; solo le dice a cada Envoy cómo comportarse.
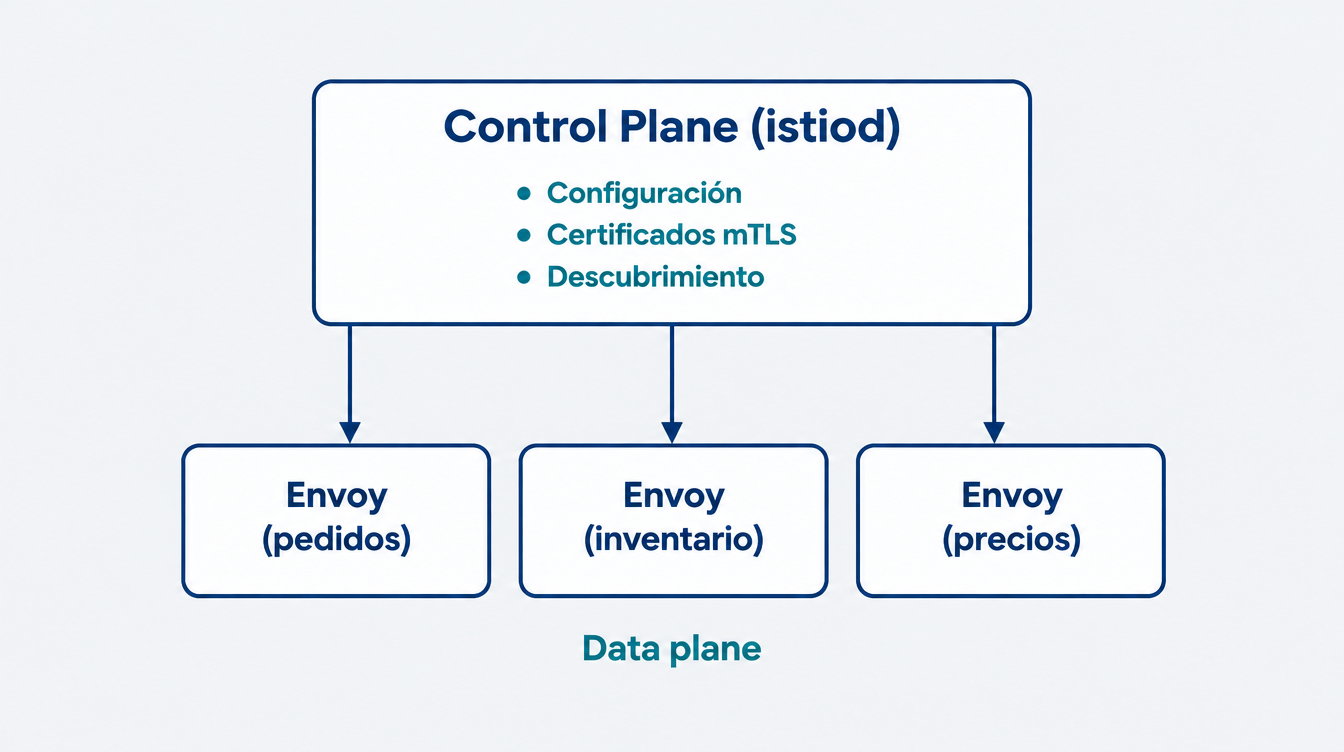
Esta separación es la que permite cambiar el comportamiento de todo el mesh —por ejemplo, rotar certificados o activar mTLS globalmente— sin tocar un solo pod de aplicación ni hacer un despliegue.
Inyección del sidecar
En Istio, la inyección del proxy sidecar en cada pod es automática si el namespace tiene la etiqueta correspondiente:
kubectl label namespace produccion istio-injection=enabled
A partir de ese momento, cualquier pod desplegado en ese namespace recibe automáticamente un contenedor Envoy adicional, sin que el manifiesto del Deployment necesite cambios:
apiVersion: apps/v1
kind: Deployment
metadata:
  name: servicio-inventario
  namespace: produccion
spec:
  replicas: 3
  selector:
    matchLabels:
      app: inventario
  template:
    metadata:
      labels:
        app: inventario
      # No hace falta declarar el sidecar aquí:
      # el webhook de inyección de Istio lo añade automáticamente
    spec:
      containers:
        - name: inventario
          image: registry.empresa.com/inventario:1.4.0
          ports:
            - containerPort: 8080
Tras el despliegue, kubectl get pods muestra 2/2 contenedores listos por pod: la aplicación y su Envoy. Esto es lo que hace que adoptar un mesh sea relativamente no invasivo para los equipos de desarrollo — no cambian su código, solo su plataforma de despliegue gana una capa nueva.
Gestión de tráfico: canary release declarativo
Uno de los beneficios más tangibles de un service mesh es poder controlar el tráfico entre versiones de un servicio de forma completamente declarativa, sin lógica de enrutamiento en el código. Istio expone dos recursos de Kubernetes para esto: DestinationRule, que define subconjuntos (versiones) de un servicio, y VirtualService, que define cómo se distribuye el tráfico entre ellos.
apiVersion: networking.istio.io/v1beta1
kind: DestinationRule
metadata:
  name: precios-destination
spec:
  host: servicio-precios
  subsets:
    - name: v1
      labels:
        version: v1
    - name: v2
      labels:
        version: v2
---
apiVersion: networking.istio.io/v1beta1
kind: VirtualService
metadata:
  name: precios-canary
spec:
  hosts:
    - servicio-precios
  http:
    - route:
        - destination:
            host: servicio-precios
            subset: v1
          weight: 95
        - destination:
            host: servicio-precios
            subset: v2
          weight: 5
Con esta configuración, el 5 % del tráfico interno hacia servicio-precios se dirige a la nueva versión mientras el 95 % restante sigue en la versión estable. Aumentar el porcentaje gradualmente —95/5, luego 80/20, luego 0/100— es tan simple como aplicar de nuevo el manifiesto con los pesos actualizados, sin ningún cambio de código ni redeploy de la aplicación.
También es posible enrutar según cabeceras, útil para pruebas internas antes de exponer una versión al tráfico general:
apiVersion: networking.istio.io/v1beta1
kind: VirtualService
metadata:
  name: precios-header-routing
spec:
  hosts:
    - servicio-precios
  http:
    - match:
        - headers:
            x-canary-user:
              exact: "qa-team"
      route:
        - destination:
            host: servicio-precios
            subset: v2
    - route:
        - destination:
            host: servicio-precios
            subset: v1
Resiliencia sin código: retries, timeouts y circuit breaking
Los mismos patrones de resiliencia que en el artículo sobre Resilience4j se implementan a nivel de código Java, un service mesh los ofrece como configuración de infraestructura, aplicable uniformemente a servicios en cualquier lenguaje:
apiVersion: networking.istio.io/v1beta1
kind: VirtualService
metadata:
  name: inventario-resiliencia
spec:
  hosts:
    - servicio-inventario
  http:
    - route:
        - destination:
            host: servicio-inventario
      timeout: 3s
      retries:
        attempts: 3
        perTryTimeout: 1s
        retryOn: 5xx,reset,connect-failure
---
apiVersion: networking.istio.io/v1beta1
kind: DestinationRule
metadata:
  name: inventario-circuit-breaker
spec:
  host: servicio-inventario
  trafficPolicy:
    connectionPool:
      http:
        http1MaxPendingRequests: 50
        maxRequestsPerConnection: 10
    outlierDetection:
      consecutive5xxErrors: 5
      interval: 10s
      baseEjectionTime: 30s
      maxEjectionPercent: 50
El bloque outlierDetection implementa circuit breaking a nivel de infraestructura: si una instancia del servicio de inventario responde con 5 errores 5xx consecutivos, el proxy la expulsa del pool de destinos durante 30 segundos, sin que ningún desarrollador haya escrito una sola línea de código de circuit breaker. Esto es particularmente valioso en organizaciones con stacks poliglotas, donde mantener Resilience4j en Java, un breaker equivalente en Go y otro en Node.js de forma consistente es un esfuerzo real de mantenimiento.
Seguridad: mTLS automático entre servicios
Por defecto, el tráfico entre pods dentro de un clúster de Kubernetes viaja sin cifrar. Cualquiera con acceso a la red del clúster —un pod comprometido, una herramienta de debugging mal configurada— puede interceptar esas peticiones. Istio resuelve esto habilitando mTLS (mutual TLS) automáticamente entre todos los sidecars, sin que la aplicación necesite gestionar certificados:
apiVersion: security.istio.io/v1beta1
kind: PeerAuthentication
metadata:
  name: default
  namespace: produccion
spec:
  mtls:
    mode: STRICT
Con mode: STRICT, cada Envoy exige que toda conexión entrante esté autenticada con un certificado válido emitido por el control plane. El control plane rota estos certificados automáticamente cada pocas horas, sin intervención manual y sin downtime. La aplicación sigue hablando en texto plano con su propio sidecar local (el tráfico nunca sale del pod sin cifrar); es el segmento entre pods el que queda protegido de forma transparente.
Esto también habilita políticas de autorización de grano fino, como restringir qué servicios pueden llamar a cuáles:
apiVersion: security.istio.io/v1beta1
kind: AuthorizationPolicy
metadata:
  name: solo-pedidos-llama-inventario
  namespace: produccion
spec:
  selector:
    matchLabels:
      app: inventario
  action: ALLOW
  rules:
    - from:
        - source:
            principals: ["cluster.local/ns/produccion/sa/pedidos-sa"]
      to:
        - operation:
            methods: ["GET", "POST"]
Esta política deniega por defecto cualquier llamada al servicio de inventario que no provenga de la identidad de servicio pedidos-sa, implementando un modelo de zero trust dentro del clúster: ningún servicio confía en otro solo por estar en la misma red.
Observabilidad uniforme
Como todo el tráfico este-oeste pasa por los sidecars, el mesh puede generar automáticamente métricas y trazas consistentes para cada servicio, sin que cada equipo tenga que instrumentar su código con un cliente de Prometheus o de OpenTelemetry. Cada Envoy expone métricas estándar —tasa de peticiones, latencia p50/p90/p99, tasa de error— que se agregan en Prometheus y se visualizan en dashboards como Kiali o Grafana.
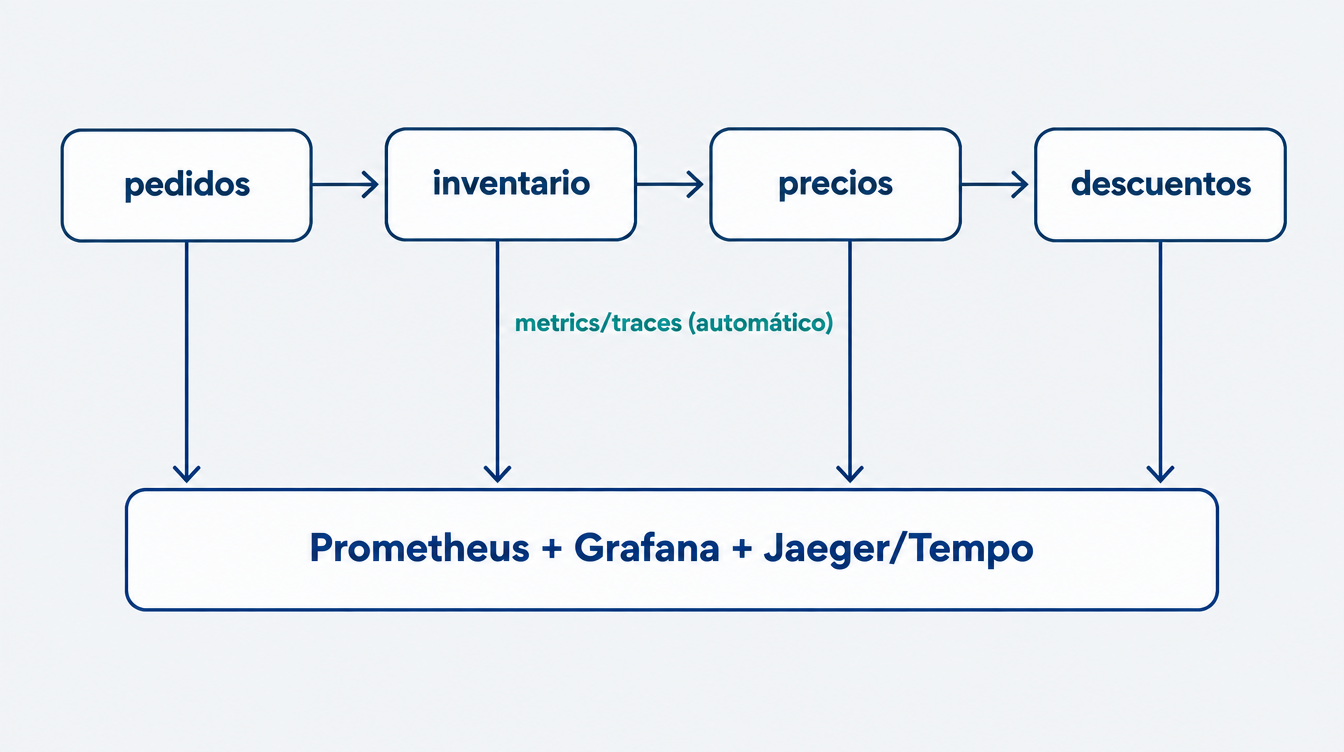
Estas métricas son las mismas cuatro señales doradas (golden signals) que ya se describieron en el artículo de observabilidad en microservicios: latencia, tráfico, errores y saturación. Con un mesh, aparecen de forma consistente para los veinte servicios sin que cada uno tenga que exponerlas manualmente — el proxy las genera por el simple hecho de interceptar el tráfico.
La limitación importante: el mesh ve la comunicación entre servicios, no lo que ocurre dentro de cada uno. Una traza distribuida completa —incluyendo los spans internos de una función que hace tres queries SQL— sigue requiriendo instrumentación de aplicación con OpenTelemetry. El mesh aporta los spans de red; la aplicación aporta el detalle interno.
Service mesh vs. API Gateway
Es un error común pensar que un service mesh reemplaza al API Gateway, o viceversa. Resuelven problemas en capas distintas del tráfico:
| API Gateway | Service Mesh | |
|---|---|---|
| Tráfico que gestiona | Norte-sur (cliente → clúster) | Este-oeste (servicio → servicio) |
| Preocupaciones típicas | Autenticación de cliente, rate limiting público, agregación de APIs | mTLS interno, retries, circuit breaking, tracing |
| Dónde vive | En el borde del clúster | Junto a cada pod (sidecar) |
| Ejemplo | Spring Cloud Gateway, Kong | Istio, Linkerd |
En arquitecturas maduras, ambos coexisten: el API Gateway es la puerta de entrada única para el tráfico externo, y una vez dentro del clúster, el service mesh gestiona cómo esos veinte servicios se comunican entre sí.
El coste de adoptar un mesh
Un service mesh no es gratis. Introduce costes reales que conviene sopesar antes de adoptarlo:
Latencia adicional. Cada petición ahora atraviesa dos proxies Envoy —el del origen y el del destino— además del servicio real. En la práctica esto añade entre 1 y 5 milisegundos por salto, que se acumulan en cadenas de llamadas largas.
Complejidad operativa. El control plane es un componente crítico más que operar, actualizar y monitorizar. Un fallo en istiod no tira el tráfico existente (los Envoy siguen funcionando con la última configuración que recibieron), pero sí impide desplegar cambios de configuración hasta que se recupere.
Consumo de recursos. Cada sidecar consume CPU y memoria propios. En un clúster con cientos de pods, el overhead agregado de todos los sidecars es una fracción no despreciable de la capacidad total del clúster.
Curva de aprendizaje. VirtualService, DestinationRule, PeerAuthentication y AuthorizationPolicy son conceptos nuevos que el equipo de plataforma necesita dominar, y que pueden interactuar de formas no siempre evidentes cuando hay varias políticas aplicadas al mismo servicio.
Cuándo tiene sentido y cuándo no
Un service mesh aporta más valor cuanto mayor es el número de servicios y más heterogéneo es el stack tecnológico. Con cinco microservicios, todos en Java con Spring Cloud, la resiliencia y la observabilidad a nivel de librería —como se describe en los artículos de Resilience4j y Spring Cloud Gateway— probablemente son suficientes y más simples de operar.
El mesh empieza a justificarse cuando aparecen algunas de estas señales: decenas de servicios en múltiples lenguajes, requisitos de seguridad que exigen mTLS entre todo el tráfico interno, necesidad de canary releases frecuentes y controlados, o un equipo de plataforma dedicado que puede asumir la operación del control plane. Si ninguna de estas señales está presente, añadir un mesh suele ser complejidad prematura: resuelve problemas que la organización todavía no tiene, a cambio de latencia y superficie operativa que sí tiene desde el primer día.
Alternativas: Linkerd y el modo ambient de Istio
Linkerd es una alternativa a Istio con un objetivo declarado de simplicidad: su proxy, escrito en Rust, es más ligero que Envoy, y su superficie de configuración es deliberadamente más pequeña. Para equipos que solo necesitan mTLS, métricas básicas y retries simples, Linkerd suele ser más fácil de operar que Istio, a cambio de menos funcionalidades avanzadas de enrutamiento.
Istio también ofrece desde hace un tiempo un modo ambient, que elimina el contenedor sidecar por pod y mueve la interceptación de tráfico a un proxy compartido por nodo (usando eBPF), reduciendo el overhead de recursos y la complejidad de tener dos contenedores por pod. Es una respuesta directa a una de las críticas más comunes al modelo sidecar tradicional, aunque con un conjunto de funcionalidades todavía algo más limitado que el modo con sidecar completo.
Conclusión
Un service mesh traslada la lógica de comunicación entre microservicios —reintentos, timeouts, circuit breaking, cifrado, observabilidad— desde el código de cada aplicación hacia una capa de infraestructura uniforme, implementada con proxies sidecar que interceptan el tráfico de red sin que el servicio lo note. Esto resuelve un problema real en organizaciones con muchos servicios y stacks heterogéneos: la inconsistencia entre cómo cada equipo implementa la resiliencia y la seguridad de sus llamadas.
No es, sin embargo, una capa que toda arquitectura de microservicios necesite desde el primer día. El coste en latencia, recursos y complejidad operativa es real, y solo se justifica cuando el número de servicios y la heterogeneidad tecnológica hacen que mantener esa lógica a nivel de librería —como con Resilience4j o Spring Cloud— se vuelva más costoso que operar un control plane centralizado. Como con casi cualquier decisión de arquitectura, la pregunta no es si un service mesh es una buena idea en abstracto, sino si el problema que resuelve es ya el problema que tiene tu sistema.